游戏场景生成与编辑
从一句需求到一个能走进去的世界:构成要素、规格表、程序化布局与引擎落地。
- 知识:理解场景的五个构成要素(地形、建筑、道具、光照、氛围)与三个可用性评价维度(视觉统一、玩法动线、性能预算);理解程序化生成(噪声地形、波函数坍缩、泊松盘布局)的直觉原理。
- 能力:能用大语言模型把自然语言需求转写成一份可校验的场景规格表(JSON);能按管线生成天空盒、地形、建筑与道具资产;能把资产导入引擎并完成比例、轴向、Pivot、面数的导出前检查。
- 素质:建立"结构化需求先于生成"的工程习惯;理解场景设计中的文化准确性与文化挪用问题,尊重考据来源与团队劳动分工。
小舟第一次打开引擎,把昨天生成好的那座"江边楼台"拖进场景视图——结果它像一块巨型广告牌横躺在半空中,比远山还大十倍,还是侧着倒下去的。他反复缩放、旋转、拖动,花了四十分钟才让它"勉强站直",而旁边的扁舟只有指甲盖大小。小月看着屏幕说了一句本章要回答的全部问题:"我们是不是从一开始就没说清楚,这个场景到底长什么样?"
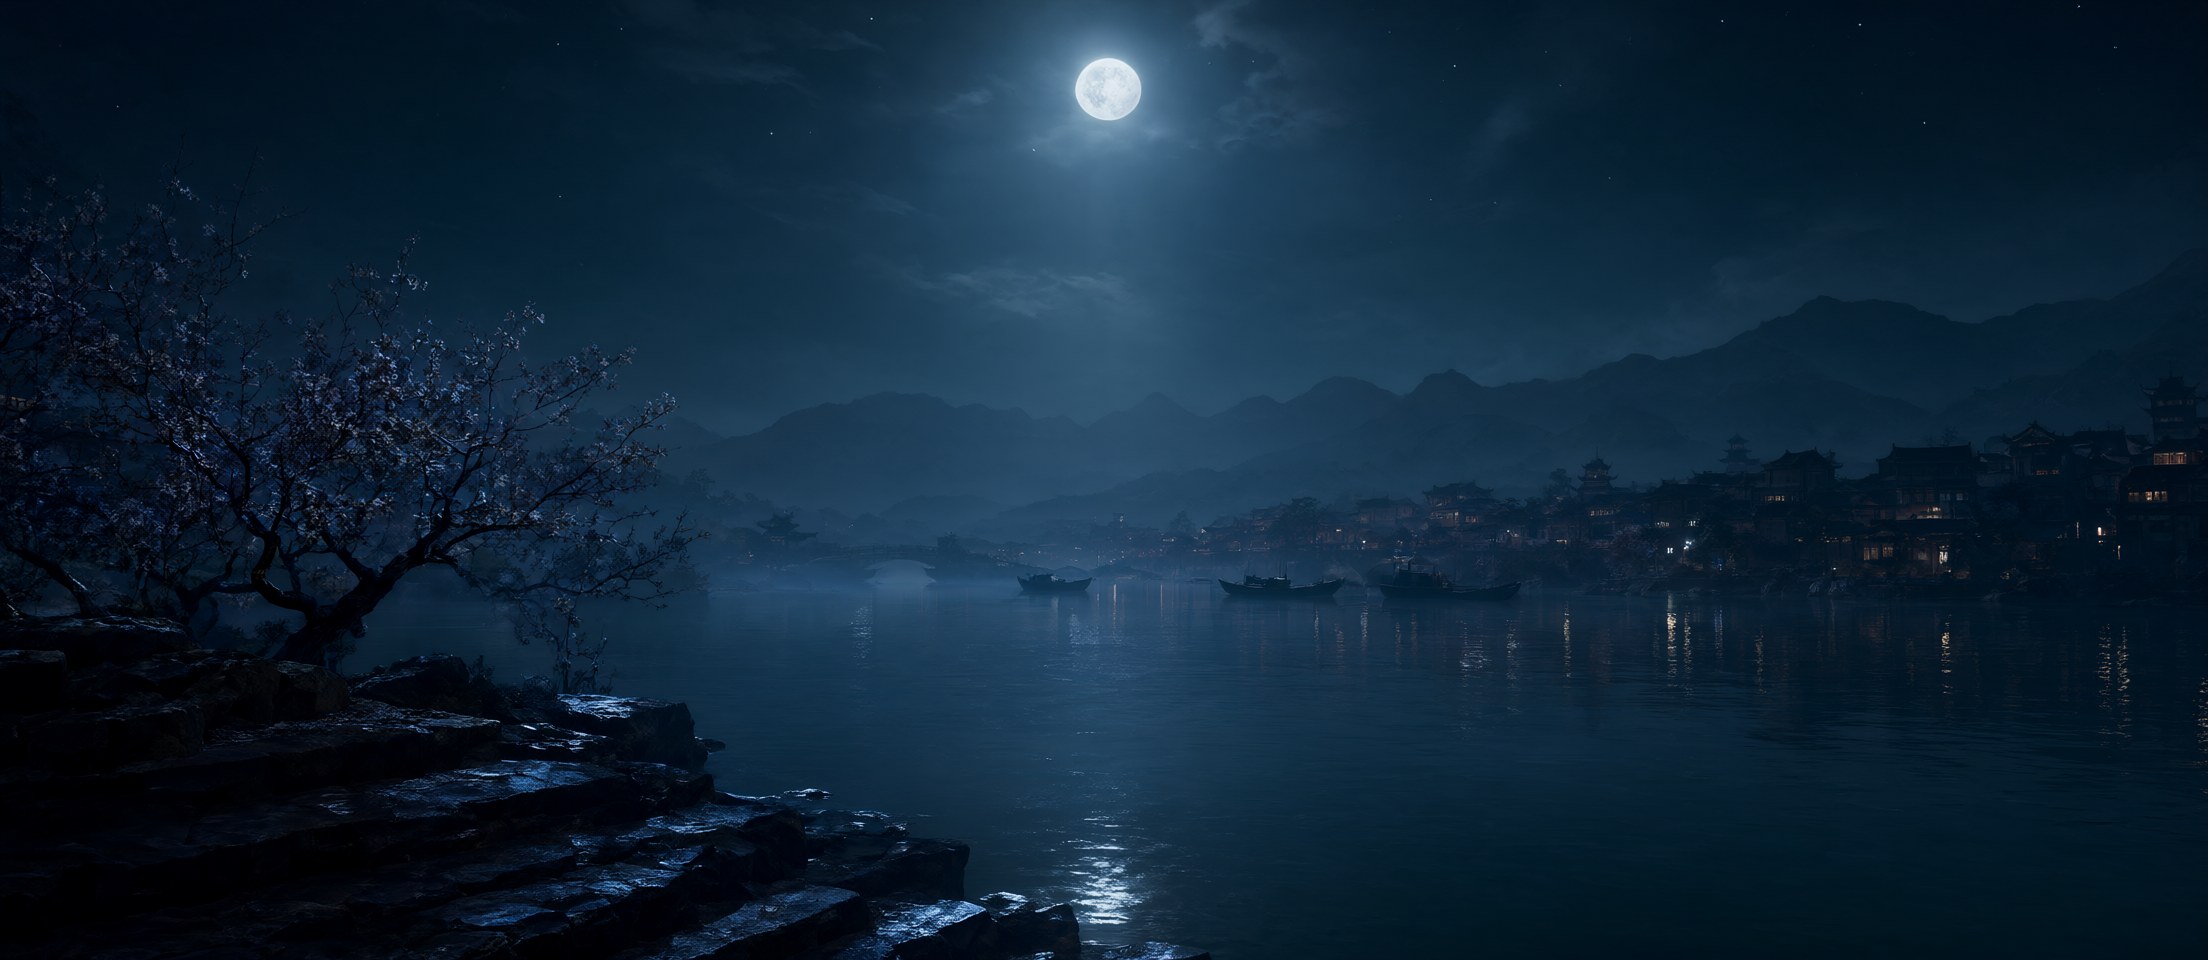
这句话点破了一个常见误会:很多人以为"场景生成"就是"让 AI 画一个背景"。不是的。一个能走进去、能跑的场景(scene),本质是一份被严格约定过的工程文件——它规定了有什么东西、放在哪、多大、用什么材质、站在哪儿能看到什么、跑起来要花多少性能。本章要回答三个问题:第一,一个场景由哪些要素构成,我们凭什么说它"好用"?第二,怎么把一句自然语言需求,变成机器和人都看得懂的规格表?第三,这些资产怎么真正落进引擎,而不是落进"打不开的文件夹"?顺着这三问,小舟会为《春江花月夜》短片搭出"夜江场景"的初稿——这也是本章的作业。
本章不看形状、不看动作,而是看「一个能走进去的空间」。它由四族技术接力完成,各管一段路:
- ① 大语言模型(7.3)= 结构化:把一句话需求翻译成场景规格表与资产清单
- ② 程序化生成(7.4)= 算法:用噪声、规则与采样「摆」出地形与物体散布
- ③ AI 资产生成(7.5)= 生成:天空盒、建筑、道具、材质(复用第 4 章的能力)
- ④ 引擎工程(7.6)= 落地:导入、比例与轴向检查、性能预算
前三族的任务是「把它造出来」,第四族是「让它能用」。多数翻车不在前三族,而在第四族——本章失败诊所里最贵的那一堂课(111 倍面数),就发生在这里。
7.1场景的五块拼图:地形、建筑、道具、光照、氛围
先建立一个总印象。把场景想成一台话剧的舞台:演员走的地板是地形,两侧的布景和后墙是建筑,台上摆的桌椅茶杯是道具,头顶那几盏灯是光照,而观众感到的"闷热""清冷""雨夜感"是氛围。少了任何一块,舞台都会露怯:地板缺了演员就悬空,灯缺了所有人都像纸片,氛围缺了整个画面会像没上色的线稿。
为什么要专门"拆成五块"来讲?因为 AI 工具是按资产类型分工的。天空盒生成器只擅长生成 360° 的环境图;三维生成器只知道"我拿到了一个物体的描述";材质工具输出的是贴图,不是几何。你不先把需求拆成"我到底要哪几类资产",就会拿着一个工具去要它给不出的东西——这是初学者最常见的浪费。第 1 章讲过的"提示词四要素"里,输出格式是最容易被忽略的一环;在场景任务里,"输出格式"就具体成了"输出的是不是这一类资产"。
下面逐块说明,并且每一块都给出"A 类工具缺口"——也就是 AI 最不擅长的那一小段,这正是你未来最值钱的手艺所在。
地形:场景的"地基"
地形(terrain)负责回答"脚踩在哪里、视线在哪里被挡住"。它包含两部分:高度场(地面起伏,通常用一张灰度图表示"每个点多高")和地表材质(草地、沙石、泥土的分布)。水面比较特殊,它既像地形(有高度、反射天空)又像道具(有波纹、有倒影),工程上一般单独处理,本章在 7.5 节专门讲。
生活类比:地形就是房子的地面平整度——地不平,家具怎么摆都别扭。课程情境:小舟的"夜江"里,地形不能是"一座山加一片平地",而要有一条从远山切到江岸的缓坡,让镜头从岸边推向江心时有自然的高差。AI 工具缺口:现成的文生三维工具只生成"一个物体",不生成"一片几平方公里的地形";地形必须靠程序化算法(7.4 节)或地形编辑工具生成。
建筑:画面的"骨架"
建筑(architecture)承担两个职责:一是体量——在远景里提供剪影和层次,让画面有"远近";二是形制——在近景里提供文化信息,让观众一眼认出"这是哪里的、哪个年代的"。第二点在后文思政部分会重点展开,因为它最容易出错。
生活类比:建筑像一幅画的构图骨架,它先于细节存在。课程情境:小江希望"楼台"出现在画面右三分之一处、半掩在柳树后——这不是美术偏好,而是规格:位置 (x, y, z)、朝向角、高度、占地范围,都可以写成数字写进清单里。
道具:故事的"标点符号"
道具(props)是场景里那些"可以被拿走、被使用、被特写"的小物件:一盏灯、一条船、一张琴、一摞书。它们体量小,但对叙事极其关键——道具是导演用来提示观众的标点:逗号、顿号、感叹号。
课程情境:《春江花月夜》里的"扁舟"就是核心道具。它小,但它是"人"的替身——船停在水上,观众就会自动补上"有人在这里看月亮"。这类"小而不重要"的资产,恰恰是 AI 生成器最擅长、单价最低的一类,也是最适合练手的起点。
光照:决定"像不像"的一半
光照(lighting)包含三个可调的东西:光源(太阳、月亮、灯)、方向与强度、以及全局光照设置(环境光从哪里来、阴影怎么衰减)。一个被反复验证的经验是:同一个模型,换一套光照,观感差距可以大于换一个模型。这也是为什么很多看起来"很高级"的场景,其实模型面数并不高。
课程情境:夜江场景的主光源只能是月亮。这意味着光的方向要统一(所有景物的受光面朝同一侧)、强度要压得低、色温要偏冷,而楼台窗内的一点暖光成为画面里唯一的暖色——这个"冷暖对撞"就是全片的气氛支点。
氛围:最便宜、也最容易做砸的一层
氛围(atmosphere)是天空、雾、色调映射与粒子(水汽、飞萤、落花)的总和。它最便宜——一个天空盒加一层雾就能让画面"换季";也最容易做砸——因为它是全局层:改一次雾的浓度,所有资产的颜色都要重新对一遍。
生活类比:氛围像给照片加的那层统一滤镜;滤镜能让同一个房间 morning 和 midnight 判若两地。课程情境:如果天空盒是冷蓝、雾是中性灰,而楼台却是暖黄、扁舟是青绿,那台上所有东西都在"各自发光",观众的第一反应是"假"。所以本书建议一条硬规矩:先定氛围,再生成资产,并把色板写进清单。
| 要素 | 回答什么问题 | 典型资产 | AI 可用的手段 | 出错信号 |
|---|---|---|---|---|
| 地形 | 脚踩在哪里、视线被什么挡住 | 高度场、地表材质、河床 | 程序化噪声生成 / 地形编辑工具雕刻 | 地面像塑料布一样平;坡度走不上去 |
| 建筑 | 剪影与层次从哪里来、这是哪里 | 楼台、院墙、桥梁、牌坊 | 文生三维 / 图生三维;参考图 + 多视角质检 | 形制混搭、比例失真、悬空或陷地 |
| 道具 | 故事用什么标点提示观众 | 扁舟、灯、琴、书案、樽 | 文生三维(小物件成功率最高) | 数量太多、满地散落、没有叙事重点 |
| 光照 | 光从哪来、明暗关系对不对 | 方向光、点光、环境光探针 | 引擎内手调 + 天空盒提供环境光 | 多处高光冲突;夜景却有白天的亮度 |
| 氛围 | 这是什么时候、什么天气、什么心情 | 天空盒、雾、色调映射、粒子 | 文生天空盒(360° 等距柱状图) | 天空与地面冷暖打架;雾把远景糊死 |
为什么"看起来很小的一步操作"会在场景里造成灾难?答案藏在场景的组织方式里:引擎里的场景不是一张平面的清单,而是一棵树(层级,hierarchy)。每个物体是一个节点,节点之间可以建立父子关系:把"灯笼"挂在"船"下面,灯笼就成了船的子节点。
父子关系带来一个极强的性质:子节点的最终位置 = 父节点变换 × 子节点自身变换。用矩阵写出来就是:
这个性质一半是祝福,一半是诅咒。祝福:做一艘会动的船,只要移动"船"这个父节点,船上的桨、灯、篷全都会跟着动,不用逐个改。诅咒:如果你把整个场景的资产都堆在一个父节点下,而这个父节点自己带着一个"未应用"的缩放(比如 0.01),那么屏幕上一切正常,导出后所有资产都会变成原来的百分之一——这正是小舟遇到问题的技术根源之一。
还有一个与它相关、但更难看见的概念:Pivot(轴心点),也就是"这个物体的原点在哪、旋转围绕哪个点转"。Pivot 不显示在画面上,却决定了放置的手感:一扇门的 Pivot 应该在门轴上,如果它在模型的几何中心,那么你旋转它时门会绕着"腰"转,而不是绕着"合页"转——这类问题在渲染截图里完全看不出来,只有在场景里操作时才会暴露。7.6 节会给出一份检查表专门处理它们。
地形给"地",建筑给"形",道具给"事",光照给"真",氛围给"情"。做场景卡壳时,先问自己:我现在缺的是哪一块?——大多数"看起来不对"的场景,问题出在光照和氛围,而不是模型本身。
7.2场景好不好用:三个评价维度
"好看"是一个无法验收的词。工程上必须把它拆成可检查的指标,才谈得上改进。场景的可用性可以拆成三个维度,它们互相拉扯,构成一个经典的"不可能三角":视觉统一、玩法动线、性能预算——你很难同时把三个都拉满,成熟的做法是"明确谁优先、谁让步"。
维度一:视觉统一(风格一致 + 构图合理)
视觉统一说的是:场景里的所有东西,看起来是不是出自同一个世界。它包含内容与形式两层——风格(写实/水墨/低多边形/像素)、比例(人的身高与门的高度是否匹配)、色彩(是否共用一套色板)、细节密度(远处的石头和近处的石头精细程度是否合理)。
要诚实说明一件事:截至本书编写时,检索范围内并没有见到针对"AI 场景风格统一性"的公认量化标准。行业里更常见的做法是用工程手段替代标准:例如天空盒生成工具 Skybox AI 提供 30 余种风格包(Style Pack)预设,让同一套场景的天空、光照保持一致;三维生成侧的 Seed3D 2.0 则通过统一的 PBR 生成模型来减少多步骤之间的"级联误差"(每一步都偏一点,最后整体跑偏)。
对课程作业,本书给出一套可操作的"土办法",比追求量化标准更管用:一份参考图集(3–5 张)+ 一个色板文件 + 一套材质命名规范。所有资产生成前先过一遍参考图集,生成后对照色板看一眼——统一性靠"减少随机",不靠"事后调色"。
维度二:玩法动线(可通行、看得懂、走得通)
场景不只是被看的,还是被"走"的。即使你的作品是短片而不是游戏,动线(玩家/镜头在空间中的移动路径)也决定观众能不能看懂。动线包含三件事:起点与终点(从哪进来、到哪结束)、可通行性(哪里能走、哪里是墙)、引导与遮蔽(用什么吸引注意力、用什么挡住不该看的东西,行业里叫"掩体/遮挡")。
这里有一条来自真实项目的宝贵经验:校验必须先于实例化。检索到的多个 AI 关卡生成项目都遵循同一个流程——先让模型生成布局数据,对布局做严格校验(确保从出生点到钥匙、门、出口确实存在一条通路),校验通过之后才真正把物体实例化进引擎。其中 WATCH MY ESCAPE 的工作流更进一步,坚持先设计解法路径、再写地图 JSON:先想清楚"怎么算通关",再倒推地图长什么样。
课程情境:小舟把这条经验移植到短片里——先定 6 个镜头的机位与运动路径,再让楼台、扁舟、柳树的位置服务于这些机位(哪几个物体必须在画面里、哪个物体必须挡住画面外的东西)。这样搭出来的场景是"给镜头用的",而不是"摆着好看的"。
维度三:性能预算(面数、贴图、LOD、绘制调用)
性能预算(performance budget)是三个维度里最容易被忽略、却最"硬"的一个:它像一个月的伙食费,花超了就要挨饿。场景的性能开销主要来自四笔账:三角面总数(模型精细度)、贴图内存(每张 2K/4K 贴图都要占用显存)、细节层级(LOD)是否分层、以及绘制调用(draw call)的次数(引擎每提交一次"画这个材质的一批物体"就是一次调用)。
关于绘制调用,本书要坦白一个"事实底座"里的空白:检索范围内没有拿到 2026 年的 draw call 预算标准数字,所以这里只讲原理不给具体配额——合并材质、减少材质数量、对重复物体做实例化,是降低绘制调用的三个基本手段。同理,具体的面数预算也要看目标平台与引擎版本,本书在 7.6 节给出一份行业常用的参考区间,并明确标注它的适用条件。
| 维度 | 子项 | 怎么检查(不依赖主观感受) | 不通过时的第一处方 |
|---|---|---|---|
| 视觉统一 | 风格一致 | 把全部资产放进同一张对照图,遮住标签后能否一眼认出"这是一套" | 统一参考图集与色板,重生成跑偏的资产 |
| 比例关系 | 放入一个参照物体(如 1.8 米高的人形盒),逐个比对高度 | 按参照物缩放并应用变换,再重新导出 | |
| 玩法动线 | 可通行性 | 用胶囊体沿规划路径走一遍,记录卡住的位置 | 调整坡度、清除阻挡、加宽通道 |
| 视线引导 | 在关键机位截图,圈出画面第一眼落在哪里 | 用光照与材质对比度强化主体 | |
| 性能预算 | 面数与贴图 | 查看场景统计面板的三角面总数与贴图内存 | 减面 / 重拓扑 / 压缩贴图 |
| LOD 与材质 | 检查远景资产是否有低模替代;统计独立材质数量 | 生成 LOD 链;合并材质 |
有了"五要素 + 三维度"这把尺子,后面四节就是一条流水线:7.3 把需求变成规格表(用大语言模型)→ 7.4 用程序化算法铺出地形与布局(噪声、WFC、泊松盘)→ 7.5 按资产类型生成内容(天空盒、建筑、道具、材质)→ 7.6 落进引擎并把性能账算清。7.7 之后是案例、失败诊所、动手实践与思政专节。
7.3把一句话变成一张清单:大语言模型与场景规格表
回到小舟的困境。他说的是"搭一个夜江场景",而引擎需要的是"这 47 件资产,各自的编号、类型、位置、朝向、尺寸、面数上限和材质"。这两者之间隔着的不是"美术水平",而是一次翻译——把自然语言需求翻译成结构化数据。
好消息是:这次翻译恰好是大语言模型(large language model, LLM)最可靠的一种用法。坏消息是:它只有在被"约束"时才可靠。本节讲清楚这个约束怎么做。
核心模式:一句话 → JSON 规格 → 校验 → 建场景
把检索到的多个可运行项目放在一起看,会发现它们不约而同地长成同一个样子:自然语言描述关卡 → 由模型生成 JSON 格式的场景/布局规格 → 对 JSON 做 schema 校验与游戏规则校验 → 解析进引擎,构建出可玩的场景。所有项目反复强调的关键词是同一组:严格的输出契约、schema 校验、解析失败后的重试、强制结构化输出而不是解析自由文本。
为什么这个顺序不能换?用一个生活类比就懂了:它像装修。你不会对施工队说"给我弄个温馨点的客厅",然后指望他们自己拿主意;你会先出一张施工图——哪里是承重墙、插座几个、柜子多宽。施工图就是规格表:它把"温馨"翻译成可以核对的数字。而"先校验再施工"对应装修里的验线:如果图纸本身自相矛盾(门开在承重墙上),越早发现越省钱;等到墙都砌完了才发现,代价就是全部重做。
六个真实项目,一个共同答案
下面这张表是检索范围内可查到的、把"LLM 生成场景"真正做成了工具的项目。它们的做法差异很大,但收敛到同一批工程要点上——这些要点就是你可以直接抄进自己作业的模板。
| 项目 | 做法 | 可借鉴要点 |
|---|---|---|
| AI PCG - 2D (Unity 资源商店,发布日 2026-06-22) | 用具备空间推理能力的模型生成 JSON,描述一个完整、逻辑可通关的 2D 地牢布局;编辑器导入器解析 JSON,并按严格连通性规则校验(确保出生点到钥匙、门、出口存在通路),通过后才实例化到瓦片地图 | 校验先于实例化;提示工程可以被专业化成"主关卡设计师"式的专家系统 |
| AI Level Designer (开源,Unity 6 编辑器扩展) | 把自然语言提示经在线模型或本地模型转成 JSON 场景蓝图;模型的回答必须遵循内部 schema;内置 schema 校验、目录约束(最大对象上限)、网格与世界坐标模式、以及面向不同游戏类型的模板 | schema 契约 + 硬上限 + 类型模板三件套;"目录约束"能直接防住"生成 500 棵树" |
| game-exa 的 game-designer 技能 | 把自由形式的游戏描述转成严格 schema 的设计文档 JSON,其输出驱动贴图生成、关卡设计与代码合成;输出契约写明:只输出单个 JSON 对象,无散文、无代码围栏;并附硬约束(如恰好一个玩家实体)与校验脚本 | "只输出 JSON"的硬契约;用"恰好一个"这类断言把逻辑错误挡在门外 |
| WATCH MY ESCAPE 的 generate-map 技能 | 从情景描述生成并校验可玩地图文档:固定 15×15 网格、带行为的实体、谜题逻辑、分步解法走查;工作流坚持先设计解法路径、再写 JSON | 可解性先于可玩性;把"解法"当作一等公民先做出来 |
| Grue.is 的提示词指南 | 用工具调用做结构化输出:用规划、内容生成、玩法更新三类函数承载数据,并以强制指定函数的方式产生稳健 JSON;建议往工具 schema 加字段而不是写自由文本,schema 版本化并显式标注必填字段,在应用状态变更前先校验模型提出的变更 | 用强制函数调用代替解析自由文本;把"接受模型建议"变成一个需要校验的动作 |
| lore-weave | 分层方法:结构层用结构化 JSON,解析失败时重试(重试耗尽则回落到规范默认值);叙事层则刻意保持自由散文、不做结构校验;同时跟踪提示模板版本号,schema 变更导致缓存输出失效时提升版本号 | 结构层与创作层分离;重试 + 默认值兜底;提示模板版本号 |
| UniKit AI | 规范驱动:把游戏设计写成机器可读的注册表文件,规划从中读取;编辑器操作(场景、预制体)经由引擎的 MCP 服务器执行;词汇表已覆盖三款主流引擎 | "规格表 + 执行器"的架构——第 8 章讲智能体时会再遇到 MCP 这个词 |
学术侧也有两条对应的证据链:其一,一篇 2026 年 2 月发表的会议论文《Hybrid Procedural World Generation Using Generative AI》用一个网页应用把模型产出的结构良好、清晰的 JSON 数据(描述地形、任务叙事与物品特性)直接集成进游戏引擎;其二,一篇题为《Knowledge-Conditioned, Single-Pass LLM Synthesis of Executable Unity Game Scenes》的预印本证明了"带 schema 约束"的收益——在带 schema的条件下,用一个两段式管线(先产出引擎特定的中间表示 JSON,提示词明确要求"只输出合法 JSON,不要多余文本",再由编码提示词从中间表示生成引擎脚本)就能合成可执行的场景,而论文同时编目了若干编译错误类型,提醒我们"能生成"与"能编译"仍是两回事。
- 强制结构化输出——用 JSON schema 或带强制函数选择的工具调用,而不是解析自由文本。
- 建场景前先校验两件事——schema 合规,以及玩法规则(连通性、可解性、数量上限)。
- 解析失败要能重试,并用默认值兜底;schema 与提示模板都要版本化,避免旧缓存污染新结果。
- 先设计并校验"解法逻辑"(机位路径、开门条件),再谈摆件。
- 把创作/叙事层(自由散文)与结构层(严格 JSON)分开。
规格表长什么样:字段设计与一份可用的模板
字段设计有三个原则:机器能校验(用数字、枚举、布尔值,不用形容词)、人看得懂(字段名直白,附单位)、不重不漏(每件资产只归属于一个类别,每个相机只引用已存在的资产编号)。下面这张表把字段分类说明。
| 分组 | 字段示例 | 取值要求 | 为什么必须有 |
|---|---|---|---|
| 身份 | scene_id / version / engine | 字符串;版本号用数字递增 | 让场景可追溯:改了哪一版、给哪个引擎用 |
| 单位与范围 | units / extent.x_m / extent.z_m | 单位固定为米;范围用数字 | 尺度错误的根源往往就是"单位没说" |
| 地形 | generator / octaves / lacunarity / persistence / max_height_m / water_level_m | 枚举 + 数字;水面高度与地形同坐标系 | 把 7.4 节的噪声参数直接写进清单,结果可复现 |
| 氛围 | skybox_prompt / time_of_day / palette / fog_density | 色板给出 3–5 个十六进制色值 | 色板是"视觉统一"唯一可传递的东西 |
| 资产条目 | assets[]: id / type / prompt / position / rotation_deg / size_m / max_tris / material / lod_levels | id 唯一;type 限定枚举;max_tris 给硬上限 | 条目是清单的最小单位,也是"目录约束"的载体 |
| 预算 | budget.triangles_total / budget.texture_mb | 数字;与资产条目自洽 | 7.6 节的性能检查要靠它给出红线 |
| 镜头与动线 | cameras[]: id / position / look_at / path | look_at 只能引用已存在的资产 id | 让场景"为镜头而建",而不是摆完再说 |
下面是一份可直接使用、也可以直接复制去改的 JSON 骨架。注意它通篇只有数字、枚举和短标识符,没有一句抒情描写——抒情的部分("月色清冷")被我们留在了提示词里,因为那是给人看的。
{
  "scene_id": "chunjiang_night_river_v1",
  "version": 1,
  "engine": "Unity 2022 LTS",
  "units": "meter",
  "extent": { "x_m": 320, "z_m": 320 },
  "terrain": {
    "generator": "fbm", "seed": 20261009,
    "octaves": 5, "lacunarity": 2.0, "persistence": 0.5,
    "max_height_m": 18, "water_level_m": 0
  },
  "atmosphere": {
    "time_of_day": "night",
    "palette": ["#0b1b33", "#1d3557", "#6d8fae", "#e8d5a3", "#f4a261"],
    "fog_density": 0.008
  },
  "assets": [
    { "id": "sky_001", "type": "skybox", "format": "HDR",
      "prompt": "夜空,满月高悬于江面上方,薄云,远处山影,冷蓝主调" },
    { "id": "terr_001", "type": "terrain", "max_tris": 40000 },
    { "id": "water_001", "type": "water", "level_m": 0,
      "material": "M_Water_Night", "max_tris": 200 },
    { "id": "bld_001", "type": "building", "name": "临江楼台",
      "position": [-6, 0, 22], "rotation_deg": [0, -18, 0],
      "size_m": [9, 7, 6], "max_tris": 8000, "lod_levels": 3 },
    { "id": "prop_001", "type": "prop", "name": "扁舟",
      "position": [4, 0, 30], "rotation_deg": [0, 12, 0],
      "size_m": [3.2, 0.6, 1.1], "max_tris": 1200, "lod_levels": 2 },
    { "id": "prop_002", "type": "prop", "name": "灯笼",
      "position": [-3, 2.4, 23], "size_m": [0.4, 0.5, 0.4], "max_tris": 400 }
  ],
  "budget": { "triangles_total": 120000, "texture_mb": 180 },
  "cameras": [
    { "id": "cam_01", "position": [0, 1.6, 40], "look_at": "prop_001" }
  ]
}
需求描述:[夜景江边,一轮明月,右岸有一座临江楼台,水面上有一条扁舟,月色清冷、雾气淡]。
硬性约束:
1) 只输出一个 JSON 对象,不要散文、不要解释、不要代码围栏;
2) 所有长度单位为米,水面高度与地形使用同一坐标系;
3) 资产条目不超过 [12] 条,id 唯一且格式为 [类型缩写_三位序号];
4) 每件资产必须给出 max_tris,建筑不超过 [8000]、道具不超过 [1500];
5) 相机的 look_at 只能引用已存在的资产 id。
若某条需求无法映射到字段,请在 JSON 的 notes 字段里用一句中文说明,不要自行发明字段。
这份提示词里有三处值得单独说明。第一处是"只输出一个 JSON 对象"——这不是矫情。模型默认喜欢"先寒暄、再解释、最后给结果",而解析脚本只认第一字符到最后一字符都是 JSON 的文本;一旦多出一句"好的,这是你的场景:",整段解析就失败了。第二处是"不要自行发明字段"——模型很乐于帮你加字段(比如自己发明一个 mood_level),而多出来的字段会让校验脚本报错或者被悄悄忽略,两种结果都不好。第三处是"无法映射时写进 notes"——留一个合法的出口,比逼着模型硬编要诚实得多。
拿到 JSON 之后:四道校验
规格表生成出来只是开始。真正决定成败的是接下来这四道关,它们全部是确定性检查——不看画面、不靠感觉,只跑脚本或对照清单:
- schema 校验。字段名对不对、类型对不对、必填项有没有缺、枚举值是否在允许范围内。这一关解决"机器读不懂"的问题。
- 数量与目录约束。资产条数是否超过上限、同类资产是否过量("树上长了 200 个灯笼")、是否有重复 id。这一关解决"机器读得懂但读出来是灾难"的问题。
- 玩法规则校验。用你的相机路径当作"动线",检查:路径上的每个机位是否能看见主体、路径有没有穿过建筑内部、起点到终点是否连通。这一关解决"能建起来但走不通"的问题。
- 预算自洽校验。资产条目的 max_tris 求和是否超过 budget.triangles_total;贴图数量估算是否超过 texture_mb。这一关把"性能"从口头承诺变成算术题。
真实项目在文档里会直接写明失败路径:重试若干次,重试耗尽后回落到规范默认值而不是崩溃;同时给提示模板打版本号,schema 变更后让旧缓存失效。请把这三条写进你自己的作业脚本或检查清单——凡是"生成后才可能发现"的错误,都要有兜底策略。
初学者常犯的一个错,是试图"一次生成一切":让模型同时负责"把楼台放在 (x, y, z)"和"写出楼台牌匾上那句诗"。结果是两头都不讨好——坐标位置因为混在散文里而难以解析,诗句因为被塞进 JSON 字段里而写得干瘪。
更深一层的原因是:这两类内容的"正确"标准根本不同。坐标的正确标准是约束满足(在范围内、不重叠、可达),可以写成一个函数自动判真假;诗句与形制的正确标准是文化考据与审美判断,只能由人来判。把两套标准塞进同一次生成,就等于让一个函数同时承担"计算"和"裁决"两种职责——工程上,这几乎总是错的。
所以成熟的架构会长成图 7-3 右下角那样:左边是一个窄而深宽而浅的创作层(自由、开放、由人审阅)。窄的那一层交给脚本,宽的那一层交给你自己——这也解释了为什么本章强调"人负责审美与考据":那不是场面话,而是分工的技术必然。
7.4程序化生成:让规则替你"摆"场景
规格表告诉引擎"要有什么",但"具体长什么样"还有一大块是算出来的,不是画出来的——这就是程序化生成(procedural generation)。它听起来高深,其实你在游戏里早就见过它:为什么《我的世界》的地形可以无限延伸?为什么 Roguelike 游戏的每一局地牢都不一样?因为那些地形与地牢不是美术手工摆的,而是一段带随机数的规则跑出来的。
程序化生成对本章有两重意义。第一,它是"地形"这一要素的主力手段——文生三维工具能给你一栋楼,给不了你一片二十万平方米的丘陵。第二,它提供了一套"约束思维":好的程序化生成从来不是"随便撒",而是"在规则允许的范围内随机"。这个思维会让你回到 7.3 节时更明白——为什么规格表要写得那么死板。
噪声地形:把"随机"磨成"自然的起伏"
先做一个思想实验。如果让计算机在地图上给每个点随机取一个高度,你会得到一张碎末状的地面:相邻两个点的高度毫无关系,像电视雪花。这不是地形,这是沙子。自然地形有一个关键特征:相邻的地方高度相近——山不会在你脚边突然变成深谷,它会有一个过渡。
如何在"随机"里注入"过渡"?Perlin 噪声(一种经典的噪声算法)给出了一套优雅的解法,用生活中的东西类比最好懂:
想象一块棋盘,每个格子的角落都插着一支箭头,方向随机(这叫"随机梯度向量")。现在你要问"棋盘上某个点的地势有多高",做法是:把该点到它所在格子四个角的方向算出来,与四个角上的箭头各做一次"投影"(点积,可以理解为"这两个方向有多一致"),得到四个数;再按"离得越近、权重越大"的方式把这四个数平滑地插值混合起来(用平滑插值函数 smoothstep,而不是直线插值,这样过渡处不会有生硬的折角)。
于是你会得到一个奇迹般的结果:每个点的高度都是随机的,但相邻点的高度又是连续变化的——既有随机性,又有过渡。这正是"地形"需要的质感。
还有一层认识要建立:Perlin 噪声是伪随机的——它不接受真正的随机源,而是由输入的坐标决定输出。这意味着同一个输入必然得到同一个输出。这不是缺陷,而是功能:你只要记住那个"种子"(seed)数字,就能在三天后、在另一台电脑上,一模一样地重新长出那片地形。
在引擎里的落地方式是前文提过、这里必须点明的一句:绝不每帧采样噪声。噪声计算量不小,正确的做法是启动时一次性把高度图算好、存成一张图或一个数组(例如 513×513 的高度数组),之后每帧只是从内存里读数字。这条纪律的收益是几十倍的性能差——它是新手和专业之间最直观的一条分界线。
波函数坍缩:把"拼接"变成"推理"
第二类算法解决的是另一种需求:我要一片看起来风格统一、但每次都不一样的瓦片地图。比如一片古镇的院落、一座洞穴的内部、一段走廊与房间的组合。这类问题的难点不在"随机",而在"随便摆出来的东西拼不上"——屋顶瓦片接不上墙,路走到一半撞墙。
波函数坍缩(Wave Function Collapse,缩写 WFC,由 Gumin 于 2016 年提出)是一个名字唬人、思想却很朴素的方法。它的做法是:
- 准备样本。先给一张"样例图"(或一套瓦片),把它切成许多 N×N 的小图案块(比如 3×3 的像素块)。这就是你的"素材库"与"拼接规则集"。
- 初始化"可能性"。新建一张空地图,每个格子都列出"所有可能出现的图案"——此时每个格子都处于"不确定态",这叫它的叠加态。
- 观察:挑最"确定"的格子先动手。找到"剩余可选图案最少"的那个格子(也就是熵最低的格子),从它的候选里随机选一个,把它坍缩为确定值。
- 传播:把决定通知邻居。格子一旦确定,它的邻居就"少了一些可能"——凡是与它拼接不上的图案,都要从邻居的候选列表里删掉。删除又会继续影响邻居的邻居,如此链式传播。
- 重复到最后一格。全部格子坍缩完毕,整张地图就形成了:它与样例图的局部风格一致,但整体布局是全新的。
为什么要"先挑熵最低的"?类比一下:考试时先做最有把握的题。每一道题都代表一个格子的可能性集合;先做最确定的题,就能立刻把相关的题目排除掉一大片选项,越做越顺。反过来,如果先挑可能性最多的格子乱猜,一旦猜错,错误会沿着传播链扩散,最后整张地图崩坏——这就是 WFC 必须处理的"矛盾"问题:当某个格子的候选被删空时,说明已经无解,需要回溯或重启,同时必须设一个"最大迭代次数"的安全阀,避免程序陷入死循环。
熵(entropy)在信息论里衡量"不确定性的大小"。WFC 里的"熵最低"有具体的算法含义:看哪个格子的候选图案数量最少。候选越少,不确定性越低,越接近"确定"。实际实现中还会加权(把出现概率也考虑进去),但教学上抓住"候选数量"这一条就够了——它解释了 WFC 的全部行为:为什么它比纯随机稳、为什么会产生矛盾、以及为什么"简单布局不该用 WFC"(你的地图如果本来就没什么约束,用一把重锤砸一颗芝麻,反而更容易死循环)。
泊松盘采样:让物体散布看起来"自然"
地形铺好了,接下来要往上撒东西:树、石头、草丛、灯。最直觉的做法是"每个点随机取一个坐标"——结果是有的地方挤成一团,有的地方大片空白;更糟的是物体会互相重叠、互相穿插,看起来像个 bug。
解决办法叫泊松盘采样(Poisson disk sampling):要求任意两个点的间距不小于某个最小值,同时整体分布保持随机。它产出的分布叫"蓝噪声"——均匀但不成网格。生活类比:撒种子。你不会把种子撒成棋盘格(那不像自然),也不会随手一扬(那会长成一块块秃斑);你会尽量让每颗种子之间保持一点点距离。标准实现是 Bridson 算法(常用参数 k=30);想省算力,用"抖动网格"近似也行——先画规则网格,再把每个点在其格内随机挪一挪。
怎么选:一张决策表
程序化生成的算法不止一种,但它们其实各管一类需求。下面这张图是一份来自实践文档的"算法决策表",可以直接当作选型速查:看到需求,往右找算法。
| 技术 | 准确表述 | 典型用途 | 注意事项 |
|---|---|---|---|
| 波函数坍缩 (WFC,2016) | 约束驱动算法:把输入拆成 N×N 图案,运行"观察—传播"循环——选剩余候选最少的格子坍缩,进而约束邻格;完全坍缩后得到与原图特性相似的新地图。另有"简单瓦片模型"变体:每块瓦片四边带标识符,限制哪些瓦片可放在相邻格 | 受约束的瓦片地图、风格统一的室内与洞穴布局 | 必须检测矛盾(无有效瓦片时回溯或重启);设置最大迭代次数以避免死循环;简单布局不要用复杂 WFC(改用醉汉漫步或 BSP) |
| Perlin 噪声 | 一块格网,每个格角有一个随机梯度向量;对每个点,计算"到格角的距离向量"与"格角梯度"的点积,再用平滑插值混合。噪声是伪随机的——相同输入得到相同输出 | 二维高度图、三维点云、体素世界的属性分布 | 性能关键:绝不每帧采样噪声——预生成一次高度图存进图像或数组,此后从内存读取 |
| 分形噪声 (fBm) | 跨倍频累积任意噪声类型,三个参数控制:层数(octave)、频率增量(lacunarity)、振幅衰减(persistence) | 更自然的地形层次 | 参数直接写进规格表,才能复现同一片地形 |
| 泊松盘采样 | 提供"均匀但非网格"的物体放置。纯随机(白噪声)会造成聚集与重叠;本方法或抖动网格给出自然分布 | 放置物体、敌人、植被 | 标准做法是 Bridson 算法(k=30,蓝噪声分布) |
"伪随机"听起来像缺点:既然是假的,为什么不用真随机?因为在创作流程里,可复现比不可预测重要得多。
先看真随机会带来什么。如果地形由真随机决定,那么你今天生成了一个满意的江岸,明天想再生成一次"同一个江岸但树多一点",是做不到的——你只能重新抽一次奖,而抽出来的东西和昨天毫无关系。整个"迭代改进"的流程就断了:你没有"版本",只有"另一次开奖"。
伪随机解决的正是这件事:它以种子为输入,输出一段看起来完全随机的序列;同一个种子给出同一段序列。于是"种子"就成了你的作品版本号:seed=20261009 是"那版江岸",换一个种子就是"再开一局"。这也是为什么程序化生成的工程原则里,第一条写的是"始终使用带种子的伪随机数生成器以保证可复现"。
把这条原则翻译成创作语言,就是本章反复出现的那句:把一切能变成数字的东西变成数字。种子里放数字,参数写成数字,资产编号写成数字——只有可复现的东西,才谈得上打磨。
- 始终使用带种子的伪随机数生成器,保证可复现(常见的做法是使用短周期的高质量随机数算法,如 mulberry32、sfc32 这类)。
- 校验生成的输出——例如从起点到终点跑一次寻路,确认真的走通;程序化生成的产物在"看起来还行"和"真的可用"之间,差距往往就在这里。
- 大世界把生成移出主线程——分块、多线程生成,避免玩家在"卡顿的空白世界"里等地图出现。
7.5资产生产管线:每一类资产有它自己的"生产线"
规格表定好了要什么,程序化算法铺好了地形,接下来是真正的"造东西"环节。这一节的核心观念是:不要指望一个工具包打天下。天空盒、地形、植被、建筑、道具、材质,各自有各自的生成路径、各自的输出格式、各自的验收硬指标。把它们排成一条有序的流水线,比同时开十个网页靠谱得多。
天空盒:一个工具解决的"整个天空"
天空盒(skybox)是包裹住整个场景的 360° 环境图,它同时干三件事:提供天空的视觉内容、为场景提供环境光(间接照明的来源)、以及给水面和金属表面提供反射的"内容"。可以说,天空盒是"氛围"这一要素的技术载体。
它的生成方式已经相当成熟,检索到的最具代表性的工具是 Skybox AI(Blockade Labs)。它把一段文本提示转成生产级的 360° 等距柱状(equirectangular)环境图,秒级完成;官方自述已服务 150 万以上创作者、生成超过 1000 万个天空盒。它的工作流很简单,值得完整记下来:
- 写提示词描述环境。对场景、光照、时刻、氛围描述得越具体越好——例如"满月之下的开阔江面,薄云,远处山影,冷蓝主调"。
- 选风格包预设。平台提供 30 余种精选风格包,覆盖从照片级到动漫、数字绘画、低多边形、科幻等取向。这一步是"视觉统一"最省力的抓手:全组用同一个风格包,天空的"画法"就统一了。
- 生成并环视。数秒出图,可以点击拖拽做 360° 环视检查;不满意就重新生成或微调提示词。
- 下载。导出选项包括 1K 到 8K(默认 8K,即 8192×4096,最高支持 16K)等分辨率,格式上有等距柱状图、立方体贴图、HDR/EXR、深度图,甚至三维网格格式。
- 导入引擎。通常拖放即可设为场景的环境或背景贴图。
它的能力边界也要写清楚,免得你在错误的场景里浪费时间:官方明确它不设计用于创建人或动物;当前不能创建"引用其他天空盒"的天空盒来实现连贯的连通空间(该能力在开发中);也不支持等距柱状视频导出。免费档有明显限制(例如每月约 15 个天空盒,且带水印、按 CC-BY 许可使用),付费档才解锁更高配额、优先速度、商业许可与高级导出。价格、额度与版本在 2026 年变动频繁,使用前请以官方页面为准——这是本书对所有工具类信息的一贯要求。
这段提示词里有两个容易被忽略的细节,值得单独指出。第一是"左右边界需无缝衔接":等距柱状图是把球面展开成矩形,如果你不强调,生成结果左右两条边往往接不上,环绕一圈时会看到一道明显的"接缝"。第二是"无人物、无动物、无文字":天空是背景,一旦生成出一只飞鸟或一行文字,它会在环绕时被拉伸变形,成为画面上的笑话。把"不要什么"写进负向提示,是专业提示词与业余提示词最常见的区别之一。
地形、水面与植被:三种"量很大但很便宜"的资产
这三类资产有共同特点:占地大、数量多、但单件面数很低。它们是性能预算里最容易被浪费的地方,也是最容易通过工程手段省下来的地方。
地形由 7.4 节的噪声算法生成高度,再由你手工"雕刻"关键区域——把楼台所在的那块地压平、把江岸修出一条缓坡。这一步的价值在于:算法给出的是"自然",人给出的是"可用"。程序化地形能长出漂亮的山,但不会主动给你一块能放下房子的平地。
水面看似简单,其实是最容易露馅的一层。技术上它通常就是"一个平面 + 一套专用材质"——面数极低(两三个三角面就够),但材质里包含了反射、折射、波纹法线等一堆计算。它的验收要点有两句话:反射的方向必须与光照一致(月亮在高处,水里的月亮倒影就要相应地长而碎,不能是一轮完整的圆),水面高度必须与地形统一坐标系(否则会出现"船浮在山坡上"这种经典 bug)。
植被的正道是"低模 + 实例化 + 程序化散布":不要造 200 棵各不相同的高模树,而要造 2–3 种低模树,然后用 7.4 节的泊松盘采样把它们散布出去,并在引擎里以实例的方式重复使用。这样 200 棵树只占一份模型内存——这正是降低绘制调用的核心技巧。
建筑与道具:文生三维真正的主场
建筑与道具是"文生三维"能力最直接的体现:输入一段描述(或一张参考图),输出一个三维网格。这里有三条来自实践的经验:其一,小物件成功率最高——扁舟、灯笼、酒樽这类体量小、结构清晰的物体,生成质量明显优于复杂的建筑群。所以教学与原型阶段,建议从道具练手。其二,建筑要"先定体量、后定细节"——先确认它的长宽高与占地是否与地形、与镜头匹配,再去抠飞檐斗拱;顺序反了,抠得再精细也会被整体比例推翻。其三,参考图比文字更可靠——"唐风楼台"这四个字在不同模型脑中的画面差异巨大,而一张明确的参考图能把这个差异压缩掉大半。
这也顺带解释了第 4 章讲过的那条结论为什么重要:生成出来的网格不一定拓扑干净——可能有非流形边、内部面、反转法线,UV 也常常混乱(重叠、缺失、纹素密度不一致)。所以本章把"导出前检查"(7.6 节)视为管线里的必经环节,而不是可选项。第 4 章已详细讲过拓扑与 UV 的处理,这里只强调它在场景里的特殊后果:一个道具的 UV 乱了,你损失的是一张贴图;一片建筑的 UV 乱了,你损失的是整个画面的统一感。
材质:一次把话说清楚的"表面说明书"
材质(material)决定"这个表面怎么与光互动"。现代引擎使用 PBR(物理基础渲染)工作流,把表面属性拆到多张贴图上、共享同一套 UV 布局。对场景创作来说,只要记住三类贴图的分工即可:
- 基础色贴图(Albedo / Base Color)——纯表面颜色,不含烘焙的阴影与高光。这一条是初学者最容易违反的:如果你把一张"带着好看阴影"的贴图直接贴上去,一旦场景光照变化,那种阴影就会与真实光影打架,看起来"脏"。
- 法线贴图(Normal map)——用 RGB 三个通道编码表面凹凸的方向偏转,不增加多边形就能让平面看起来有细节。砖缝、木纹、瓦楞的"手感"基本都靠它。
- 粗糙度与金属度(Roughness / Metallic)——控制反射的锐利程度与"这是金属还是非金属"。粗糙度 0 相当于镜面,1 相当于完全哑光。
材质环节最大的坑不在生成,而在引擎之间的约定差异。这里有三条必须记住的"翻译规则":Unity 暴露的是 平滑度 = 1 − 粗糙度(外部导出的粗糙度贴图要用它的反相);Unity 默认是 Y 轴向上,而 Blender 是 Z 轴向上;Unity 与 Unreal 之间法线贴图的绿通道朝向相反。还有一条更隐蔽的:数字型(非颜色)贴图必须关闭 sRGB 色彩空间,否则你的粗糙度会被引擎按"颜色"再解释一遍,反射全乱。这些差异就是"看起来对"和"真的对"之间的那条分界线。
| 资产类型 | 主要生成路径 | 输出格式 | 提示词要点 | 验收硬指标 |
|---|---|---|---|---|
| 天空盒 | 文生 360° 等距柱状环境图 | HDR / EXR / 立方体贴图 / 等距柱状 PNG | 时刻 + 光照方向 + 云量 + 色调;强调无缝、无人物动物文字 | 左右边界能接上;分辨率与色深满足后续光照需求 |
| 地形 | 程序化噪声生成 + 手工雕刻关键区域 | 高度图 / 引擎地形数据 | 把噪声参数与种子写进规格表 | 坡度可通行;与水面共用坐标系;建筑落位处是平地 |
| 水面 | 平面网格 + 专用水体材质 | 材质 + 极少量网格 | 反射来源指向天空盒;波纹尺度与镜头距离匹配 | 反射方向与主光源一致;不穿透地形、不悬浮 |
| 植被 | 低模资产 + 泊松盘散布 + 实例化 | 网格 + 引擎植被/实例系统 | 统一树型与色彩;数量受目录约束限制 | 实例数量不超上限;无重叠穿插;远景有 LOD 替代 |
| 建筑 | 文生三维 / 图生三维(带参考图) | GLB / FBX | 先写体量与占地,再写形制与时代特征;附参考图 | 面数达标、Pivot 合理、UV 可用、比例与参照物一致 |
| 道具 | 文生三维(小物件成功率最高) | GLB / FBX | 说明用途、尺寸与材质直觉(木质/金属/织物) | 面数达标;Pivot 在几何中心(便于旋转摆放) |
本章的资产不是凭空来的——楼台与扁舟来自第 4 章的三维资产生成与导出质检,诗人角色来自第 5 章的角色动画,舞者/捣衣动作来自第 6 章的姿态迁移。本章的贡献是给出"它们放在哪里、多大、朝向如何"的那张地图,以及"拼起来之后还能跑"的那几道检查。
7.6落进引擎:导入流程、常见坑与性能预算
现在到了最容易翻车、也最有教学价值的一节。资产在生成工具里看起来完美,拖进引擎却"横着躺、大一百倍、颜色发粉"——这不是玄学,而是四个具体的技术原因:单位、变换、轴向、Pivot。把它们一次性讲清楚,你以后能省下大量瞎调的时间。
四个"不可见"的坑
第一个坑是尺度(unit / scale)。检索到的工程资料把它称为"最常见的失败点":AI 模型常以"任意真实世界尺度"导出,于是出现经典的"我的模型在哪?"问题。最典型的意外是单位不匹配——按米创作的模型,如果导入器假设是厘米,就会大或小 100 倍。Unity 用米,Unreal 用厘米,这句话请你记牢。处理办法:导出前用已知单位(例如约定 1 单位 = 1 米)对照原始人形或立方体参考缩放;在 Unity 里于资产的导入设置中设置缩放因子以匹配场景单位;在 Blender 里应用变换,让 scale 读数变成 (1, 1, 1) 再导出。
第二个坑是"未应用变换"。如果一个资产身上挂着一个 scale 为 (1.0, 1.0, 0.01) 且没有应用过的变换,它"到达引擎时会变成一个煎饼"。原因回到 7.1 节的层级数学:这个缩放会与父级、与引擎的导入设置相乘,结果无法预料。所以规矩是死的:导出前应用全部变换。
第三个坑是轴向(axis)。Blender 是 Z 轴向上;Unity 和 Unreal 是 Y 轴向上。FBX 与 glTF 这类格式会记录轴信息,但不匹配仍会导致模型翻转或旋转——预览中完美的模型可能"横着到达"(这正是小舟遇到的那一幕)。处理办法:在建模工具里把朝向修正为直立并应用旋转,导入引擎后再验证一次;资产应当对齐引擎的前向轴。
第四个坑是 Pivot / 原点。偏离中心的 Pivot"让引擎内放置成为噩梦":它可能落在世界原点、远在网格之外,或者出现"原点漂移"与包围盒不匹配——这些在渲染截图里完全看不见,却会在场景里破坏放置。正确的做法是按逻辑设置 Pivot:环境资产在地平面上,角色在颈根,机械物体在几何中心。
这是本章最反直觉、也最值得记住的一条工程观点:截图或精美的转台动画只证明了外观,它不证明尺度、不证明变换是否应用、不证明 Pivot 是否合理、不证明有没有非流形边,也不证明多边形预算是否达标。
为什么?因为上述四样东西都是"在某个特定上下文里才显形"的属性。一张孤立渲染的模型图,没有参照物,所以你看不出它是不是 100 倍大;没有坐标系,所以你看不出它是站是躺;没有操作,所以你看不出 Pivot 在哪;没有统计面板,所以你看不出它有多少面。它们就像一张身份证照片上的信息——照片能告诉你这个人长什么样,但告诉不了你他的身高、国籍和血型。
所以专业的做法是改用确定性断言(deterministic assertion):不看图,而是读数字。例如检查资产是否已应用缩放(一个断言问"scale 是否读作 1,1,1")、检查模型是否存在非流形边(断言问"非流形边计数是否为 0"),以及最朴素也最有效的一招——导出回读:导出之后重新读回来,验证数据与导出前一致。这套思路可以概括成一句工程结论,值得抄在你的工作笔记第一页:"引擎导入决定资产能否出货。"验证必须在导出前完成——引擎导入是最终检查,不是调试阶段。
| 坑 | 具体表现(工程资料中的原话) | 处理 |
|---|---|---|
| 尺度 | "最常见的失败点"。AI 模型常以"任意真实世界尺度"导出,导致经典的"我的模型在哪?"问题;单位不匹配是最常见的意外——按米创作的模型若导入器假设厘米,会大或小 100 倍。Unity 用米,Unreal 用厘米 | 导出前用已知单位对照原始人形或立方体参考缩放;在引擎资产导入设置里设好缩放因子;在建模工具中应用变换,使缩放读作 (1, 1, 1) |
| 未应用变换 | 带缩放 (1.0, 1.0, 0.01) 且未应用变换的资产"到达 Unreal 会变成一个煎饼" | 导出前应用全部变换 |
| 轴向 | 建模工具常见 Z 轴向上,Unity 与 Unreal 是 Y 轴向上。格式会记录轴信息,但不匹配仍会导致模型翻转或旋转——预览中完美的模型可能"横着到达" | 在建模工具里修正朝向(旋转到直立并应用旋转),再在引擎里验证;资产应对齐引擎的前向轴 |
| Pivot / 原点 | 偏离中心的 Pivot"让引擎内放置成为噩梦";它可能在世界原点、远离网格之外,或出现"原点漂移"与包围盒不匹配——渲染中不可见,却破坏场景放置 | 按逻辑设置 Pivot:环境资产在地平面上、角色在颈根、机械物体在几何中心 |
| 面数与拓扑 | 过密三角网格、混乱三角、不一致边流、非流形边、内部面、游离顶点、空洞、反转法线,会导致着色错误或导入失败 | 会形变的物体(角色、生物、关节道具)必须重拓扑(以干净的四边形为主、边流可预测);静态非形变道具可接受减面处理 |
| UV | AI 生成的 UV 常混乱——重叠壳、缺失 UV、纹素密度不一致——导致纹理损坏 | 重新生成或修复 UV,让岛屿适配 0–1 空间并留出间距。注意:重拓扑必须先于 UV 展开 |
| 材质与贴图 | 缺失贴图、断裂引用、PBR 数据"在引擎间不总能干净映射";Unity 里的粉色材质通常表示材质与着色器的交接问题,不是重新导入能解决的;法线贴图绿通道朝向在 Unity 与 Unreal 间不同 | 逐张贴图验证通道与色彩空间;数据贴图关闭 sRGB |
| 格式选择 | FBX 用于复杂高保真的引擎项目(携带网格、UV、材质、骨架、动画);glTF/GLB 适合 Web 与移动,是"友好的默认"——把几何、PBR 材质与贴图打进一个文件,但其材质系统在引擎中可能需要转换 | 按目标平台选择:把 GLB 当"预览与交付"格式,把 FBX 当"引擎工作"格式 |
| 碰撞与 LOD | 标准的 AI 导出不含经过验证的碰撞网格 | 生成简化碰撞体(盒、胶囊、凸包);为重复或远处的资产生成 LOD 链 |
性能预算:把"会不会卡"变成一道算术题
性能不是一个"跑起来才知道"的玄学问题,而是一份预算表。它的结构很像家庭记账:先定总收入(目标平台能承受的开销),再给每一类资产分配额度,最后逐项核对支出。
先看最直观的一笔账——三角面预算。下面这张图是一次工程资料的汇总,注意刻度是对数的:从几百面到几十万面跨了三个数量级,线性刻度根本画不下。
| 资产类型 | 三角面预算 | 说明 |
|---|---|---|
| 移动端背景道具 | 200–1,500 | 画面最远、最不起眼的一层,预算最紧 |
| 桌面端环境道具 | 1,500–8,000 | 近景可辨识的物件,如桌案、灯笼、石灯 |
| 主角道具 / 武器 | 8,000–25,000 | 会被特写、被拿在手里的物件,预算最高 |
| 角色工作流目标 | 约 20,000 | 角色是"要被看清"的主体,且需形变边环 |
| 某三维生成工具的默认网格档 | 约 5,000 | 作为对照:工具默认值不等于项目预算 |
第二笔账更隐蔽,但往往更早成为瓶颈:贴图内存。工程资料明确指出,UE5 的 Nanite 等虚拟几何技术虽然放松了传统多边形数量的约束,但拓扑、UV 质量、贴图内存与材质复杂度仍然影响性能——而且贴图内存通常比多边形数更早成为瓶颈。这句话值得反复读:很多人把注意力全放在"减面"上,真正的瓶颈却在"你有多少张 4K 贴图"。
第三笔账是 LOD(细节层级,level of detail)。原理很朴素:远处的物体不需要那么多面。同一棵树,近处用高模、中距离用中模、远距离用一张"贴着树形状的纸片",投影到屏幕上几乎没有差别,开销却差了几十倍。工程资料的建议是明确的:重复出现的资产与远处的资产都需要 LOD 链。
第四笔账是绘制调用(draw call)。它是"引擎向显卡提交一次绘制命令"的动作。这里要特别说明本书的诚实:检索范围内没有拿到 2026 年的绘制调用预算标准数字,所以这里只讲原理,不给配额——合并材质、减少材质数量、对重复物体使用实例化,是降低绘制调用的三个基本手段。注意它与 LOD 的关系:把 200 棵独立的树变成"1 个模型 + 200 个实例",省下来的主要不是内存,而是调用次数。
该省的省
远景资产的模型精度、看不到的背面、重复物体的独立材质、超高分辨率的贴图、法线强度过高的细节。这些"省下来"几乎无损观感。
不该省的地方
主光源方向的统一、水面反射与光源的一致性、主体资产的 UV 与纹素密度、角色形变区的边环——这些一省就"露馅"。
先做减法,再做加法
先把资产数量与面数压到预算内跑通一遍"能看的场景",再往上加细节。反过来(先堆满再加)几乎必然要推翻重做。
把预算写进规格表
预算是约束,不是事后统计。把它写进 7.3 节的 JSON(max_tris、budget.triangles_total),生成阶段就有红线可依。
7.7关键概念表
本章术语密度较高,这里集中落表,作为复习与查检之用。建议对照你自己的工作文件逐个打勾——每一个词,都对应一次你会在实践里真正遇到的判断。
| 中文 | 英文 | 一句话解释 |
|---|---|---|
| 场景 | scene | 由地形、建筑、道具、光照、氛围构成的、可被观看或行走的三维空间 |
| 场景规格表 | scene spec / scene specification | 把自然语言需求转写成字段化数据的清单,通常是 JSON |
| 结构化输出 | structured output | 要求模型按规定格式(如 JSON schema)作答,而不是自由文本 |
| schema | schema | 字段名、类型与取值范围的"表格规范",用于自动校验 |
| 校验 | validation | 用脚本或规则检查数据是否合法;分 schema 校验与玩法规则校验两层 |
| 目录约束 | catalog limits | 对资产数量、类型与规模的硬上限,防止"生成 500 棵树" |
| 连通性 | connectivity | 起点到终点是否真的存在通路,是玩法校验的第一条 |
| 可解性 | solvability | 关卡是否存在解法;成熟工作流坚持"先设计解法路径,再写地图" |
| 程序化生成 | procedural generation | 用带随机数的规则算出内容,而不是手工摆放每一件 |
| 噪声 | noise | 可产生连续随机起伏的算法;Perlin 噪声是其经典代表 |
| 分形噪声 | fractal noise, fBm | 把多层不同频率的噪声叠加起来,得到更自然的地形 |
| 倍频 | octave | fBm 叠加的层数;层数越多细节越丰富 |
| 频率增量 / 振幅衰减 | lacunarity / persistence | 每上一层的频率倍数与振幅倍数,常用 2.0 与 0.5 |
| 波函数坍缩 | wave function collapse, WFC | 用"观察—传播"循环生成与样例风格一致的新布局 |
| 熵 | entropy | 不确定性的度量;WFC 里指候选图案的数量 |
| 泊松盘采样 | Poisson disk sampling | 给出"均匀但非网格"的物体分布,避免聚集与重叠 |
| 蓝噪声 | blue noise | 泊松盘采样产出的分布类型,视觉上最接近自然散布 |
| 种子 | seed | 伪随机的输入;同一种子必然得到同一结果,是复现的基础 |
| 天空盒 | skybox | 包裹整个场景的 360° 环境图,同时提供天空内容与环境光 |
| 等距柱状投影 | equirectangular projection | 把球面环境展成矩形的投影方式,天空盒的通用格式 |
| 地形 | terrain | 场景的地面起伏与地表材质,通常由高度场表示 |
| 资产管线 | asset pipeline | 从需求到可导入资产的加工流程,含生成、检查、导出、导入 |
| 网格 | mesh | 三维物体的几何表示,由顶点、边与面构成 |
| 拓扑 | topology | 网格的连接结构;决定能否形变、能否干净展开 UV |
| 重拓扑 | retopology | 把高密度混乱三角网格重做成以四边形为主、边流可预测的网格 |
| 非流形边 | non-manifold edge | 被三个以上面共享的边;会导致着色错误或导入失败 |
| 水密 | watertight | 模型表面完全闭合、没有孔洞;打印与仿真必需,渲染则视需求而定 |
| UV 展开 | UV unwrapping | 把三维表面投影到二维坐标,使贴图能正确落位 |
| 纹素密度 | texel density | 贴图在模型表面的像素密度;不一致会显得有的地方糊、有的地方太锐 |
| 法线贴图 | normal map | 用 RGB 编码表面凹凸方向,不增加多边形就产生细节 |
| 粗糙度 / 金属度 | roughness / metallic | 控制反射锐度与"金属还是非金属"的 PBR 参数 |
| 物理基础渲染 | PBR | 把表面属性拆成一整套贴图、遵循能量守恒的渲染工作流 |
| 面数 | poly count | 网格的三角面数量,性能预算里最直观的一笔账 |
| 细节层级 | level of detail, LOD | 按距离切换不同精度的模型,远处用低模 |
| 绘制调用 | draw call | 引擎向显卡提交一次绘制命令;合并材质与实例化可降低它 |
| 实例化 | instancing | 同一个模型被多次复用但只占一份资源,专治"两百棵树" |
| 碰撞体 | collision mesh | 供物理引擎使用的简化几何;AI 导出通常不包含它 |
| 变换 / 应用变换 | transform / apply transform | 物体的位置、旋转与缩放;把缩放"固化"进网格再导出,是导入成功的前提 |
| 轴心点 | pivot | 物体的原点与旋转中心;它的位置决定场景内放置的手感 |
| 轴向 | axis | 哪个轴朝上;建模工具与引擎不一致会导致模型"横着到达" |
| 层级 | hierarchy | 场景里物体的父子树结构;父级移动会带着子级一起动 |
| 动线 | flow / pathing | 观众或玩家在场景中移动的路径,决定场景"为谁而建" |
| 确定性断言 | deterministic assertion | 不看图、只读数字的检查,如"缩放是否已应用""是否存在非流形边" |
| 导出回读 | export round-trip | 导出后重新读回文件,验证数据与导出前一致 |
| 级联误差 | cascading error | 多步骤生成中每一步的小偏差累积成整体跑偏 |
7.8案例教学:三支团队,一条共同的流水线
接下来三个案例,规模从"三个人一学期"到"上千人的工业化管线",但你会发现它们踩的是同一块地板:先把需求结构化,再让工具批量执行,最后靠人去检查和判断"对不对"。这个共性,就是我们这个通识课要教给你的东西。
背景:第 9 周,三人小组要为《春江花月夜》短片搭建主场景。小江的需求原话只有一句:"夜里的江边,一轮明月,右岸有一座临江楼台,水面上漂着一条小船,月色清冷。"上一周,小舟已经在引擎里被这句"文学描述"折腾得够呛。
做法:这次他们决定先做清单。小月先定参考图与色板(5 张水墨夜景 + 5 个十六进制色值,写在小组共享文档第一行);小舟用表 7-4 的字段模板写了一份提示词,让大语言模型把这句话翻译成 JSON;翻译出来是 12 件资产,他逐条核对后做了三处修改——把建筑的面数上限从模型默认的"不填"改成 8,000,把"灯笼"的位置从"楼台内部"改到画面右三分线附近(因为镜头在那儿),并把水面高度显式写成 0,与地形共用坐标系。随后是四道校验:schema 合规、数量未超上限、相机路径能从岸边平移到江心且中途不穿墙、预算求和低于 12 万面。全部通过,才开始生成。
结果:天空盒与地形半天完成;楼台第一次生成出来是个"二层小洋楼加盖飞檐"的混搭体,换了参考图重做一次才合格;扁舟一次通过;植被用泊松盘散布 60 余株低模柳树并做了实例化。全部导入后首次运行掉帧严重,查出两个原因:楼台贴图是 4K、且重复资产没有被实例化。压到 2K 并开启实例化后,场景在教室的笔记本上稳定可演示。整个场景初稿耗时约两天,其中"生成"占了不到三分之一,剩下时间几乎都花在校验与检查上。
复盘:小舟在小组日志里写了一句总结,值得抄下来:"省下来的不是做资产的时间,而是反复返工的时间。"他们真正的提速点在两处:一是需求被写成了可核对的数字,返工从"全部重做"变成"改一行的值";二是环境层先于物体层完成,所以物体的受光和色调一次就对上了,没有出现"做完楼台才发现整体太亮"的连锁返工。
背景:据公开报道,盛趣游戏在完成某款头部国产游戏(以中国神话与古建场景闻名)的局部场景复刻时,投入的人力是1 名三维艺术家、1 位场景设计师,以及半个技术支持;此后同类流程被应用到另一款项目的三维模型制作中,效率较纯人工建模提升约 100%。
做法:把这件事拆开看,就能看出本章讲的流水线在工业环境里的样子:场景设计师负责"需求结构化"(哪些资产、什么风格、什么预算),三维艺术家负责"生成物的甄别与重做"(哪些能直接用、哪些要重拓扑或重做 UV),技术支持则把"校验"这一步脚本化——面数统计、命名规范检查、导入报错监控。三个人各管一段,恰好对应 7.3 节那张图的三个环节。
结果:据该企业公开披露的口径,效率较纯人工提升约 100%。需要清楚说明的是:这类效率数字来自企业公开信息与媒体报道,口径各异,不是第三方测量的客观结论,教材引用它,是为说明"分工结构"而非为说明"AI 有多强"。
复盘:这个案例最值得学的是人数结构:三个人里没有一个专职"操作生成工具"的岗位。这说明在成熟的管线里,"生成"已经变成了一个按钮,真正的工作量转移到了需求定义、资产甄别与流程自动化三处——这也正是本章希望你建立的能力结构。原场景是实拍级的实景复原,也提示了一条实用路径:有真实参照物时,优先用参照(照片、测量、扫描)而不是纯想象,它同时解决"像不像"和"对不对"两个问题。
背景:据公开报道与媒体报道,网易在《逆水寒》项目中通过 AI 原生管线覆盖原画、模型、动画、音频、关卡、测试等环节,其中场景设计效率提升约 70%,动画产能综合提效 30%–300%,AI 生成任务脚本的时间从 2 周缩短到 3 天、人力成本下降约 40%。同批公开信息里还有一个细节更值得注意:其美术资源平台可以对具体项目做一键式风格化模型微调,目标是"确保生成内容与项目美术设定统一"。
做法:关键就在那句"确保风格统一"。大项目不可能靠"每次写好提示词"来维持风格——那太不稳定。它们的做法是把风格沉淀成资产:把项目的美术设定训练/微调成一个专用模型,让所有生成都从同一个"风格原点"出发。这与 7.2 节给学生的土办法(参考图集 + 色板 + 材质命名规范)是同一个道理,只是量级不同:学生用一套图统一风格,工业管线用一套模型统一风格。
结果:据企业公开披露,部分环节效能提升显著。同样需要注明:这些数字属于企业自称或媒体转述,口径各异;公开信息里同时提到该管线运行在支持 1 万–3 万节点的高并发私有云上——"效率提升"的背后是巨大的基础设施投入,这一点常被忽略。
复盘:这个案例给通识课读者的启示不是"大厂效率高",而是"风格"是可以被工程化的对象。你不需要私有云,但你完全可以做三件同构的事:建一个属于本组的参考图集、固定一套色板、给材质起统一的命名规则。这三件事的成本几乎为零,收益却是"全片看起来像一个人做的"。
| 数据 | 来源性质 | 可用来说明什么 |
|---|---|---|
| 国内收入排名前 50 的游戏企业已有约 80% 公开披露开展 AI 相关布局;游戏企业 AI 技术普及率约 86% | 行业报告与协会负责人公开发言(伽马数据 2026 年 7 月底报告、中国音数协) | AI 进入场景与美术生产已是行业常态,不是实验 |
| AI 美术提效 30%–300%;美术设计是 AI 应用最广环节(约 84.2%);三维资产生成从"数周压缩至数分钟" | 券商研究报告测算 | 区间极宽,说明"效率"高度依赖流程与资产类型 |
| 某企业全链路 AI 创作方案应用于近 100 个游戏项目,部分生产环节效率最高提升约 8 倍;角色动画制作从 3 天压缩到 15 分钟 | 企业公开披露(媒体报道转述) | "部分环节"与"最高"是关键限定词,不可当作整条管线均值 |
| 三维资产生产从"5–7 天、数千元"变为"10 分钟、数元" | 企业云业务公开宣传 | 单件资产的生成成本确实坍缩,但不计人工检查与返工 |
| 某城市布局工具把 25 平方千米虚拟城市的开发周期从 5 天缩短至 25 分钟 | 企业公开披露 | 程序化 + 结构化的组合,在大规模重复内容上收益最大 |
| 某项目局部场景复刻投入 1 名三维艺术家 + 1 位场景设计师 + 半个技术支持,效率较纯人工提升约 100% | 企业公开信息与媒体报道 | 人力结构的重组,比"用不用 AI"更能解释效率来源 |
第一,先看口径:"效率提升"说的是单件资产生成时间、整个环节的工时,还是项目周期?三者差别巨大。第二,先看分母:从 3 天压到 15 分钟的前提往往是"这件工作已经被高度标准化",无法标准化的工作压不下来。第三,看有没有算入返工:这正是下一节失败的起点——如果省下的时间被返工吃掉,账面上的效率就没有意义。
7.9失败案例诊所:三个真实的翻车现场
三个诊断案例,分别对应性能、视觉、文化三类事故。每个都按"症状 → 成因 → 处方"写,处方都可以直接用。
症状:场景在引擎里根本跑不动。小月把两份场景的截图并排给同学看,大家一致认为"差别不大";但打开统计面板,一份是 29 万三角面,另一份是 3278 万三角面——差了约 111 倍。
成因:这不是某个参数的锅,而是"生成物的默认值"与"生产物的预算"根本不是同一套标准。检索到的一项对照案例(一项以"风格化奇幻酒馆场景"为对象、n=1 的实践导向比较案例研究)给出了具体数字:手工搭建的场景 123 个物体、293,828 三角面;AI 辅助搭建的场景 103 个物体、32,781,505 三角面,约 111.6 倍;建模耗时分别是 716.06 分钟与 238 分钟,差值约 478 分钟。报告的原话是:省下的时间"伴随着可观的技术债"——那 478 分钟没有消失,它转化成了后面的返工与修复。为什么生成器会输出这么密的网格?一份来自三维生成工具厂商的技术文章说得很直白:这类网格"通常带有数十万个近似均匀的三角面——对渲染、编辑和动画管线而言过于密集";而简化算法虽然能减面,但作为纯粹的几何后处理,它产生的三角化"不尊重尖锐特征与部件结构",仍然远达不到生产资产所需的"干净的、美术师风格的拓扑"。
处方:四步。第一步,把面数预算写进规格表(表 7-8 给了分档参考:移动端背景道具 200–1,500、桌面端环境道具 1,500–8,000、主角道具 8,000–25,000),生成前就设上限,而不是生成后统计。第二步,按用途分流——会形变的(角色、生物、关节道具)必须重拓扑,静态道具可以接受减面;工程资料给出的工时参考是中等道具约 30–60 分钟、角色 2–4 小时,请把这笔时间计入项目排期。第三步,堵住贴图这条更早的瓶颈——记住那句工程结论:贴图内存通常比多边形数更早成为瓶颈。第四步,改验收方式——不看转台图,读统计数字。
一句提醒:这项对照案例原文自述为"单一奇幻酒馆场景的实践导向比较案例研究",不能推广为"AI 场景的普遍属性";它也不能说明"AI 一定更慢"。它说明的是一件更朴素的事:把生成物的默认输出直接当成生产物,会在下游付出代价。
症状:场景里每一件单独看都不错,合起来却像一盘拼盘:楼台是写实的、扁舟是低多边形的、远山是水墨的、灯笼是卡通渲染的;或者更隐蔽的一种——所有东西风格一致,但比例全乱:门高 6 米、船宽 12 米、栏杆比人还细,镜头一推近就露馅。
成因:两个独立的原因叠加。原因一:多次生成之间没有共享"约束"。每次调用生成工具都是一次独立抽签,如果你每次都只靠文字描述,风格就一定会漂移——这正是"级联误差"的典型场景:每一步偏一点,最后整体跑偏。原因二:比例从来没有被显式声明过。AI 模型常以"任意真实世界尺度"导出(表 7-7 的第一条坑);当"楼台"的生成结果高度是 9 单位、"扁舟"是 3.2 单位而它们各自的单位含义不同时,拼在一起就是灾难。换句话说:风格漂移是"参考不统一"造成的,比例失调是"单位不统一"造成的——两者都不是审美问题。
处方:三条,成本都很低。① 建参考图集与色板,全组共用一套,生成任何资产前先看一遍;能用风格包/预设的地方一定用预设(这也是天空盒工具提供 30 余种风格包的现实意义——它把"风格统一"变成了一个下拉框)。② 在场景里放一个"参照物":一个 1.8 米高的人形盒或一根标尺柱,任何资产导入后先与它比一次高度;这一招能当场抓住九成的比例问题。③ 固化单位与变换:约定 1 单位 = 1 米,导出前应用变换,让缩放读数变成 (1, 1, 1)——这不只是工程规范的洁癖,它是"下一个导入这个文件的人能不能用"的分界线。
一句话诊断法:当你说不出"这个场景哪里不对"时,先做两件事——把它全部换成纯灰白材质看一次(风格伪装被剥掉后,比例问题会立刻显形),再把它截图缩小到手机屏幕大小看一次(细节的嘈杂消失后,风格冲突会立刻显形)。
症状:画面很美,但懂行的人一眼看出不对——同一场景里出现了"夏季的西瓜"和"春季的樱花";建筑挂着某个朝代的形制、甲胄却是另一个朝代的风格;某个族群的角色穿着另一个族群的服饰。
成因:这是"符号"与"事实"的混淆。生成模型学的是符号的共现规律——"东方""古代""庭院"这些词在训练数据里经常和某些元素一起出现,于是它会把这些元素打包输出。但它不区分这些元素的年代、地域与使用场合。检索到的争议案例中,最典型的两个:其一,某款以日本战国为背景的作品在 2025 年被报道出现"夏季西瓜与春季樱花同框"的季节矛盾,并有学者批评角色服装形制与其设定身份不符;其二,某款历史策略游戏的限定内容中,城市国家的角色穿着被指为另一族群的服饰,争议归因包括"同文化圈模型复用""默认服饰复用"以及长期考据不足——在第三次补丁后,该内容才被替换为专门的服饰。
处方:不是"少用东方元素",而是把考据变成流程里的一步。检索到的正面路径给出了可操作的方法论:某款历史策略游戏在 2026 年 3 月推出的一套由中国创作者主导的服饰内容包,其考据方式是参考文物与古画——例如某种袍服参考了具体的明代行乐图卷与墓葬出土实物,另一种袍服参考了辽代墓葬出土的左衽交领袍。报道认为这种做法"减少了文化挪用与想当然还原的担忧"。把这条经验移植到你的作业里,就是三句可执行的话:一、凡涉及历史文化元素,先找一件可追溯的实物或古画参照,把出处写进资产条目的备注字段;二、找不到可靠参照时,主动把设计"抽象化"(用意象而非具体形制),并在作品说明里如实写明这是风格化处理;三、宁可少用,不可错用。
为什么这条对通识课尤其重要:因为最容易犯这个错的,恰恰是"有热情但没考据"的创作者。下一节的思政专节会把这条展开——它不只是审美问题,还牵涉到你作品的传播后果。
7.10动手实践:搭出你自己的"夜江场景"
本节共四个实践,前三个课堂完成、第四个课后完成,合计约 3 学时(其中实践二可与课后时间合并)。全部实践围绕同一个产出物:一份场景初稿 + 一份结构化资产清单——这既是本章的主线推进,也是课程作业"提交场景初稿与结构化资产清单"的内容。
先给你一张本章的"施工总图"。左侧是俯视布局(示意,非等比),右侧是它对应的清单——清单和布局是同一件事的两种表达:前者给机器读,后者给人看。
🛠 实践一:场景方案设计——让模型帮你写资产清单(40 分钟 · 课堂)
四步走,产出你的 scene.json 与一页布局草图:
- 写需求。用 100 字以内描述你想做的场景(可以是夜江,也可以换成你喜欢的任何题材,例如"雨夜的旧巷""雪山下的营地")。必须点名:时刻、天气、主体建筑、一件核心道具、情绪词。
- 出清单。把 7.3 节的"生成场景规格表"提示词卡复制进对话助手,把方括号里的内容换成你的需求;把表 7-4 的字段清单粘进提示词。要求模型只输出一个 JSON 对象。
- 做四道校验。对照 7.3 节结尾的四道关:schema 是否合规(字段名和类型对得上吗)、数量是否超上限、相机路径是否走得通、面数预算的加总是否自洽。把不合规的地方改回 JSON,不要只在心里记住。
- 画布局草图。照图 7-12 的样子,用纸笔或绘图工具画一张俯视图,标出清单里每一件的编号。凡是在图上找不到位置的资产,就说明它其实不该出现在清单里。
提交物:scene.json + 一张标注了编号的布局草图。评分看两条:清单能否被脚本解析;清单与草图是否一一对应。
给模型增加一个"目录约束":限定资产条目不超过 12 条、建筑不超过 2 座、同类道具不超过 3 件,并要求它在超限时自己说明舍弃了什么、为什么。你会看到"约束"如何把一份散漫的清单变成一份有取舍的方案——这正是 AI PCG-2D 一类项目里"硬上限"设计的用意。
🛠 实践二:资产生成——环境层与物体层(80 分钟 · 课堂 + 课后)
环境层(先做,约 30 分钟):
- 天空盒。用 7.5 节的天空盒提示词卡,写清时刻、光照方向、云量、色调,并明确"无缝衔接""无人物、无动物、无文字"。导出后做 360° 环视,检查接缝与拉伸。
- 地形。按 7.4 节的三个旋钮(层数 / 频率增量 / 振幅衰减)生成高度图,参数与种子写进
scene.json;再手工把楼台落位处压平、把江岸修出一条缓坡。 - 水面。用平面 + 水体材质;确认反射来源指向天空盒、水面高度与地形共用坐标系。
物体层(约 50 分钟):用下面的提示词卡分别生成建筑与道具,每类至少生成 2 版、择优采用。
植被与材质:用泊松盘采样(或抖动网格)沿江岸散布 40–60 株低模柳树,并在引擎中以实例方式复用同一个模型;材质统一压到 2K 以内,数据贴图关闭 sRGB 色彩空间,粗糙度贴图若来自外部工具记得在 Unity 里取反。
🛠 实践三:拼装与检查——把八项检查表跑一遍(40 分钟 · 课堂)
按图 7-9 的八项检查逐条走,边查边填表 7-12 的记录。三条硬要求:① 场面里必须放一个 1.8 米高的人形参照物;② 每件资产导入后都要看一次统计面板的面数;③ 发现的问题必须记录"改动前 / 改动后",这正是表 7-13 的任务。
做两次"对照自检":A 组只把资产拖进引擎、肉眼看着差不多就过;B 组完整跑八项检查。两组各记录:发现的问题数、修掉的问题数、花掉的时间。把两组数据填进下面的对照表——你会发现"检查"花掉的时间,正是从"反复返工"里省下来的。
导入快,第一印象好;问题在演示时才暴露:楼台比远山大、船横躺在草地上、贴图是粉的。
代价:发现问题的时刻最晚,修起来最贵。
导入慢一点,但问题当场记录、当场修;交付前不需再"救火"。
收益:问题修在"改一行数字"的阶段,而不是"推翻重做"的阶段。
🛠 实践四:性能初检与优化(30 分钟 · 课后)
- 读数字。打开引擎的场景统计面板,记录三角面总数、贴图内存占用、独立材质数量。三项都要写进作业文档,不能只写"感觉很流畅"。
- 对照预算。与
scene.json里的budget比对;超了就先做三件事:给远处的树和建筑生成 LOD、把重复资产改成实例、把 4K 贴图降到 2K。 - 再读一次数字。把优化前后的两组数字并排列出(表 7-13 的下半部分),并写出你的结论一句话。
- 记录未解决的问题。诚实写下"我知道它有问题但这次没解决"的那几项——比如某件道具的 UV 还没重做。把技术债写出来,是让它不再复利增长的第一步。
提交物:优化前后对照表 + 一句结论 + 未解决问题清单。
把你的场景清单交给同组另一位同学,让他只按清单(不看你的场景)复述"这个场景长什么样"。如果他的复述和你脑中的画面有明显偏差,说明你的清单还缺字段——通常是缺了空间关系(谁在前、谁在后)或尺度参照。
scene.json,否则清单就成了一份过期的说明书。| 编号 | 类型 | 名称 | 生成方式 | 尺寸 (m) | 位置 (x, y, z) | 面数上限 | LOD | 状态与备注 |
|---|---|---|---|---|---|---|---|---|
| sky_001 | 天空盒 | 夜江夜空 | 文生 360° | — | — | — | — | 已生成 · HDR 导出 |
| terr_001 | 地形 | 江岸丘陵 | fBm 噪声 + 雕刻 | 320 × 320 | 0, 0, 0 | 40,000 | 2 | 已生成 · 种子 20261009 |
| water_001 | 水面 | 夜江江面 | 平面 + 水体材质 | 320 × 320 | 0, 0, 0 | 200 | 1 | 已生成 · 高度与地形一致 |
| bld_001 | 建筑 | 临江楼台 | 文生三维 + 参考图 | 9 × 7 × 6 | −6, 0, 22 | 8,000 | 3 | 待重做 · 形制需核实 |
| prop_001 | 道具 | 扁舟 | 文生三维 | 3.2 × 0.6 × 1.1 | 4, 0, 30 | 1,200 | 2 | 已生成 · 一次通过 |
| prop_002 | 道具 | 灯笼 ×2 | 文生三维 | 0.4 × 0.5 × 0.4 | −3, 2.4, 23 | 400 | — | 已生成 · 暖光点光源载体 |
| veg_001 | 植被 | 江岸柳树簇 | 低模 + 泊松盘散布 | 高 4–6 | 沿江岸 | 600 / 株 | 3 | 已生成 · 实例化 60 株 |
| 备注栏必须写:考据出处(文物 / 古画 / 参考文献)、授权状态、生成工具与日期——这三项决定了你的作品能不能被复用。 | ||||||||
| 项目 | 修改前 | 修改后 | 触发修改的检查项 |
|---|---|---|---|
| 楼台面数 | 约 12 万面(工具默认导出) | 7,800 面 | 预算自洽校验(面数上限) |
| 楼台贴图 | 4K 基础色 + 4K 法线 | 2K + 1K | 贴图内存检查 |
| 整体比例 | 各资产"看起来差不多" | 与人形参照盒逐件比对 | 检查表第 1 项(尺度与单位) |
| Pivot | 位于世界原点 | 移至地平面中心 | 检查表第 4 项(Pivot 与原点) |
| 柳树 | 60 个独立模型 | 1 个模型 + 60 个实例 | 绘制调用与内存优化 |
| 水面反射 | 反射方向与月亮不一致 | 材质反射源指向天空盒 | 视觉统一检查 |
| 相机动线 | 路径穿过楼台内部 | 路径外移 4 米绕行 | 玩法规则校验(连通性) |
| 序号 | 检查项 | 判定方式(读数字,不看图) | 通过 | 备注 / 待修 |
|---|---|---|---|---|
| 1 | 尺度与单位 | 与人形参照盒(1.8 m)比对高度 | □ | |
| 2 | 变换是否已应用 | 缩放读数是否为 (1, 1, 1) | □ | |
| 3 | 轴向与朝向 | 导入后是否直立、是否对齐前向轴 | □ | |
| 4 | Pivot 与原点 | 环境资产在地平面、道具在几何中心 | □ | |
| 5 | 面数与拓扑 | 统计面板面数是否落在预算内;非流形边是否为零 | □ | |
| 6 | UV 展开 | 是否有重叠壳、缺失 UV;纹素密度是否一致 | □ | |
| 7 | 材质与贴图通道 | 粗糙度是否需反转;数据贴图是否关闭 sRGB | □ | |
| 8 | 碰撞体与 LOD | 是否已生成简化碰撞体;远景是否有 LOD 链 | □ |
7.11课程思政:文化准确性与团队劳动
这一节讨论两个容易被回避、却每天都发生在场景创作里的问题:你搭的这个"世界",对它所代表的文化负责吗?搭它的这些人(包括你自己)的劳动,被诚实对待了吗?我们一条一条说清楚,不给空话。
一、场景是文化载体:准确比"好看"更重要
前面讲过,建筑的第二个职责是"提供文化信息"——观众看到飞檐斗拱、看到服饰形制,就会自动推断"这是哪里、什么年代、谁住在这里"。这意味着场景设计天然是一次文化陈述,它不可能"只是美术"。
检索到的公开争议提供了几条真实教训。一款以日本战国为背景的作品在 2025 年被报道出现"夏季西瓜与春季樱花同框"的季节矛盾,并有学者指出角色服装的形制与其设定身份不符——争议的核心不是"画得美不美",而是"考据粗疏"。同一批报道还提到:该作品中某处宗教场所可以被破坏,相关神社与协会提出抗议,据报道未获回复、补丁后仍可破坏,事件一度进入该国国会讨论层面。这类后果远超"美术问题":当场景把一个真实的信仰场所处理成可随意破坏的对象时,它触碰的是许多人的真实感情。
另有一款以敦煌为背景的作品被批评建筑风格"过度中亚化",专家认为应更具唐风,理由很具体:高昌出土的唐代木构是典型唐制,晚唐时期唐文化仍是该区域的主流文化。也有反驳意见认为,官式与宗教建筑可能更唐制,而普通民宅未必如此——这个反驳本身很有价值:它提醒我们,"考据"不等于"想当然地统一化",不同阶层、不同功能的建筑本来就有差异。还有一款历史策略游戏在限定内容中,让某座城市国家的角色穿上了另一族群的服饰,争议归因包括"同文化圈模型复用""默认服饰复用"以及长期考据不足;直到第三次补丁,才替换为专门的服饰。
在讲了这些争议之后,必须补上一句平衡的话:网络舆论里也出现了不同国家、不同地区的网友互相指责"挪用"与"双标"的现象——本书不站队,也不认为存在一个"谁有资格做谁的文化"的简单答案。真正有共识的,是方法论层面的那一条:
正面路径是存在的,而且很具体:某款历史策略游戏在 2026 年 3 月推出了三款创作者内容包,涵盖东亚、东北亚与东南亚的服饰与建筑;其中一套是该系列首次由中国创作者主导、官方发行的内容包,作者来自上海。它的考据方法可以直接被我们借鉴:参考文物与古画——例如某类袍服参考了《宣宗行乐图》《明宪宗元宵行乐图》等画作与明代墓葬出土实物;另一种袍服参考了辽代墓葬出土的左衽交领袍。报道的评价是:过去海外游戏处理东方题材常"元素堆得不少,形制却经不起推敲",而由本国创作者操刀、依据文物古画考据的做法,减少了"文化挪用"与"想当然还原"的担忧。
把上面的教训落成你能执行的动作,只有三条:
① 出处优先。凡涉及历史文化元素的资产(建筑形制、服饰、器物、节令物候),在清单的备注栏写下它的考据来源:是某幅古画、某处出土实物,还是某份文献。写不出出处的,就不要用它当"历史元素",而应明确标注为"虚构/风格化"。本章表 7-11 的备注栏就是为此而设。
② 少用优于错用。一个"意象化"的江边剪影,胜过一个形制错误的唐楼。用意象、光线、留白去表达时代感,比用一组错误的符号更安全,也更高级——这也是水墨风格在传统文化题材里特别适合初学者上手的原因。
③ 说清楚你在做什么。在作品说明里写明白:"本场景为艺术创作的风格化演绎,建筑形制参考某时代某类建筑,非严格复原。"这句话不削弱作品,反而体现了创作者的自觉——它把"风格化"与"考据"两种不同的标准分开了。
二、团队劳动:把"效率"和"代价"一起算清楚
第二个话题更贴近日常。这一章反复出现了一组数字:面数差 111 倍、建模省下 478 分钟、这些时间转化成了返工的技术债。请再读一遍最后半句。
行业公开数据里,效率数字往往只算"生成"这一段:三维资产生产从"5–7 天、数千元"到"10 分钟、数元",听上去像魔法。但同一批检索材料也给出了另一半:普通的手动重拓扑,中等道具约需 30–60 分钟、角色约需 2–4 小时;AI 生成的网格常常"带有数十万个近似均匀的三角面,对渲染、编辑和动画管线而言过于密集",而纯粹的几何减面"不尊重尖锐特征与部件结构",达不到生产资产要求的干净拓扑。把这两半合起来看,结论就很清楚:AI 没有消灭这些劳动,它把劳动的位置从"从零开始做"移动到了"检查、判断与重做"。
这个移动有三层含义,都值得你在课程里认真体会:
第一层,谁的工作变了。在盛趣的那个案例里,一个局部场景复刻投入的是"1 名三维艺术家 + 1 位场景设计师 + 半个技术支持"。没有一个是"专职点生成按钮"的岗位——因为按钮太便宜了。人力向三处集中:定义需求、甄别资产、把检查自动化。这和本章 7.3 节讲的"结构层交给脚本、创作层交给人"是同一件事的两面。
第二层,谁的判断不可替代。模型能生成一万座"楼台",但没有一座能替你回答"这座楼台放在这个镜头里对不对、它的形制对不对、它与小月定的色板和不和"。在本章的作业里,这三问恰好对应三个不同的岗位视角:小舟管"对不对"(技术检查),小月管"和不和"(视觉统一),小江管"该不该有"(叙事必要)。小组分工的价值,不在于每人分到多少活,而在于每人都保留了一块"必须自己判断"的地盘。
第三层,怎么诚实地写效率。检索材料里有一个反复出现的提醒:行业里大量效率提升数据来自企业自称或券商测算,口径各异,不能当作客观测量结果。本书在表 7-10 中为每一条数据都标注了来源性质——这不是走形式,这是通识课要教给你的媒介素养:看到"提效 300%"时,先问三句——口径是什么?分母是什么?算没算返工?同理,在你自己的作业报告里,也请诚实写下"哪部分我用了 AI、哪部分我手工做了、返工花了多久"。一份诚实的报告,比一份漂亮的报告有价值得多。
其一,如实标注 AI 参与。发布作品时按第 1 章讲过的要求做 AI 生成内容的标识——这既是法规要求(《人工智能生成合成内容标识办法》自 2025 年 9 月 1 日施行),也是一个创作者对受众的基本诚实。技术说明与参数对照要写清楚:哪些资产是生成的、用了什么工具、做了哪些人工修改。
其二,尊重素材来源与授权。参考图、扫描数据、动作数据都可能带着使用条款;把它们记进资产清单的备注栏(来源、授权方式、下载日期),是对他人劳动的尊重,也是作品能否被你继续使用的前提。
其三,别把"快"当成唯一标准。这一章最想留下的一句话,来自小舟写在小组日志里的那一句:"省下来的不是做资产的时间,而是反复返工的时间。"AI 给的是速度,不是判断;是产能,不是审美;是更多个选项,不是正确答案。把这三句话记住,你就已经比大多数"会用工具的人"走得更远了。
把这一章压缩成七句话
- 场景由地形、建筑、道具、光照、氛围五块拼图构成:地形给"地",建筑给"形",道具给"事",光照给"真",氛围给"情";拍照不对时,先问自己缺的是哪一块。
- 场景"好不好用"要用三个维度验收:视觉统一、玩法动线、性能预算——三者互相拉扯,先决定谁优先、谁让步,再动手。
- 大语言模型在场景任务里最可靠的用法是"翻译":把自然语言需求转成结构化的 JSON 规格表,而且必须"强制结构化输出 + schema 校验 + 玩法规则校验",校验先于实例化。
- 结构层(严格 JSON、可自动校验、失败可重试)与创作层(自由散文、由人审阅)必须分开——前者交给脚本,后者交给你自己。
- 程序化生成的核心是"在规则允许的范围内随机":噪声管地形,波函数坍缩管受约束的布局,泊松盘管自然散布,种子的意义是"同一个输入必然得到同一片地形"。
- 引擎落地的四个不可见的坑是尺度、变换、轴向、Pivot;验证必须在导出前完成,用确定性断言读数字而不是看截图——"引擎导入决定资产能否出货"。
- 最后一条是本章的价值观:把生成的默认输出直接当成生产物,代价会以返工与重做的形式出现;所以既要尊重文化的考据来源,也要诚实计算团队劳动的成本。
自测
自测 1:一位同学说:"我让 AI 生成了一个场景,拖进引擎就能用。"请指出这句话里至少两个需要怀疑的地方。
答案:至少有两处。① "生成"不等于"生产可用"——生成器的默认输出在面数、拓扑、UV、碰撞体上通常不满足项目预算,本章的 n=1 对照案例里,AI 辅助场景的面数是手工场景的约 111 倍,省下的 478 分钟建模时间变成了返工技术债。② "拖进引擎就能用"忽略了导入的四个坑——尺度(米与厘米差 100 倍)、未应用的变换(到引擎里会变成"煎饼")、轴向(可能"横着到达")、Pivot 偏离(放置成为噩梦)。正确的说法是:"它看起来能用,但要先过一遍图 7-9 的八项检查,才知道它是不是真的能用。"
自测 2:为什么本书要求"先校验、再实例化",而不是"先生成出来看看再说"?
答案:因为两件事的纠错成本差了几个数量级。规格表里的错误,纠正它只要改一行数字或重新生成一次;而实例化之后的错误——比如相机动线穿过楼台、资产数量超标、预算超支——往往意味着已经摆好的东西要重新排布、已经生成并导入的资产要重做。检索到的可运行项目几乎都遵循这条纪律:对 JSON 做严格连通性校验(确保出生点到出口存在通路)、做目录约束(最大对象上限)之后再建场景;其中有的项目更进一步,坚持"先设计解法路径、再写地图 JSON"。生活类比:装修要先验线,而不是等墙砌完再砸。
自测 3:用"三个旋钮"解释:为什么单层随机噪声看起来不像地形,而分形噪声(fBm)像?
答案:因为真实地形同时具有"大尺度的起伏"和"小尺度的粗糙"两种特征,而单层噪声只能提供其中一种:频率低、振幅大的那一层给你宽阔的山形,但表面太光滑;频率高、振幅小的那一层给你粗糙的质感,但整体没有高低。分形噪声把多层不同频率的噪声叠起来,三个旋钮分别控制叠几层(octave)、每层频率乘几倍(lacunarity,常用 2.0)、每层振幅乘几倍(persistence,常用 0.5),于是就同时得到了"山形"与"质感"。另外要记住:噪声是伪随机的——相同输入得到相同输出,因此固定种子就能复现同一片地形;而在性能上,绝不能每帧采样噪声,必须预生成一次高度图再从内存读取。
自测 4:波函数坍缩(WFC)为什么要"先挑熵最低的格子"?如果先挑熵最高的会怎样?
答案:熵在这里的具体含义是"这个格子的候选图案数量"。先挑熵最低的格子,等于先做最有把握的决定——候选最少意味着约束最多,一旦确定,就能可靠地把大量不兼容的图案从邻格候选里删掉,让后续每一步都更容易。反过来,先挑熵最高的格子等于在最不确定的地方乱猜:一旦猜错,错误会沿着传播链扩散,最终使某个格子的候选被删空,产生"矛盾",只能回溯或重启(这也是 WFC 必须设最大迭代次数安全阀的原因)。顺带记住那条实用建议:简单布局不要用复杂 WFC,改用醉汉漫步或 BSP 更合适。
自测 5:有同学说:"我的场景在引擎里看着没问题,说明资产是合格的。"请用本章的工程观点反驳,并给出两种替代的检查方式。
答案:反驳的依据是那条工程结论:截图或精美的转台只证明了外观,它不证明尺度、不证明变换是否已应用、不证明 Pivot 是否合理、不证明有没有非流形边、也不证明面数是否在预算内——因为这些属性只有"在特定上下文里"才会显形。替代方式(任答两种):① 确定性断言,例如检查缩放读数是否为 (1, 1, 1)、非流形边计数是否为零;② 导出回读,导出后重新读回文件,验证数据与导出前一致;③ 读统计面板,用面数、贴图内存、独立材质数量这些数字与规格表里的预算逐项比对;④ 放参照物,用 1.8 米的人形盒比对每件资产的高度。核心原则一句话:"验证必须在导出前完成——引擎导入是最终检查,不是调试阶段。"
自测 6:某作品被批评"把唐代建筑画成了和风样式"。请分别从"技术流程"和"创作伦理"两个角度说明你该如何改进。
答案:技术流程角度:问题出在流程里没有"考据"这一环——只靠文字提示词生成,模型会把"东方古代建筑"的符号打包输出,而它并不区分年代与地域。改进办法是把考据变成流程的一步:先从文物、古画、考古报告中确定形制(例如某类木构的具体做法),把来源写进资产清单的备注字段;生成时提供参考图而不只是文字;把"形制核对"列为验收项之一(与面数、UV 同级)。创作伦理角度:要认识到场景是文化陈述,错误形制可能造成误读与冒犯,尤其是涉及宗教场所、历史疆域等敏感内容时后果更严重;态度上采取三条规矩——出处优先(写不出出处就不当作历史元素使用)、少用优于错用(用意象与光线表达时代感)、说清楚你在做什么(在作品说明中标明是风格化演绎还是严格复原)。这里的方法论共识可以概括为一句:可追溯的考据来源 > 风格化想象。
拓展阅读
- 随查手册:本章用到的三维、天空盒、智能体平台等工具选型见附录 B 工具速查;场景资产涉及文化元素与真人素材时的合规要点见附录 E;把资产生成流程自动化的路径见附录 F。
- Skybox AI(Blockade Labs)官方文档与"2026 完整指南"——天空盒生成的完整工作流、风格包、导出格式与免费档限制;建议亲手生成 3–5 个不同时刻(清晨/正午/黄昏/夜晚)的同一场景天空盒,比较它们对同一批资产观感的影响(本章 7.5 节)。
- Gumin 的波函数坍缩原始项目与讲解文章(2016)——如果你想真正理解"观察—传播"循环,最有效的方式是找一个网页版 WFC 演示,亲手调小网格与样例图,观察它什么时候会失败、什么时候需要重启(本章 7.4 节)。
- 引擎官方文档中的"资产导入与优化"章节(Unity / Unreal / Godot 均有中文页面)——重点读"缩放因子、轴向、LOD、光照贴图"四节;把本章图 7-9 的八项检查与官方文档逐条对照,形成你自己的检查表(本章 7.6 节)。
- 与"场景 AI 生产"相关的行业报告与公开案例(伽马数据、中国音数协、各厂商公开披露)——阅读时请刻意练习一件事:为每一个效率数字标注"来源性质"(企业自称 / 券商测算 / 第三方测量),并追问它的口径与分母(本章 7.8、7.11 节)。
- 文博机构公开的书画与器物高清资源(如各大博物馆的数字藏品页)——这是最便宜也最可靠的"考据参考图集"来源;练习用它作为生成建筑与器物资产时的参考图,并在清单备注里写下具体条目(本章 7.11 节)。