视频生成与编辑
让画面动起来,比让画面好看难一个量级——时空表征、时间一致性、参数与剪辑的完整流水线。
- 知识:理解视频的时空表征(帧、时间维、数据立方体)与"为什么比图像难一个量级";能说清潜空间视频扩散、时空注意力、DiT 视频架构三条技术路线的关系,以及时间一致性为什么难(闪烁与漂移的成因);了解音视频联合生成的进展与"参数语义"背后的工程约束。
- 能力:能用文生视频、图生视频、首尾帧、参考图、运镜描述五种条件完成一个镜头的生成;能读懂并调控运动幅度、时长、分辨率、种子等参数,设计并执行"一次只改一个变量"的对照实验;能完成"生成 → 筛选 → 剪辑 → 配乐 → 导出"的完整流水线,并对失败片段写出可执行的改进方案。
- 素质:建立"AI 视频是概率生产、必须大浪淘沙"的理性预期与成本意识;掌握《人工智能生成合成内容标识办法》的要求,养成"发布前标识"的操作习惯,抵制虚假信息,坚持诚信自律。
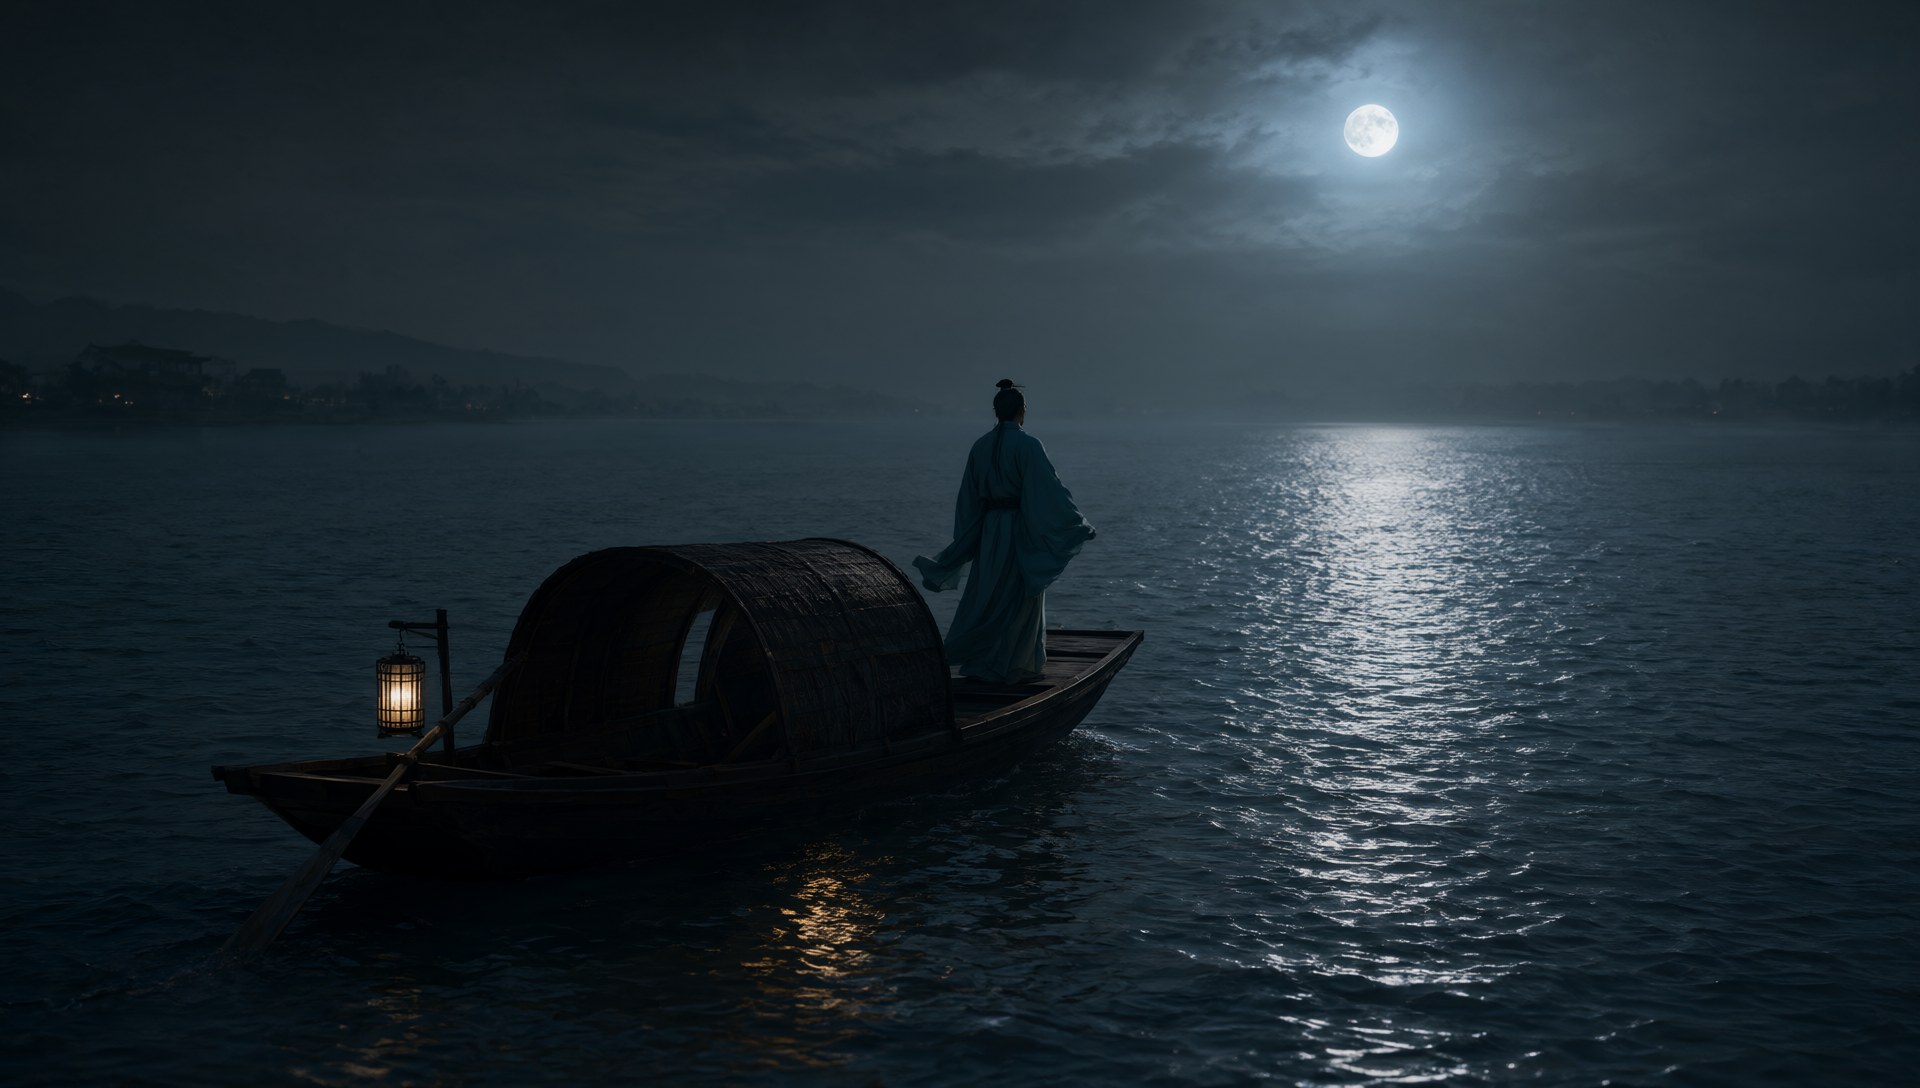
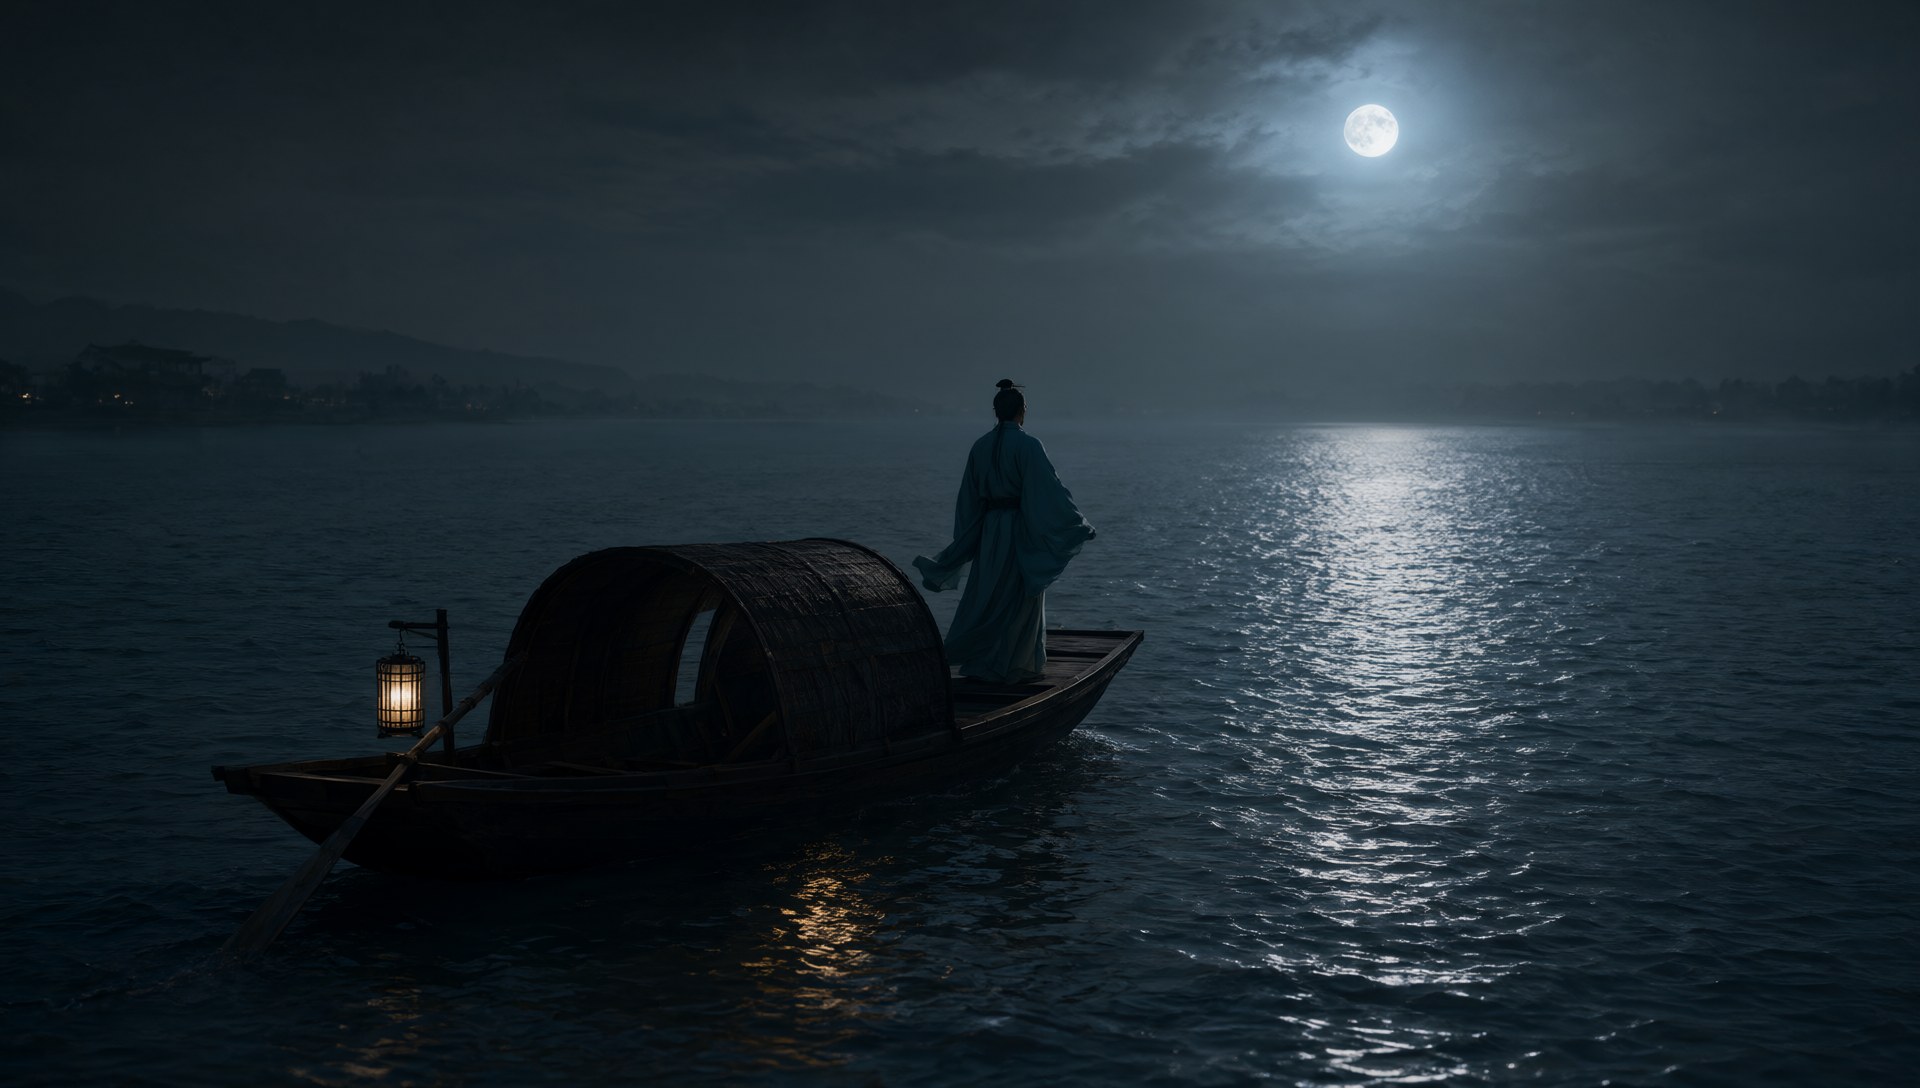
凌晨一点,小舟把第 2 章做好的分镜图"水月"拖进视频工具,输入提示词:"月夜,江面如镜,一轮明月从潮水中缓缓升起,镜头缓慢推近。"第一次生成的 5 秒里,第 1 秒很美,第 2 秒月亮抖了一下,第 3 秒江面像被揉皱又摊平——单看每一帧都还算过得去,连起来放却"跳"得像信号不好的老电视。她一共生成了 7 次,只有 2 次能看,最后剪进片子的那 1 段,是第 6 次生成的。这一章要讲清楚三件事:视频为什么比图像难一个量级(原理);运动幅度、时长、分辨率、种子这些旋钮各自在管什么(参数);以及怎么把"抽卡"变成一条可控的流水线,从几张分镜图做出 4–6 段能进成片的镜头(实操)。学完这一章,你手里就集齐了本书前半程最重要的两块拼图。
3.1视频的时空表征:多出来的那一维
第 2 章结尾,小月交付了 6 张分镜关键帧。但短片是要"动"的:月亮要升起来,江水要流,衣袂要飘。把一张静止的图变成一段动的画面,这件事在技术上叫什么?叫视频生成(video generation)。而理解它的第一步,是回答一个看起来很朴素的问题:在计算机眼里,"视频"到底是什么?
帧:视频的最小单位,是图像
答案的第一半简单得让人失望:视频就是一叠按顺序排好的图像。这叠图像里的每一张,叫一帧(frame);每秒播放多少张,叫帧率(frame rate,单位是 fps,frames per second)。电影工业的经典帧率是 24fps,多数生成工具的默认值在 24fps 到 30fps 之间。换算一下就明白"时间"有多贵:一段 5 秒的 24fps 片段 = 120 帧;10 秒 = 240 帧。第 2 章你为一帧的好看反复调参数,现在工具要求它在几秒钟里把 120 帧全部画出来,而且画得"前后不像两个人"。
这里就出现了本章第一个关键观念:图像生成与视频生成,不是"多画几张"的关系,而是"多了一整条约束"的关系。图像的目标是"这一帧看起来对";视频的目标是"每一帧看起来对,而且帧与帧之间的变化看起来也对"。前者是一个二维优化问题,后者是一个带时间轴的优化问题——后面所有的难点(闪烁、漂移、形变、物理错误),都从这条多出来的约束里长出来。
时空数据立方体:把视频看成"三维"数据
于是,视频在模型眼里有了一个更精确的画像:它不是"一串图",而是一个时空数据立方体——沿着宽(W)、高(H)、时间(T)三个方向同时展开的数据块。一张图像,是这个立方体在 T=1 时的特例;Sora 的技术报告《Video generation models as world simulators》(2024 年 2 月)正是这么处理的:图像只是"单帧视频",同一套方法可以处理。
为什么非要用"立方体"这个词?因为它能解释两件事。第一,压缩是三维的:第 2 章的图像模型在潜空间把画面在空间上压小;到了视频,模型的压缩网络(3D 因果 VAE 一类)会连时间方向也一起压缩——把相邻的几帧合并成"一帧的时间表示"。第二,代价是三维的:任何一维变大,代价都会同时上涨,而且是叠加性地上涨(下一小节详述)。
把视频看成立方体,还有一个立即可用的推论。既然多出来的维度是"时间",那么"帧率高不高、时长长不长、画面大不大"这三个旋钮转动的代价,就不是相加、而是相乘。举个具体对照:一部 1080p、1 分钟的影片,第三方测算给出的视觉词元数量级是百万级(约 100 万到 180 万,随压缩比、patch 大小与采样步数而变,属估算而非官方数字);而一个更小的公开对照是,模型 Mochi 1 在 480p、约 5.4 秒时,官方模型卡标出的视觉词元数是 44,520 个。从"5 秒 480p"到"1 分钟 1080p",画面并没有变复杂,但模型要处理的"格子"多了几十倍——而注意力机制的计算量是随格子数平方上涨的。
难在哪里:三重代价
把上面几段收拢成一句话:视频比图像难,难在"多了一维"带来了三重代价。第一重是数据代价:帧数 × 画幅,格子总数成倍增加。第二重是连续性代价:模型不仅要生成"好看的帧",还要生成"帧与帧之间正确的关系"——月亮的位置要在时间上平滑移动,而不是每帧独立地"重新画一个月亮"。第三重是累积代价:一帧里的小误差,会在生成下一帧时被当作"事实"接过去,一环带一环地放大(3.3 节整节都在讲这件事)。
你的日常类比是动画。手绘动画师画一个 5 秒的动作要画 120 张原画与中间画,但动画师手里有一条"动作线":他清楚地知道第 30 帧的手臂应该在哪个位置,因为第 29 帧在那儿。而 AI 视频模型生成第 30 帧时,它没有"手感",只有一个学出来的统计直觉——这既是它惊人高效的原因,也是它时不时"手滑"的原因。第 1 章讲过大语言模型"没有记忆",视频模型同样如此:它的"记忆"就是你喂给它的条件(首帧、参考图、上一段),而不是它"记得"自己刚才画了什么。
模型处理视频时,先把立方体切成小块(时空 patch),每块变成一个词元。设词元数为 N,则 N 大致与"时长 × 宽 × 高"成正比——把时长翻倍,N 就翻倍。
麻烦出在注意力上。第 1 章说过,注意力是"每个词元都看一圈其他词元并加权平均",因此它的计算量是"词元数 × 词元数",也就是 N²。N 翻倍,计算量变 4 倍;分辨率从 1080P 提到 4K(像素 4 倍),计算量约 16 倍。
一句话记住这条链:时间维 → 格子更多 → 平方更贵 → 平台给你设上限。下次看到某个工具的"单次最长 30 秒",你就知道那不是产品经理随手写的数字。
| 对比项 | 图像生成(第 2 章) | 视频生成(本章) | 对学生意味着什么 |
|---|---|---|---|
| 数据结构 | 一张画:宽 × 高 | 一个立方体:宽 × 高 × 时间 | 视频的产物天然要按"秒"来规划,按"帧"来估算 |
| 最小生成单位 | 1 张图 | 一段片段(常见 4–10 秒) | 分镜要按"镜"组织,一个镜一段,别指望一次生成整片 |
| 核心难点 | 构图、风格、细节、文字 | 再加"时间一致性"与"物理合理性" | 画面好看只是及格线,动得合理才是及格线以上 |
| 算力增长 | 随像素数超线性("时间墙") | 随像素数 × 帧数平方增长("平方墙") | 分辨率、时长每一项加码,等待时间与花费都跳档 |
| 可控手段 | 提示词、参考图、局部重绘 | 再加:首尾帧、参考视频、运镜描述、延长与重绘 | 条件越多,锚点越强,"抽卡"命中率越高 |
| 成功率的现实 | 尚可,一次常能出可用图 | 约 3 次生成得 1 个可用镜头(见 3.9 节) | 预算时间要按"生成次数"算,不是按"成品时长"算 |
3.2三条技术路线:视频模型是怎么"长"出来的
知道了"难在哪",接下来是一个很实际的问题:模型要怎么设计,才能一边画出好看的每一帧,一边保证帧与帧之间是连贯的?过去三年,这个问题的答案不是三个候选方案里挑一个,而是三条路线逐层叠加出来的。理解这个"叠加"关系,你就能看懂今天所有工具背后的共同骨架——也能在别人说"某模型是 XX 架构"时,分辨哪句是对的。
路线 A · 潜空间视频扩散:给图像模型"装上时间"
最自然的起点是:第 2 章的文生图模型已经很强了,能不能直接用?可以——拿成熟图像扩散模型当底座,把"时间"当成新部件插进去,再拿视频数据微调。这就是路线 A,技术上叫潜空间视频扩散(latent video diffusion)。第 2 章说过,扩散模型"在压缩过的潜空间里做去噪";视频扩散只是在这套流水线里增加了处理时间的层。
具体怎么插?两种典型做法最为常见。一是时间注意力层:让不同帧在同一个空间位置上"互相看一眼",从而协调彼此的样子;二是三维卷积残差块:把原来只在平面上滑动的卷积核,沿时间方向也滑动一下。学术界的两篇代表工作把这两条路都验证了:Video LDM(论文题名《Align your Latents》,2023 年 CVPR)明确实现了这两类时间混合层,长视频靠"迭代采样 + 上下文引导"拼接,高帧率靠额外的插帧模型补帧;Stable Video Diffusion(SVD)则把时间卷积与交叉注意力层加在 UNet 的每个空间块之后,并强调联合微调空间参数与时间参数比只训时间参数效果更好。它的训练是三段式的:先继承 SD 2.1 的图像预训练,再做大规模视频预训练,最后用约 100 万条精选高质量视频微调。
其一:"SVD 用的是 3D VAE。"不成立。SVD 的时间层在 UNet 去噪器内部,它的 VAE 沿用 SD 2.1 的图像 VAE,只做空间 8× 压缩,没有时间维压缩。真正带时间维压缩的 3D(因果)VAE 出现在后续的 CogVideoX、Open-Sora、HunyuanVideo、Wan 等模型里。写论文、做汇报时这个区别要点清:SVD 时代 = 图像 VAE + UNet 时间层;3D 因果 VAE 时代 = 空间与时间一起压缩。
其二:"Sora 用的是分解式时空注意力。"不成立。Sora 技术报告里说的 spacetime patches(时空小块)是输入表示——视频先被压缩成潜表示,再切成小块当作 Transformer 的词元,这与"注意力怎么连接"是两件事。"patch 化"回答"数据怎么切","注意力分解"回答"切完之后谁看谁"。把这两件事混为一谈,是最常见的技术表述错误之一。
路线 B · 时空注意力:在注意力里显式建模时间
路线 A 解决的是"怎么把图像模型变成视频模型",路线 B 进一步追问:时间关系到底该在哪里、以什么方式被建模?最著名的答案是 AnimateDiff(ICLR 2024):向一个冻结的文生图模型插入一个即插即用的"运动模块"——一个标准的时序 Transformer,沿着时间轴做时间自注意力,在海量视频上学到"通用的运动先验"。它的巧妙之处在于"冻结":图像模型负责画面质量,运动模块负责让它动起来,两条能力被解耦开来。论文还展示了 MotionLoRA——大约 50 个参考视频就能适配一种新的运动模式(比如某种特定的摇镜),这为后来的"参考视频控制运镜"埋下了伏笔。
随着模型从 UNet 走向 Transformer,"时空注意力"演进出两种形态。全时空注意力让所有时空位置两两相连,表达能力最强,代价是复杂度 O((T·H·W)²);分解式时空注意力(factorized attention)把它拆成两步——先做"帧内空间注意力"(同一帧里像素块互相看),再做"同位置跨帧时间注意力"(同一个位置在不同帧上互相看),复杂度降为 O(T(HW)² + HW·T²),显著更省,代价是一致性略逊。Open-Sora 的 STDiT 就是这一思路的代表:"帧内空间自注意力 + 同位置跨帧时间注意力"。
路线 C · DiT 视频架构:把一切交给可扩展的 Transformer
第三条路线的起点是 2022 年的一篇论文:DiT(Diffusion Transformer,Peebles 与 Xie)。它做了一个"简单粗暴"的替换——把扩散模型里去噪用的 U-Net 主干换成 Transformer,直接让它跑在潜空间的 patch 上。为什么这件事重要?因为 DiT 论文用一个清晰的指标回答了"换掉之后好在哪":以前向计算量(Gflops)衡量可扩展性,Gflops 越大的模型 FID(生成质量指标,越低越好)持续下降——换句话说,这条路能"吃算力":只要堆规模,质量就跟着涨,而且涨得可预测。论文里最大的模型 DiT-XL/2 在 ImageNet 256×256 上取得了 FID 2.27 的成绩。
后来的一切就顺理成章了:Sora 技术报告明确说明其模型是 diffusion transformer;国内的 CogVideoX、混元视频、万相系列也陆续走到同一条主线上。当代主流的配方可以写成一行公式:3D 因果 VAE(空间与时间一起压缩)+ 全时空注意力 DiT(统一去噪)。各家在这个配方上的取舍,正是你在工具里能感受到的差异来源。
| 路线 | 回答的问题 | 核心机制 | 代表工作 | 优势 | 代价 |
|---|---|---|---|---|---|
| A · 潜空间视频扩散 | 怎么把图像模型变成视频模型 | 在图像 UNet 的空间块后插入时间注意力层与三维卷积残差块,再在视频上微调 | Video LDM(2023)、Stable Video Diffusion | 复用强大的图像先验,训练成本低,图生视频效果好,插件生态成熟 | 图像底座无原生三维时空建模;时长与分辨率为固定小规格;长程一致性弱、易闪烁 |
| B · 时空注意力 | 时间关系在注意力里怎么建模 | 时间自注意力(AnimateDiff 式运动模块);或分解式:帧内空间注意力 + 同位置跨帧时间注意力 | AnimateDiff(ICLR 2024)、Open-Sora 的 STDiT | 机制清晰、显存与算力可控;运动模块可即插即用,MotionLoRA 约 50 条视频即可适配新运动 | 分解式的一致性略逊于全时空;全时空则复杂度按平方上涨 |
| C · DiT 视频架构 | 怎么做得更大、更通用、更可扩展 | Transformer 替换 U-Net,在潜空间 patch 上统一去噪;以 3D 因果 VAE 做时空压缩 | DiT(2022)、Sora、CogVideoX、HunyuanVideo、Wan | 可扩展性强(Gflops 越大质量越好)、原生支持多分辨率与宽高比 | 算力需求最大,训练与推理成本高 |
| 模型 | 年份 | 核心机制要点 |
|---|---|---|
| Sora | 2024 | 时空小块(spacetime patch)+ DiT;在视频压缩网络的潜空间里训练与生成;以"原生尺寸"训练而非裁剪缩放 |
| CogVideoX | 2024(ICLR 2025) | 3D 因果 VAE(压缩比 4×8×8)+ Expert Transformer;渐进训练与多分辨率帧打包 |
| HunyuanVideo | 2024 | 参数量 13B+;CausalConv3D 的 3D VAE(时间 4×/空间 8×/通道 16×);DiT 全注意力 +"双流→单流"混合设计;用多模态大模型替代传统文本编码器 |
| Wan 2.1 | 2025 | 流匹配;Wan-VAE(3D 因果 VAE,步长 4×8×8,潜通道 16,可对 1080P 长视频编解码);DiT 用全时空注意力(双向非因果) |
| Wan 2.2 | 2025 | 视频扩散引入混合专家(MoE):高噪声专家管布局、低噪声专家管细节,按信噪比阈值切换;总计 27B、每步激活 14B;某小型版本在单张 24GB 显卡上 9 分钟生成 5 秒 720p@24fps |
| HunyuanVideo 1.5 | 2025-11 | 轻量化 8.3B;SSTA 稀疏注意力;480p/720p 推理、超分至 1080p;默认 121 帧;不含音频;最低 14GB 显存(开启卸载) |
表 3-3 里藏着一个对你有直接影响的细节:HunyuanVideo 1.5 的"最低 14GB 显存"与"默认 121 帧"。这是开源模型的路线——权重开放、可本地部署,代价是你得自己准备硬件、自己调参数;而网页版工具把这一切藏起来,你只看得到"档位"和"排队时间"。两条路的取舍很清楚:要"可控与免费",去本地部署;要"省事与稳定",用网页工具。本书的实操以网页工具为主,但你应该知道本地生态的存在——它是"工具会涨价、会关停"时的退路(3.7 节会讲一个真实的关停案例)。
算力不够怎么办:四类"降本"手段
三条路线都指向同一个现实:算力是瓶颈。学界与工业界围绕"怎么在有限的算力里生成更好的视频"做了大量工作,可归纳为四类,它们也解释了为什么近两年"同样时长、同样分辨率"的等待时间在缓慢下降:
- 潜空间压缩。3D 因果 VAE 在时间维上再压 4 倍(空间 8 倍),等于把立方体的"格子数"直接砍掉一截。这相当于视频编码里的"帧间差分"思路:相邻帧相似的部分不必重复存储。
- 稀疏注意力。Sparse VideoGen(ICML 2025)提出一种免训练方案:在线判断每个注意力头是"空间头"还是"时间头",只保留必要的注意力连接,在 CogVideoX-v1.5 上最高实现 2.28×、在 HunyuanVideo 上最高 2.33× 的端到端加速,且不损伤质量。
- 蒸馏加速。CausVid(CVPR 2025)把一个 50 步的双向模型蒸馏成 4 步的自回归生成器,单卡实现 9.4 FPS 的流式生成;后续的 Self-Forcing 改为"训练时就自回归 rollout + 滚动缓存",把"无限长生成"变成可能。
- 分块与并行。把大矩阵拆成瓦片分块推理,把序列切段交给多卡(Ring Attention、Ulysses 等序列并行方案),再配合 token 级裁剪——这是"用工程换算力"的常规操作。
你可能会想:时间维压缩 4 倍,会不会把"动"这件事也压没了?其实不会——关键在于压缩的是冗余。相邻两帧 95% 的内容是一样的(背景、光影、色块),真正变化的只是"动"的那一小块。3D 因果 VAE 做的事情,可以类比成视频文件格式里的帧间预测:只记录"这一帧相对上一帧变了什么",而不是把每一帧都完整存一遍。
"因果"(causal)两个字也很关键:它意味着压缩时只看过去、不看未来——第 t 帧的表示只能依赖 1..t 帧,不能偷看第 t+1 帧。这个约束让模型可以流式地生成(一边拍一边压),代价是表达能力略受限制。这也是"全局去噪"与"自回归生成"两种范式的分野所在:前者一致性最好但长度固定,后者可以无限长但会漂移(3.3 节细说)。
3.3时间一致性:为什么"误差"会自己长大
现在把镜头拉近到本章最核心的难点。小舟那段"月亮抖了一下、江面被揉皱"的视频,专业术语叫时间一致性(temporal consistency)出了问题。权威综述《Spatiotemporal Consistency in Video Generation: A Survey》把这件事形式化成"在时空分布上做序列采样",并把它拆成两个层面:
- 空间一致性:同一个东西在画面的不同位置、不同方位上看起来还是"同一个东西"——身份、布局、风格、光照都稳定。
- 时间一致性:运动平滑、状态转移合法、闪烁少、动作语义忠实——前一秒发生的事,与后一秒发生的事在逻辑与物理上接得上。
综述给出的三条根源非常值得抄进你的笔记:局部误差会累积、长程依赖计算昂贵、单帧质量好不等于动态连贯。翻译成创作现场的语言就是:你可以把每一帧都做得很好看,但错误会像滚雪球一样长大,而要盯着"很久以前的那一帧"保持不偏,代价又高得离谱。
两种典型的"时间崩溃":闪烁与漂移
时间一致性问题在作品里的表现,主要分成两类,它们的症状与成因都不一样,处方自然也完全不同。
第一类:闪烁(flicker)。亮度像有人在打信号灯一样忽明忽暗、纹理像水波一样翻动、边缘持续振动、背景帧间突跳。它的成因有四条,都值得你知道名字:其一,VAE 潜时间边界的解码跳变——分块生成时,块与块的交界处缺少真实的"过去上下文",解码出来就会突跳(有研究甚至用"潜边界处的像素差异"来度量它);其二,训练与推理时的噪声/信噪比分布不一致(FreeInit 论文指出,初始噪声的时间一致性差,根源在此);其三,目标本身的冲突——细节合成鼓励帧间像素大幅变化,一致性又要求约束这些变化,因此一致性机制容易"用力过猛",把画面搞得过度平滑;其四,自注意力缺少时序平滑的归纳偏置——一个可量化的观察是:不连贯的视频,其自注意力图的"时间对角线"呈不规则、碎片化形态;稳定运动的视频则对应平滑的带状对角线。
第二类:漂移(drift)。开头几秒还很正常,越往后画面越"不对劲":颜色偏了、光线变了、人物的脸像被慢慢溶掉、场景不再是原来那个场景。成因同样有三条:其一,因果或流式生成中的误差累积——注意力感受野有限,小预测误差随时间传播,内容逐渐偏离全局上下文(有工作用"让参考图跑在前面当'伪最后一帧'"的办法提供持续的锚点);其二,位置编码越界与频谱能量漂移——帧号变大后,与锚帧的距离超出了模型预训练时见过的范围;其三,自回归的暴露偏差(exposure bias)——训练时模型看到的是"真实历史帧",推理时看到的却是"自己生成的帧",两者分布不一致,错误由此被逐步放大。
| 对比项 | 闪烁(flicker) | 漂移(drift) |
|---|---|---|
| 症状 | 亮度脉冲、纹理闪烁、边缘振动、背景帧间突跳;观看时"刺眼、像信号不良" | 开头正常、越往后越偏;颜色光线变化、人物面部逐渐溶解、场景不再是原来那个场景 |
| 时间尺度 | 帧与帧之间的高频抖动 | 数秒到数十秒的低频累积 |
| 成因(机制层) | VAE 潜时间边界解码跳变;训练-推理的噪声/信噪比分布差;"细节 vs 一致性"目标冲突;自注意力缺时序平滑偏置 | 因果或流式生成的误差累积与感受野受限;位置编码越界与频谱能量漂移;自回归的暴露偏差 |
| 提示词侧对策 | 钉死单一光源;每镜只允许一个镜头运动;负面词加 no flicker, no warping;放慢运动、缩短片段 | 缩短生成单元,靠剪辑而非一次性长生成;每次延长都"从最后帧自然延续";用参考图重新锚定身份 |
| 后处理侧对策 | 降闪烁(deflicker)、稳定化处理;必要时重生成该片段 | 重新生成后期片段并与前段做匹配;避免"末帧链式生成",改用参考生视频 |
把模型每一层的注意力图画出来,可以看成一张"词元 × 词元"的热力图。如果按帧顺序排列词元,那么"第 t 帧的某个位置"与"第 t+k 帧的同一位置"之间应该有稳定的关联——把这些关联画在图上,就是一条沿着时间方向的"对角线"。
观察发现:运动稳定的视频,这条对角线是平滑、连续的带状;不连贯的视频,它呈碎片化、断续的斑点。这给了一个很有价值的启示——连贯性问题不只是"像素层面看起来不对",它在模型的内部表示里就有清晰的痕迹。理解了这一点,你就明白为什么研究者常说"一致性要在大模型内部建模",而不是靠后期"修一修":出错的地方在表示层,补救的动作也必须在表示层。现在已有工作尝试用这类信号做质量检测与自动化筛选,未来很可能变成生成工具的"自动质检"功能。
更深一层:不止要"连贯",还要"正确"
时间一致性解决的只是"接得上",还有一层更难的要求:接得上是"对"的。月亮升起该慢慢来,落花该往下落,重物落水该有溅起的水花——这些常识叫物理规律。近两年,"视频生成模型是不是世界模拟器"成了整个行业最热的话题,因为它直接关系到"AI 视频能不能用来做严肃的内容"。
这场讨论有两组证据,都值得你完整地了解——只讲一半都会得出偏颇的结论。
对创作者的实践含义有三条。第一,别把精确物理交给模型:碰撞、碎裂、软体、液体的精细演出,要么改用实拍,要么走传统特效,要么用短片段 + 剪辑绕开——让模型去承担它做不到的事,就是给自己制造返工。第二,误差随帧数累积,所以"短片段拼接"胜过"一次性长生成":同样 20 秒的内容,四段 5 秒拼起来,往往比一次生成 20 秒更稳。第三,物理准确性不会随模型变大自动变好:评测显示更大的模型在"下落速度"上反而更慢——所以"换更强的模型"不总是解决方案,先看问题属于哪一类。补一句学术侧的好消息:有研究发现,只用约 100 段单球下落片段训练一个轻量适配模块,就能把某个 5B 模型的"等效重力"从 1.81 提升到 6.43 m/s²(约地球的 65%),并且能零样本泛化到双球与斜面场景——"物理直觉"是可以被低成本补强的,这为将来的工具留下了想象空间。
3.4让画面自己"出声":音视频联合生成
2025 年 5 月 20 日,Google 在 I/O 大会上发布 Veo 3,官方博客的原话是它"首次能够生成带音频的视频",举的例子包括街道的交通噪声、公园的鸟鸣,甚至角色之间的对话;同段话里还有一句值得注意的表述——"在文本与图像提示、真实世界物理以及准确的口型同步上,Veo 3 都表现出色"。行业普遍把这一天视作"原生音频"的转折点。四个月后,OpenAI 发布 Sora 2(2025 年 9 月 30 日),宣布它可以生成与画面同步的对白与音效(初代 Sora 不能),并改进了物理真实感(动量、浮力、物体恒存),同时诚实地承认"改进了,但不完美"。
国内跟进得极快:可灵 4.0(2026 年 9 月底至 10 月)给出高品质双通道立体声与口型同步,覆盖中、英、日、韩、西班牙语等多语种及多种方言口音;MiniMax H3 提供双声道音频,多轨输出覆盖音乐、音效、配音,官方博客也坦承仍存在"偶发音频失真";字节的豆包 Seedance 2.0(2026 年 2 月 12 日发布)基于"统一多模态音视频联合生成架构",提供双声道音频,支持 15 秒高质量多镜头音视频输出。开源阵营同样热闹:Ovi 用"双塔 DiT + 分块跨模态融合"开源了 11B 权重,5 秒 24fps、720×720;百度的 NAVA 基于 Wan2.2 骨干做"先对齐再融合",这个 6.3B 的联合模型输出双声道音频(场景声与语音联合去噪,不需要事后用声码器对齐),在 8 卡并行下可生成 720p、约 1 分钟的素材;Lightricks 的 LTX-2.3 是 22B 的联合音视频基础模型,最高 4K/50fps/20 秒,权重开源。
为什么"让画面出声"这么难?因为它要求模型同时掌握两套完全不同的信号:画面是空间上高度结构化的二维网格,声音是在时间上一维流动的波形。把两者放进同一个生成过程,本质上是在解决一个"同步"问题——而这个同步有两种完全不同的做法。
不同工具对音频的支持差异极大,而且都写在参数里、不写在宣传语里:通义万相 3.0 的原生音频参数默认开启,且官方明确"开关声音的价格相同";Vidu 从 Q3 起支持背景音乐与音效参数,但默认关闭;腾讯混元视频 1.5 明确不含音频。Hailuo 的接口里还有"驱动音频"(driving audio)一类输入,可以让生成的口型跟着你给的一段音频走。
操作建议:先定"这一镜要不要出声",再选模型。要现场对白与音效的,选原生联合生成的模型;只要配乐与旁白的,第 1 章的 TTS 与音乐工具链更便宜也更可控。另外提醒一句:联合生成的音频仍然需要人工试听把关——厂商自己也承认存在"偶发音频失真"这类问题。
| 思路 | 做法 | 同步质量 | 工程复杂度 | 代表 |
|---|---|---|---|---|
| 共享潜空间+联合去噪 | 把画面潜表示与音频潜表示交错排进同一个序列,用单个 DiT 联合去噪,再联合解码 | 最高。同步是"学出来"的——模型在训练中学会了"这种画面配这种声音" | 最高,需要大规模音视频配对数据与联合训练 | Veo 3 类架构;Seedance 2.0 的统一多模态架构;可灵 4.0 双通道立体声 |
| 双塔+跨模态注意力 | 视频与音频各用一个塔(或各自的主干)建模,再通过跨模态注意力与共享位置编码交换信息 | 较高。两塔能力可独立迭代,融合层负责对齐 | 中等偏高,但比联合训练灵活 | Ovi(twin-DiT 分块融合,11B 开源);NAVA("先对齐再融合",6.3B,基于 Wan2.2 骨干) |
| 后配音(级联) | 先生成无声视频,再由音频生成模型"看着画面"配音配乐配效 | 较弱。同步靠事后对齐,语义耦合有限 | 最低,模块化、易替换 | 2025 年前的主流做法;今天的通用流程中仍广泛用于旁白与配乐 |
3.5条件控制:你想让它怎么动,就怎么"喂"它
原理讲完,进入你每天都在用的层面:怎么让模型生成你想要的画面与运动。这一节的内容,可以把第 1 章的"提示词四要素"与第 2 章的"参考图"两套本事合并升级——视频比图像多出一整套条件系统,因为除了"画面要什么",你还得交代"它怎么动"。
按"你给它什么"来分,视频生成的条件有五类:只给文字(文生视频)、给一张起始图(图生视频)、给首帧与尾帧(首尾帧插值)、给参考图或参考视频(主体与风格一致性)、给运动指令(轨迹、相机运动或运镜描述)。它们可以叠加,但注意:部分平台明确规定了某些条件是互斥的——例如万相 3.0 的文档写明"首帧/尾帧"与"参考图/参考视频/参考音频"不能混用;海螺同样规定首尾帧与参考类型互斥。选条件之前先看文档,能省掉一整轮无效生成。
文生视频与图生视频:先有锚,再谈动
文生视频(text-to-video)只给文字,是自由度最高的方式,也最适合环境、氛围、空镜这类"没有明确主角"的镜头。它的代价在第 2 章你已经体会过了:同一段提示词跑三次,可能得到三个不同的世界。视频版本更麻烦——不仅"世界"会变,连"变的方式"也会变。所以文生视频的正确定位是:用来探索与找感觉,而不是用来做需要接戏的镜头。
图生视频(image-to-video)是本书主线的主力做法:把第 2 章做好的分镜关键帧当作首帧传进去,再写"接下来发生什么"。好处立竿见影——身份、构图、色调都被这张图"钉"住了,模型要做的只是"让它动起来"。写提示词时有一条纪律务必记住:不要再重复描述图里已经明确的信息。你上传了模特图,就不必再写"白袍男子、长发束冠"——写了反而会与图"抢方向盘",这是第 2 章"两个事实来源打架"那条纪律在视频上的同一条延伸。图里已经有的,交给图;要变化的,才写进提示词。
两者配合的典型节奏是:文生视频找氛围,图生视频定成片。小舟的做法就是这样:先用文生视频生成 3–5 版"月升"的感觉,圈出最喜欢的那一种"运动气质",回到第 2 章的关键帧上用图生视频把镜头做实。
首尾帧插值:告诉模型"从哪来、到哪去"
图生视频只给起点,首尾帧(first/last frame)插值则把终点也定下来:你上传第一帧与最后一帧,让模型补齐中间的过程。这项能力在 2025 年前后集中落地——Luma 的 Ray2 在 2025 年 3 月上线时官方支持 Start/End Keyframes(同时上线延长与循环功能,5 秒可延伸至 30 秒),其 API 的关键帧对象既接受图像,也接受"某次生成的编号";可灵提供 first_frame 与 end_frame 参数,但不支持只给尾帧,且首尾帧模式会自动继承输入图的比例;通义万相 3.0 则同时提供首帧与尾帧参数,并在文档里注明它与参考素材类条件互斥。
时长方面要留意一个有教学价值的差别:首尾帧模式往往有独立的时长限制。可灵某版本接口的时长枚举为 3–10 秒,而文生与首帧图生只支持 5 秒与 10 秒;万相 2.2 的首尾帧接口更严格——时长固定为 5 秒,不可修改。这就是为什么"单次时长"和"累计上限"必须分开看:同一个平台里,不同模式的上限都不一样。
首尾帧的官方提示词写法有一个很实用的模板(可灵用户指南的例子):"Take [@Image1] as the start frame, take [@Image2] as the end frame, [然后描述变化]"。这个模板揭示的正是首尾帧的核心逻辑:首尾两帧定义"边界条件",提示词只负责描述"中间该怎么走"。此外,官方的已知局限也要记牢:起止两帧差异过大时,模型会自行编造过渡,且不一定与你的意图一致;因此首尾帧最擅长的是"几秒钟的主镜头运动",而不是"跨越两个场景的大跳变"。
参考图与主体一致性:把"是谁"交给图
如果你要把同一个角色放进多个镜头,参考图就是最重要的条件。第 2 章已经建立了"参考图解决'长得像'、提示词负责'在做什么'"的分工,视频侧只是把它变成一套更复杂的参考素材系统:
- 可灵 Elements(元素):每个"元素"至少需要 2 张参考图(1 张主图 + 补充图),最多 4 张;接口上对应主图与补充图两个字段。使用时在提示词里用
@Element1这样的语义标签引用,形成"参考图—语义标签"的绑定——这一点很有用:它让你能像写剧本一样写提示词("@Element1 抬头望向月亮"),而不用反复描述长相。Elements 不限于人物,动物、道具、服装、场景都可以。数量上限方面,某版本接口规定:有参考视频时参考图不超过 4 张,无参考视频时不超过 7 张;参考主体最多 3 个;首尾帧模式下仅部分模型支持 Elements。 - Vidu 的参考生视频:多数模型的参考图数量为 1~7 张;其中
viduq2-pro还能混传视频(此时图片降为 1~4 张、视频 1~2 个)。它还提供面向行业的专用模型(广告、剧情、混剪),本质是把"参考素材的使用方式"预设成了模板。 - 万相 3.0 的参考体系:参考图最多 10 张、参考视频最多 5 段(总时长不超过 15 秒)、参考音频最多 5 段(总时长不超过 15 秒),可自由组合;提示词里用"图1""视频1""音频1"来标注对应的素材。
你可能会好奇:模型是怎么做到"看了两张照片就能在视频里保持这张脸"的?公开资料能给到的诚实答案是有限的:可灵团队在访谈中提到,人物特征的保持来自模型内置的指令理解——先把照片中的关键特征解析出来,再把这些特征注入视频生成任务。至于参考编码网络的具体结构与细节,公开资料并未披露。
本书的态度是:把结论留在能证实的层面。你知道"参考图会被编码成某种条件、注入生成过程"就够了(第 2 章讲的三种条件注入方式——通道拼接、交叉注意力、自适应归一化——在这里通用);至于"第几层注入、用了多少维向量"这类细节,不要凭空推测,更不要写进你的技术说明里。这是学术诚信的一部分,也是 3.13 节思政要展开的话题。
运动控制:让镜头"按你说的走"
比"是谁"更难控制的是"怎么动"。学术上主要有三条思路:
- 相机与物体解耦控制。MotionCtrl(SIGGRAPH 2024)在既有视频模型上加了两个适配模块:一个负责把相机位姿序列"时间性地"注入(CMCM),另一个负责把物体的逐帧位置"空间性地"注入卷积层(OMCM),从而实现相机运动与物体运动的解耦——这在创作上意义很大:你想要"镜头绕圈、人不动"和"镜头不动、人走动"是两种完全不同的效果。
- 位姿参数编码。CameraCtrl 是即插即用的相机位姿控制模块,它的关键设计是用 Plücker 嵌入(每个像素 6 维)来表达光线方向,而不是直接把相机参数喂给模型——原因是旋转矩阵有正交约束、平移尺度又无界,直接学容易"失配"。相机特征还会与图像潜特征逐像素相加,注入到每个时间注意力模块的第一层。
- 轨迹控制。DragNUWA 允许文本、图像、轨迹三种输入同时使用,从语义、空间、时间三个视角做细粒度控制;Tora(CVPR 2025,阿里)是首个轨迹导向的 DiT 框架,它的做法是把轨迹转成帧间位移图、编码成分层的时空运动 patch,再用自适应归一化注入并"零初始化",以最小代价保留底座能力,支持到 204 帧、720p。
上面那些是研究层面的机制。落到你手上的网页工具,多数并不暴露相机位姿参数——你能用的只有两条路:用提示词术语描述运镜,或者上传一段参考视频让模型复刻它的运镜(例如即梦的参考视频控制就明确可以传递运镜速度、人物轨迹、动作编排、多人交互)。理解了这一层,你就不会在界面上白找"相机角度"的滑块了——在当下的工具里,运镜主要是"写出来"或"示范出来"的,而不是"设出来"的。
把镜头语言翻译成提示词:第 1 章的"分镜表"到这里才真正落地
第 1 章做分镜时,你已经在每个镜头后面标注过景别与机位运动;第 2 章把它们写进了画面任务表。现在到了关键时刻:这些标注要变成模型听得懂的句子。这一小节是全章最具"手艺"的部分——它决定了你的镜头是"有导演感",还是"像一张会动的图片"。
先复习三个基础概念,它们决定了你的镜头能不能"接得上"。景别指被摄主体在画面里呈现的范围大小,以正常成年人为参照分为远景、全景、中景、近景、特写五个基本档(另有更细的大远景、大特写)。决定景别的是"机位与主体的距离"和"镜头焦距"两个因素——它是相对概念,不是绝对刻度。其中中景被称为"万能镜头",因为它既能看到环境又能看到人的活动,与任何景别相接都不突兀;而远景与特写这两个"两极镜头"一般不能直接相接,不符合人眼看东西的规律。轴线则是被摄对象的视线方向、运动方向与彼此关系所形成的一条假定的直线;拍摄时机位要在轴线同一侧(180 度内),否则就会出现"越轴",造成方向与空间的混乱。越轴不是绝对禁忌——不少导演有意越轴以制造特殊效果(黑泽明《罗生门》的奔跑段落就是经典例子),但那是"故意为之",不是"不小心为之"。
更重要的是四条"组接硬规则",它们同样适用于 AI 生成的多镜头序列:
- 景别级差原则。相邻两个镜头的景别要有明显区别,一般保持两档以上。可以把层级写成:远景(1) ‹ 全景(2) ‹ 中景(3) ‹ 近景(4) ‹ 特写(5)。相同景别、角度变化又小于 30 度,必须回去改分镜;跨两级以上则允许、无角度限制。
- 30 度原则。切换同一场景的不同机位时,前后两个镜头的拍摄角度差应大于 30 度。角度差太小,观众感知到的不是"换了个机位",而是画面在"跳"(跳切感)。
- 180 度轴线规则。不要越轴。这条在 AI 生成里比实拍更容易被违反——因为每一镜都是独立生成的,模型并不知道你上一镜把摄影机放在了哪一侧。
- 运动衔接规则。静接静(内容连续、逻辑成立);动接静(运动趋于趋缓时才可组接);动接动(运动方向不能相反——推镜头不能接拉镜头,否则会"跳")。此外还要留意视觉重心(主体在画面中的位置)的衔接。
于是出现了一件很实际的事:这些规则必须在"写提示词之前"就写进分镜表,而不是等生成完再回头修补。小舟在主线上给每一镜加了两个新字段——"上一镜景别 / 本镜景别"与"机位在哪一侧",就是为了避免"两条相邻镜头都是远景、角度还一样"这种一到剪辑台才发现的事故。
接下来是运镜本身。九种基本运镜的写法与用途,请看下面这张九宫格——建议你把它打印出来贴在工位上,写提示词时对照着抄。
| 方式 | 你给什么 | 模型补什么 | 平台与参数 | 适用与坑 |
|---|---|---|---|---|
| 文生视频 | 一段描述画面与运动的文字 | 全部内容:主体、场景、运动、光线 | 几乎所有工具都支持;通常写在提示词框,配比例、时长、分辨率档位 | 适合氛围、空镜与探索;主体不稳定,不适合需要接戏的角色镜头 |
| 图生视频(首帧) | 一张起始图 + 描述"接下来发生什么" | 时间的展开:运动、后续画面 | 可灵、即梦、海螺、Vidu、万相等均支持;首帧就是输入图 | 主线主力做法;不要在提示词里重复描述图里已有的信息 |
| 首尾帧插值 | 首帧 + 尾帧 + 中间过程描述 | 中间的过渡过程 | 可灵(不支持仅尾帧,自动继承输入图比例);万相(与参考素材互斥);Luma 的 Start/End Keyframes | 适合几秒钟的主镜头运动与状态变化;两帧差异过大时模型自行编造过渡;注意部分接口时长固定 |
| 参考图 / 主体一致性 | 1–10 张参考图(视平台) | 把主体长相与风格锚定下来 | 可灵 Elements(每元素 2–4 张,提示词用 @Element1 引用);Vidu 参考生视频(多数 1–7 张);万相(参考图 ≤10、参考视频 ≤5、参考音频 ≤5) | 多镜头项目的必需品;参考图要"同场次同光线",避免一张微笑一张中性 |
| 参考视频 | 一段参考视频(+ 参考图) | 复刻其运镜速度、人物轨迹、动作编排、多人交互 | 即梦的参考视频控制;Vidu 某版本可混传 1–2 段视频(此时图片降为 1–4 张) | 解决"说不清的运镜";注意参考视频与参考图数量会互相挤占配额 |
| 运动控制 | 轨迹、相机运动,或用文字描述运镜 | 按指定路径与方向运动 | 网页工具以提示词描述或参考视频复刻为主;研究侧有轨迹与位姿控制(Tora、CameraCtrl 等) | 轨迹近邻或交叠时容易"串轨";运镜描述遵循"每镜一个主要运动" |
把上面这些落成一句可执行的话,就是视频版的提示词通用公式(多家官方文档的写法高度一致):
还有一种更"导演化"的写法值得单独学,来自一份厂方实战手册:起幅 → 运动 → 主体关系 → 落幅 → 目的。它把"这个镜头为什么存在"也写进了提示词里(Starting Frame + Subject Action + Camera Path + Speed + Subject Relationship + Lens + Occlusion + Ending Frame + Story Purpose)。它的价值在于强迫你想清楚"落幅"——如果不写落幅,模型不知道镜头该停在哪里:只写"环绕镜头",模型可能绕到一半就结束;写成"顺时针 120 度环绕角色,固定半径约 1.5 米,结束于四分之三特写",你才拿到一个能接下一镜的镜头。
| 纪律 | 反例 | 正例 / 替代做法 |
|---|---|---|
| 一个镜头只用一个主要运动 + 一个速度词 | "快速推近的同时环绕并升镜"——叠加 pan + orbit + crane,几乎必然产生不稳定运动 | "镜头缓慢推近,从中景推进至面部特写" |
| 术语不够,要描述画面变化 | 只写"希区柯克变焦"——模型认识这个词,但不一定能复现你想要的效果 | 把稀有术语翻译成"屏幕上可观察到的结果",如"从前景树叶平滑变焦到背景人物" |
| 专业电影术语一两个即可 | 一句话堆进五个术语,模型"抓不住重点" | 术语 + 一句白话解释;需要堆叠时拆成两个镜头 |
| 必须写落幅 | 只写"环绕镜头"——模型不知道镜头停在哪里 | "顺时针 120 度环绕角色,固定半径约 1.5 米,结束于四分之三特写" |
| 必须写镜头与主体的关系 | 只描述主体,不交代镜头相对主体的位置与距离 | "与跑步者同速侧面跟拍,保持全身侧面轮廓" |
| 只描述内容、不写运镜指令 | "月夜,江面,一轮明月"——没有运动信息 | 补上"镜头缓慢推近、明月自潮水升起"——否则结果会"像动态 PPT" |
最后补一句"稳定声明"的技巧:万相 3.0 的官方提示词指南把"负向清单"列为提示词结构的一环,你可以照抄这个模板——no text overlay, no watermark, no flicker, no warping, no extra fingers, no duplicate characters;也可以在提示词末尾写一句稳定性声明:"无闪烁、无重影、无抖动,运镜平稳无晃动"。它不能包治百病,但成本为零,值得养成习惯。
背景:主线短片《春江花月夜》的第一个镜头是"月升·潮水"(对应第 2 章的 K1)。小舟手里已经有 K1 的分镜图,但她想先做个对照实验:既然文生视频更自由,会不会比图生视频更好看?
做法:她用同一段提示词(就是上面 V1 那张提示词卡片的正文)跑两组:A 组是纯文生视频,只给文字;B 组是图生视频,把 K1 当首帧。两组各生成 3 次,参数(时长 5 秒、比例 16:9、分辨率一档到底)保持一致——严格遵守"一次只改一个变量"。评估维度是她自己定的三条:① 与分镜表的一致性(构图、色调、意象);② 运动是否合理(江水流向、月亮升降方向);③ 有没有闪烁或形变。
结果:A 组的 3 版都很"漂亮",但三版的构图与色调各不相同,其中一版把月亮放到了画面正中、一版的雾气浓得像火灾现场——与分镜表的"江面占三分之二、月亮贴水升起"对不上;三次里只有一次运动方向是合理的(潮水向内、月亮上升)。B 组的三版构图全部贴合分镜图,色调统一,只有一版在第二秒出现了江面纹理的轻微闪烁。整体判断:B 组 2 次可用,A 组 1 次勉强可用。
复盘:①文生视频适合"找感觉",图生视频适合"做镜头"——这个结论在主线上被反复验证;②图生视频并没有消灭失败,它只是把失败的概率从"构图跑偏"降级成了"运动小瑕疵",而后者往往可以用"缩短到 4 秒重生成"或后处理解决;③这次对照还留下了一份副产物:小舟把 A 组里"运动气质最好"的那一版的提示词片段("潮水向内涌、月亮缓慢上升")抄进了 B 组的提示词,命中率进一步提高——文生视频是"素材库",图生视频是"装配线"。
3.6参数语义:为什么你的"中等运动"不是我的"中等运动"
第 2 章里你已经体会过图像生成的"参数陷阱":同一句话里的"高分辨率",在不同工具里含义可能完全不同。视频参数把这件事放大了一整个维度——因为多出来的时间维,让每个参数都在同时影响内容、运动、时长、成本四件事。这一节的目标不是让你背参数值(它们半年就会过期),而是让你掌握一套跨平台通用的"参数阅读法"。
先记住三条总则,它们是本节全部内容的压缩包:
- 量纲不可比。同一个"运动强度",在一个平台是 0–10 的整数,在另一个平台是 0–1 的小数,还有平台把它与另一个参数联动。跨平台直接抄参数值,等于"用一个尺子上的读数去另一个尺子上划线"。
- 参数互相耦合。时长、分辨率、运动幅度、稳定性、成本这五个变量互相拉扯,"全都要"是不存在的——每次调参本质上是一次取舍。
- 一次只改一个变量。做对照实验时,其余参数全部锁死,否则你无法把结果归因到任何单个参数上。这是本课程实践环节的纪律,也是所有实验科学的基本功。
运动幅度:同一个词,几把不同的尺子
"运动幅度"(也叫运动强度、运动量)控制画面里"动多少"。它是视频独有的参数,也是最能体现"量纲不可比"的典型。下表把几种常见口径并排放——请特别注意量程一列的差异:
| 平台 / 模型 | 参数名 | 量程 | 参考区间(社区经验,以自己实测为准) |
|---|---|---|---|
| Wan 2.2 图生视频(A14B) | motion_magnitude | 0–10 | 1–2 几乎不动;3–4 眨眼、微笑、树叶飘动;5–6 转头、手势、云朵流动;7–8 走动、转身、波浪起伏;9–10 剧烈动作 |
| Wan 2.2 文生视频(A5B) | motion_strength | 0–1 | 静态场景 0.2–0.4;产品展示 0.4–0.6;快速动作(体育、舞蹈)0.7–0.9 |
| Open-Sora | Motion Strength | — | 与 Aesthetic、Camera Motion 并列的推理选项,按官方推理脚本调整 |
| Seedance 系列(第三方调优口径) | motion_strength + focus | 两个参数联动 | 有第三方文章给出过具体组合值,本教材不引用数值——只记住"它是联动参数"这件事 |
说明:参数名与量程来自各模型的参数文档;各档位"对应什么画面变化"属于社区整理的经验口径(凡具体数值都应视为"参考"而非"规格"),不同模型版本之间会漂移。写作业时,应当翻你所用平台的官方文档确认量程,再以自己的实测记录为准——"会查官方文档"本身就是本章要培养的一项能力。
比背数值更耐用的是四条定性规律,它们跨平台成立,且有厂商知识库或论文级依据:
- "运动预算(motion budget)"经验法则。要求多轴同时运动(例如"快速变焦 + 俯仰"同时进行)几乎必然产生特征扭曲;其中垂直俯仰对细长特征的拉伸尤其严重——这也是为什么人像怕俯仰、楼宇怕升降的原因之一。每个镜头都有一个看不见的"运动预算",花超了就要以形变偿付。
- 速度突变诱发形变。NeurIPS 的一篇论文明确指出:突然的速度变化(abrupt velocity changes)"通常会诱发形变伪影(morphing artifacts)"。所以提示词里写"由慢突然加速"是个危险的愿望,写"匀速渐缓"才是安全区。
- 主体运动幅度不要超过画面宽度的四分之一。大跨度位移会让中间帧"碎掉"——运动幅度越大,模型要在帧与帧之间补的内容越多,失败概率越高。想让主体大幅移动,正确做法是用剪辑切分两次小位移,而不是一次大位移。
- 人像比风景更脆弱。面部结构的容错度远低于景物纹理:人像镜头建议更低的运动档位、更短的动作链;风景可以适当调高,"风、水、云"这类纹理运动对形变的宽容度更高。
这四条合起来,就是本课程对运动参数的"操作顺序":先定"这一镜需要多少运动",再选略低于直觉的档位,最后检查有没有多轴叠加。宁可让模型欠一点运动(后期可以补帧加速),也不要让它超支(后期救不回来)。
时长:视频的时长是"拼接出来的",不是"生成出来的"
这是本章最值得刻进脑子的一句话。你看到的所有"1 分钟 AI 视频",都不是一次生成出来的,而是若干 5–10 秒片段(加上若干次延长)剪出来的。为什么单次生成撑不长?四条原因各自独立、叠加作用:
- 注意力窗口与误差累积。超过约 8–10 秒,模型难以维持跨帧一致性,脸、光、动作开始漂移——这正是我们在 3.3 节讲过的误差累积机制在时长尺度上的表现。
- 算力与显存的非线性增长。10 秒 24fps 就是 240 帧;要让第 N 帧与前 N−1 帧都保持一致,代价近似平方增长。有测算称,15 秒 1080p 的 Seedance 2.0 单次渲染可达约 20 分钟(二级来源,仅作量级参考)。
- 长视频训练数据稀缺。高质量、长时长、少剪辑、主体一致的连续视频素材很难找——模型只在训练分布内可靠,分布的边界就是"长度墙"的位置。
- 产品与资源约束。成本、等待时间、内容审核共同推动平台限长;高峰时段甚至可能触发轻量推理分支,导致高频细节丢失。
所以教材给出的实践建议是:把 4–10 秒当作"基本生成单元",把长视频视为"用剪辑与延长拼起来的作品"。这也解释了你马上会在工具表里看到的一个现象——各平台的"单次时长"是 2 秒到 30 秒不等,但"累计上限"能到 2–5 分钟:单次时长是模型的物理限制,累计时长是产品的工程拼接。两者不是一个量纲的东西,永远要分列。
那延长到什么时候该停?下面这组经验数据(二级来源的口径)值得记住,它描绘了一条"衰减链":
还有一条更微妙的规律叫叙事密度上限:一份基于 MiniMax H3 的边界样本测试认为,10 秒最多大约容纳 5 个事件节拍,再往上加就明显"赶戏"。它提醒你:时长参数不只是技术问题,还是"信息设计"问题——不要试图在一个片段里塞进一段完整的故事,那是剪辑的工作。
「参数是各自独立的旋钮:想要 4K 就选 4K,想要 6 秒就选 6 秒,怎么组合是我的自由。」
按这个直觉,你自然会想做一个实验:固定其他条件,比较"5 秒和 8 秒哪个更清晰"。
Veo 3.1(Google 官方文档):时长有 4 / 6 / 8 秒三档,但 1080p 与 4K 只支持 8 秒——想要高分辨率,就必须同时接受最长的那一档。
万相 3.0(阿里云官方文档):一旦给了输入视频,规则变成「输入视频总时长 + 输出视频时长 ≤ 30 秒」——延长不是"再加 30 秒",而是从同一个总账里扣。
这两个例子指向同一件事:参数不是独立旋钮,而是成组出售的档位。于是"5 秒和 8 秒谁更清晰"这个问题,在 Veo 3.1 上连实验都做不出来——你无法在相同分辨率下同时拿到两个时长。
这就是本节的真正结论,也是这一章最该带走的习惯:参数之间的关系不是"越长越差"或"越大越好"的单向曲线,而是一张到处是耦合的网。所以下结论之前要做两步:先问「这两个条件能不能在同一组参数下比较」(做不出实验的对比,只是猜测);能比较时,再严格只改一个变量——这与第 2 章那两组实测对照图(同种子、单变量)是同一套纪律。要练的不是记住结论,而是"控制变量再下结论"这个动作。
分辨率与等待时间:时间墙,还是显存墙?
视频的分辨率参数和图像一样写着 720P / 1080P / 2K / 4K,但代价结构完全不同:分辨率抬高时,潜空间序列长度随"宽×高×帧数"增长,而自注意力是 O(n²)——1080P 拉到 4K,序列长度变 4 倍、注意力计算量约变 16 倍。五款主流文生视频模型的实测口径是:把 1080P 配置直接拉到 4K,推理速度平均下降约 85%,显存占用平均上升约 3.7 倍。单卡速度律可以记成:端到端耗时 ≈ 固定项 + 步数 × 单步成本,其中单步成本大致正比于(宽×高×帧数)的 1.5 次方;因此提速的优先顺序是"先降分辨率 → 再降步数 → 最后才动注意力内核"。在 Wan2.2-A14B 的实测中,序列长度约 12 万 token 时,自注意力占了单步 DiT 延迟的 80% 以上,显存峰值容易冲过 30GB 而 OOM。
在消费级显卡上,这些规律会直接撞上一堵墙,下面是几组可引用的实测(二级来源,作为"量级感"使用):
| 配置 | 硬件 | 耗时 | 峰值显存 |
|---|---|---|---|
| LTX-2.3,97 帧(约 4 秒,带音频)768×512 | RTX 5090 | 约 43.5 秒 | 24.2 GB |
| 同上,1280×704 | RTX 5090 | 约 49.8 秒 | 24.2 GB |
| MiniMax H3,5.9 秒 25 步 | RTX 4090 24GB | 562 秒 | — |
| 同上,8 步 LoRA + int8 量化 | RTX 4090 24GB | 约 115 秒(提速 4.9×) | — |
| H3,4K 5 秒 | RTX 4090 24GB | 约 11 分钟 | 单个 1472×896 分块 |
但这里要放一个重要反例,它才是这一节最值钱的知识点:如果整条管线的瓶颈在解码/编码环节而非扩散模型本身,那么"分辨率越高越慢"就不成立。LTX-2.3 在 RTX 5090 上的一份实测显示:约 43.5 秒的总耗时里,约 35 秒花在 VAE 解码与 mp4/AAC 编码,DiT 本身只占约 5 秒——因此把像素数提高 2.5 倍(768×512 → 1280×704),总时间只多出约 14%。同理,图像生成侧也有实测佐证:512/1024/1536/2048 四档分辨率的生成耗时约 0.83/3.18/9.99/23.36 秒,呈超线性(注意力随像素数平方增长),而显存只从约 20.4GB 涨到 28.8GB——被总结为"时间墙,不是显存墙";而步数的影响则是精确线性的。
把这两组事实合起来,你就得到了一条比"越高越慢"精确得多的判断法则:"更贵"的到底是谁——是扩散计算,还是编解码?先测量,再优化。对网页版工具的用户来说,还有一个现实提醒:平台的等待时间与可选项由平台调度决定,你看不到显存这一层,能观察到的只有"档位"和"排队时长"——所以"显存"是给本地部署(开源模型)的学生准备的概念,不是网页版的操作参数。
种子:可复现的"随机"
扩散模型的每次生成都从一份随机噪声出发,随机数由种子(seed)决定。原理一句话:相同种子 + 相同输入 = 相同输出;种子留空则每次随机。听起来简单,但它的适用边界必须写清楚:
- 正用法。① 找到喜欢的效果后记录种子值——这是你能"重放"一次成功的最小凭据;② 批量生成时给不同种子,用最少的次数获得最多样的候选(这就是"多抽几张再挑"的成本最优解);③ 做参数对照实验时固定种子,让唯一的变化来自你要测试的那个参数。
- 边界一:平台差异。种子只在本地部署或 API 调用时才稳定可控;多数网页版工具根本不暴露种子——这也是"想做可复现实验的同学应该学一点 API 调用"的原因。
- 边界二:版本漂移。固定种子通常只在同模型、同版本、同参数、同平台下有效;模型一升级,种子就可能失效。你的实验记录里必须写上"平台 + 版本 + 种子"三件套,缺一样就不算可复现。
- 替代方案:"身份种子"。网页版用户拿不到数字种子,但可以拿一张干净的身份参考图当角色的 identity seed:一个角色只用一张清晰的设定图,在各个片段中反复复用。这样"复现"的对象就从"噪声"换成了"身份",同样能显著提高多镜头一致性。
顺便记住图像侧的一个佐证规律,它让你对参数成本的直觉更完整:在图像生成中,分辨率是超线性的(时间墙),步数是精确线性的——视频不过是把这两条规律乘以时间维,再叠加一个"帧间一致性"的新约束。
负面提示词与稳定性声明:零成本的"保险"
最后一组参数没有数字,却值得每次都用:负面清单与稳定性声明。万相 3.0 的官方提示词指南明确把"负向清单"列为提示词结构的一环,这是它区别于"可选技巧"的证据。教材给的模板是:
这一节到这里,参数语义的框架就齐了。请把三条总则再读一遍——它们也是你实践作业里"参数对照实验"的设计依据:锁变量、记全量(平台+版本+种子+一切非默认参数)、只改一个、多做几组。下一节我们换一个视角:从"参数"抬到"工具",看看 2026 年 10 月的工具地图长什么样、又该怎么选。
3.7工具地图:2026 年 10 月,你手里有什么牌
这一节的全部数据都带一个前缀:截至 2026 年 10 月。这不是客套——可灵在一年内走完了 3.0 → 3.0 Omni → 4.0 三个大版本,剪映 2026 年 9 月发布了 Hub,Adobe 2026 年 9 月在 IBC 发布了 Generative Media Tool。产品规格的半衰期大约是半年。所以本节的目标是"教你看地图的方法",而不是"背下这张地图":读表时请关注每一列背后的能力维度(单次时长 / 分辨率 / 成本口径 / 商用条款),这些维度在换代时相对稳定;具体的数字则以官方文档当场核对为准——"会查官方文档"是本章明确列为学习成果的一项能力。
先看离你最近的一排:国内可以直接访问的工具。
| 工具 | 版本节点 | 单次 / 累计时长 | 分辨率 | 成本口径 | 课堂关注的要点 |
|---|---|---|---|---|---|
| 可灵 AI(快手) | 4.0(2026-09-28 官宣);3.0 系列 2026-02-05 全球上线 | 4.0 单次 30 秒,配合续拍最长约 2 分钟;3.0 为 15 秒 | 4.0 报 4K 及 1080p 10-bit HDR、21:9;2026-04 起原生 4K 直出 | 免费每日 66 灵感值(带水印、成片不可商用);API 720P 约 0.9 元/秒、1080P 约 1.2 元/秒(含音频) | 功能最全的一站式:首尾帧、Elements 参考、运动控制、对口型、数字人、多镜头(≤6 分镜)、音画同步、续拍延长 |
| 即梦 AI(字节 / Seedance) | Seedance 2.5(2026-07-31 首发接入) | 单次 30 秒(原生长镜头);平台"超长生成模式"最长 3 分钟 | 4K(即梦官网口径) | 网页版积分制,官方仅称提供免费试用积分;API 约 $0.20/秒起(480p 档) | 原生音视频联合生成;多模态参考最多 50 项;R2V 参考视频可传递运镜速度、人物轨迹、动作编排;精准局部编辑;不支持上传含写实真人脸部的素材 |
| 海螺 Hailuo(MiniMax) | MiniMax H3(2026-07-31 发布、08-03 开源) | 4–15 秒整数 | 768P(标准)/ 2K(高清) | 官方订阅页:H3 2K 约 ¥0.53–0.78/秒、768P 约 ¥0.31–0.46/秒(按会员档);年会员低至约 ¥48/月 | 首尾帧、参考生视频(最多约 9 图+3 视频+3 音频)、音画一体、动作迁移;官方承认仍存在偶发音频失真等弱项 |
| Vidu(生数科技) | Q4 Preview(2026-10-07 发布) | 图生视频 3–16 秒;视频延长最长可至 5 分钟 | 540p / 720p / 1080p / 2K / 4K(2K、4K 为 10-bit) | Q4 首发优惠约 0.09 元/秒起 | 参考生视频最多约 15 张参考图+3 段参考音频;音画同步;注意:Q4 当前没有文生视频模式,只有图生与参考生视频 |
| 通义万相 视频(阿里) | 万相 3.0 | 最长 30 秒、30fps;有视频输入时"输入+输出总时长 ≤30 秒" | 默认 1080P,可选 720P / 480P | API:480P 约 0.3、720P 约 0.6、1080P 约 1.2 元/秒 | 文生、图生、首尾帧、参考生(≤10 图/≤5 视频/≤5 音频)、视频编辑与延长;原生音频默认开启且开关不加价;数字人接口 |
| 腾讯混元视频 | HunyuanVideo 1.5(2025-11 发布权重) | 默认 121 帧(约 10 秒 @720p 基准) | 480p / 720p 推理,超分至 1080p | 开源、免费(自备算力) | 无音频;最低约 14GB 显存(开启 offload)即可本地部署;许可有地域与规模条款(不适用欧盟/英国/韩国等,详见官方 LICENSE) |
| PixVerse(爱诗) | V6 / C10 / R2 | 官方未列单次上限(存疑) | V6 为 1080p+原生音频 | 官网称 API 约 $4.80/分钟(基准口径) | 角色一致性、对口型、动作模仿、超清;同平台也托管第三方模型 |
读这张表时请注意三件事。第一,"单次时长"与"累计上限"分列:Vidu 的单次是 16 秒,累计却能到 5 分钟——差出来的部分就是"延长 + 拼接"的工程量。第二,免费额度都附带条件:带水印、当日清零、不可商用几乎是国产工具免费档的"三件套",课堂练习可以用,参加比赛和商业发布前必须回到条款页确认。第三,商用条款是选型的一等公民:海螺的官方订阅页 FAQ 明确"付费会员期间生成并下载的内容可用于商业用途";而 Vidu 官方 FAQ 的口径是"是否可商用取决于版本与套餐"。做项目预算时先问"我能不能用",再问"贵不贵"。
再看国际阵营——多数在中国境内不能直接访问,但你仍需要了解它们,因为它们是"技术风向标",也是很多国产工具"对标表"的参照系。
| 工具 | 版本状态 | 单次 / 累计时长 | 分辨率 | 价格口径 | 标志性能力 |
|---|---|---|---|---|---|
| Sora(OpenAI)已停运 | 停运公告 2026-03-24;据 OpenAI 官方弃用清单,Sora 2 模型与 Videos API 于 2026-09-24 关闭(据维基百科,应用于 2026-04-26 停运,此条待官方核实) | 曾支持 16 / 20 秒,扩展最多 6 次、总长上限 120 秒 | 720p;1080p 需 sora-2-pro | 曾为 $0.10/秒(标准档) | 同步音频、可复用角色、Cameos;它的关停本身成为本章最重要的行业案例(见下文) |
| Veo(Google) | Veo 3.1(2025-10)+ Fast / Lite 档位 | 4 / 6 / 8 秒可选;1080p 与 4K 仅 8 秒;延长每次 +7 秒、最多 20 次,最长约 148 秒 | 720p / 1080p / 4K,24fps | Standard 约 $0.40/秒;Fast 720p 约 $0.10;Lite 720p 约 $0.05(含音频、无免费额度) | 原生音频常开、口型同步;首尾帧;参考图 Ingredients(≤3 张);所有 Veo 视频带 SynthID 水印 |
| Runway | Gen-4.5、Gen-4 Turbo、Aleph 2.0、Act-Two,并转售 19 个第三方模型 | 多数未公布;转售的 Seedance 2.5、WAN 3.0 为 30 秒 | 视模型而定 | 统一 credit $0.01/个:Gen-4.5 约 $0.12/秒、Aleph 2.0 约 $0.28/秒 | Aleph 2.0 的"上下文视频编辑"(关键帧引导、跨剪辑点编辑);遮罩擦除;动作捕捉 |
| Luma | Ray3.2(2026-06);Ray2 与 Dream Machine 已弃用 | 最长 20 秒 @1080p | 1080p;原生 16-bit HDR、可导出 EXR | Plus 约 $30/月、Pro 约 $90/月、Ultra 约 $300/月(含 credits) | 多关键帧最多 16 个;Master Reference(角色/产品一致性);无原生音频(音频靠第三方集成) |
| Kling 国际版(对照) | 与国内同源:3.0 / Omni、O1、4.0 | 3–15 秒;单次多镜头最多 6 个分镜 | 720P – 4K(30–60fps) | API 标准档约 $0.084/秒(无音频)/约 $0.126/秒(含音频) | 原生音频(多语言、方言)、动作控制(上传 3–30 秒参考视频迁移全身动作)、数字演员 |
| Midjourney | 视频模型 V1(2025-06) | 一次 4 段 5 秒;可延长 4 秒 × 最多 4 次 → 最长约 21 秒 | 各源不一(480p 为多数口径,存疑) | 需订阅;视频成本约为同尺寸图片的 8 倍 | 仅图生视频;Auto / Manual 两种运动模式;无音频 |
| Adobe Firefly / Premiere | 自有 Firefly 视频模型+聚合 Veo 3.1、Kling 3.0、Runway、Luma 等 | 自有模型 5 秒;多数模型最高 8 秒、部分 15 秒;Premiere Generative Extend 每次最多 +2 秒 | 自有模型 1080p;生成最高 4K | Firefly 订阅约 $9.99–$199.99/月分档 | 时间线内直接生成与延长;生成素材带 Content Credentials;明确不能生成或延长人声对白;自有模型有 IP 赔偿、合作模型没有 |
这张表里藏着 2026 年最重要的一条产业信号:头部阵营正在从"自研单一模型"转向"模型编排(orchestration)"。Luma 与 Runway 的官网都在转售别家模型(包括可灵、Seedance、WAN),Adobe 把 Google 与 Kling 的模型直接塞进了 Premiere 时间线,Pika 同样如此。对你的直接后果是:越来越难把一个效果归因于"某个模型",你能控制的其实是"工作流"——同一段提示词在哪几个平台跑、按什么顺序组合、用什么方式回到剪辑台。这也是本课程把 3.8 节"编辑与后期"排在工具表之后的原因。
2026 年 3 月 24 日,OpenAI 宣布关停 Sora 业务;据其官方弃用清单,Sora 2 模型与 Videos API 于 2026 年 9 月 24 日正式关闭,官方声明"没有一对一的替代 API(No one-to-one replacement API is available.)"。与之绑定的迪士尼 10 亿美元投资与三年角色授权合作也随之作废。媒体披露的关停经济学(二手口径):运行成本约 100 万美元/天(WSJ 转引),用户量从约 100 万峰值跌至不足 50 万,应用内总收入估算仅约 210 万美元。
这件事与"模型能力"无关——Sora 2 在发布时是公认的第一梯队。它说明的是:模型能力领先 ≠ 产品与生态可持续。转化为你的一条操作纪律:不要把作业与作品的流程"绑死"在任何一个模型上。素材(分镜图、参考图、提示词、种子记录)永远留在自己的硬盘与笔记里,工具只是随时可替换的一环——这也是教材把"导出与本地保存"写成作业硬性要求的原因。
那么面对这一桌子牌,怎么选?教材给一个"三问决策树"——它不问"哪个模型最强",只问"你的项目需要什么":
如果一定要给"性能排序",最可操作的客观依据是第三方横评榜——同一套题目、同一套盲测投票,Elo 分数可比。以下是 2026 年 10 月 9 日抓取的快照(仅摘录与课堂相关的前列与国产品牌):
| 榜单 | 前列模型(Elo) |
|---|---|
| 文生视频(含音频,v2.0) | 万相 3.0 第 1(1156);Seedance 2.5 第 3(1143);MiniMax H3 第 4(1137);可灵 3.0 Omni 1080p Pro 第 15(1015);Vidu Q3 Pro 第 25(941) |
| 图生视频(v1.0) | MiniMax H3 Max 第 1(1195);MiniMax H3 第 2(1181);Vidu Q4 Preview 第 3(1179,2026-10 新入榜);Seedance 2.0 720p 第 5(1176);万相 3.0 第 7(1164);可灵 3.0 1080p Pro 第 20(1055) |
| 视频编辑 | MiniMax H3 称"全球第一"(媒体转述官方口径);Seedance 2.5 第 2(1161) |
① 快照日期各不相同——2026 年 4 月、8 月、9 月的排名不可直接混用;② AA 的 Elo 与 VBench 的分数不可比——两套刻度体系不同,同一模型在两处差异可能很大;③ VBench 从未收录任何 Seedance 模型,回答不了 2026 年新模型的对比问题;④ 榜单是人类偏好投票,反映"好看"而非"物理正确"——请把它和 3.3 节 Physics-IQ 的结论对照着理解:观众觉得好看、模型却可能根本不懂物理,这两件事可以同时成立。
最后补一句关于"生命周期"的提醒。工具会消失:腾讯智影据百度百科口径已于 2025 年 6 月底暂停服务(2026 年是否恢复运营存疑),Sora 也走完了从万众瞩目到关停的全程——而这两个名字在网上至今仍有大量"教程"在流通。面对快速过期的世界,你的对策有三条:把"查官方文档"变成本能;把素材与记录存在自己手里;把核心能力练在"方法"(分镜、条件控制、参数实验、剪辑)而不是"按钮位置"上。方法迁移的成本是以天计的,而工具迁移的成本是以小时计的——先练方法,再玩工具。
3.8编辑与后期:把"抽卡"变成"作品"
生成只是原材料的采购。一部成片的诞生,走的是这条流水线:生成 → 筛选 → 编辑 → 配乐 → 导出。前面几节解决的是第一环节;这一节把后四个环节补齐——它们不仅是"技术活",更是你和"抽卡玩家"之间真正的分水岭:会生成的人很多,会让素材"听话"的人很少。
把这五个环节需要的能力集中起来,就得到下面这张"后期工具箱"。它按"你想做什么"来组织,每行都附上对应的工具示例与最关键的规则——规则栏里的内容,全部来自第五章失败模式的机制分析,是"用血换的"。
| 你想做什么 | 典型做法 | 工具示例 | 关键规则 / 坑 |
|---|---|---|---|
| 局部重绘:换掉画面里一个物体、修一处细节 | 圈出(遮罩)要改的区域,输入替换描述,其余保持不动 | 即梦"精准局部编辑"、可灵视频编辑(主体与背景增删改)、万相视频编辑、Runway Inpainting 与 Aleph 2.0、Luma Ray3 Modify | 遮罩外内容应当保持不变——生成后要专门检查"接缝帧";视频编辑(V2V)是文字渲染出错的主要场景,画面里的文字应在这一步之前就规划为"后期叠加" |
| 延长:把现有片段"接着拍"更长 | 以原片段尾帧为起点续写;或用"首尾帧模式"控制终点 | 可灵续拍、即梦"接着拍"、万相视频延长、Vidu(延长最长可至 5 分钟)、Premiere Generative Extend(每次最多 +2 秒) | 延长次数越多衰减越重(图 3-16);保护最后几帧、在提示词里请求"自然延续"而不是"新事件";不要在片段的第 1 帧处拼接——接缝后第 1 帧常是错误帧,可靠运动通常要到第三个重叠帧左右才出现 |
| 补帧与慢动作:让运动更平滑,或做升格效果 | 在帧与帧之间生成中间帧;慢动作 = 插帧 + 放慢播放 | 剪辑软件的速度曲线与插帧功能;超分提升清晰度:MiniMax H3 超分 2K/4K、混元超分网络 1080p、PixVerse 视频超清 | 慢放会放大闪烁与形变——帧间差异被放大后更显眼;更稳的做法是在生成端就写"慢速运动",把变速留给"锦上添花"而非"救场" |
| 对口型与数字人:让角色对上语音 | 输入人像 + 语音,驱动口型与面部 | 可灵对口型与 AI Avatar 2.0、万相数字人(wan2.2-s2v)、PixVerse 平台级 Lip Sync、混元早期系列的对口型与动作驱动;国际侧 Veo / Kling 的原生"音画同出" | 声音与肖像都需要授权——生成前留存授权凭证;数字人素材不得用于未获授权的真人(3.13 会展开) |
| 字幕与画面文字:标题、字幕、LOGO | 先生成"干净画面",再在后期叠加所有文字 | 剪映的智能字幕等 AI 辅助功能(具体清单以官网为准)、Premiere / After Effects | 这是失败模式"文字渲染"的标准解:不要让模型渲染文字——最强模型在评测中的整词错误率仍然可观;文字要求像素级一致,而扩散模型每帧都在重新采样 |
| 音效与配乐:给成片铺声音 | 音效先对齐动作,配乐后铺情绪 | 可灵 AI 视频音效、混元 Foley(视频音效生成)、Pika SFX、剪映曲库、Luma 集成的第三方音频 | 音乐版权是红线(第 1 章已展开 Suno/Udio 案例):课堂作品优先用平台自带曲库并阅读条款 |
| 稳定化与降噪:救一救轻微闪烁与抖动 | 后处理滤镜:去闪烁、稳定、光流补帧 | DaVinci Resolve 的 deflicker、Topaz Video AI 的稳定化 | 后处理是"降级补救":能抹掉轻度闪烁,但机制级的失败(身份漂移、物理错误)救不回来——该重抽就重抽 |
关于延长的提示词,这里再给一张"可直接抄"的卡片——它体现了两个纪律(保护尾帧、请求延续而非新事件):
最后交代一下国产剪辑工具的位置:以剪映为代表的工具已经把"智能字幕""图文成片""自动配乐"之类的 AI 辅助做成了常规能力(具体功能以官网清单为准,2026 年 9 月其还发布了新的创作入口)——它们扮演的是流水线里"③ 编辑 → ④ 配乐"的宿主环境。对你而言最重要的判断是:生成工具负责"造镜头",剪辑工具负责"组织镜头",两边的技能都要练,但组织镜头的部分(节奏、景别衔接、轴线、蒙太奇)恰恰是第 1 章打下的底子——工具会换,听你指挥的还是那套镜头语言。
3.9现实约束:一个镜头要"抽"几次才够
这是全章最"不技术"、却最重要的一节。如果你以为 AI 视频的工作方式是"写一句提示词 → 得到想要的镜头",那么第一次实践课就会给你一个下马威。行业实践总结出的两条速记率,请现在记住:
这些比率折算成钱是什么概念?行业里有一个可引用的实例:一个 70 秒、2 个角色的短片,在不用 LoRA 定向训练的条件下,生成花费约 750 美元。换算一下:每 1 秒成片对应约 10 美元的生成预算($750 ÷ 70 秒)——注意分母是"最终成片秒数",不是"生成素材秒数"。这就是两条速记率的经济含义:你为"生成"付钱,却为"筛选后剩下的部分"拿到价值。另一组规模感更强的数据:一条 3 分钟、4 个角色的动画剧集,跑了 164 个生成片段——量级上,成片里的每一个"几秒钟",背后都是几十次生成中的幸存者。
- 素材量估算:生成秒数 ≈ 成片镜头数 × 每镜尝试次数(≈3)× 单镜时长。例:6 个镜头、每镜 5 秒、每镜抽 3 次 → 约 90 秒生成素材,对应成片约 30 秒(还要再按 25% 的留存率、按剪辑节奏缩一遍)。
- 生成预算估算:生成预算 ≈ 生成秒数 × 平台"元/秒"单价。以万相 3.0 的 1080P 档(约 1.2 元/秒)为例,上面 90 秒素材 ≈ 108 元;换成 480P 档(约 0.3 元/秒)则 ≈ 27 元。同一个项目,分辨率档位差 4 倍成本——所以"低档抽卡、高档出片"是标准操作。
- 时间预算估算:等待时间 ≈ 生成次数 ×(单次生成耗时 + 排队时长)。网页版工具的高峰排队不可控,把"批量提交、离线等待"当作常态,不要把渲染时间排进"交作业前的最后两小时"。
由此可以推出三条"降本纪律",它们与 3.6 的参数语义互相呼应:
- 探索用免费额度,交付用付费额度。免费档通常带水印且不可商用,但它适合"试提示词、试参数、找气质"——把付费的每一次都花在已经验证过的组合上。
- 低分辨率试参数,高分辨率出成片。分辨率对成本的影响可达数倍,而"构图与运动是否成立"在低档就能判断——把分辨率留给最后一版。
- 能用剪辑解决的,不要用生成解决。需要 8 秒的运动,可以是两个 4 秒片段的"动接动"组接;需要"更多镜头",可以把一个长镜头切片重组。剪辑比生成便宜一到两个数量级,这正是第 1 章镜头语言在这里的"变现"方式。
最后是心理账本。把这条流水线走到成片,比较常见的时间分配是:生成(含排队与重抽)占大头,筛选与剪辑次之,参数调试也占相当比例。所以本课程对作业的时间建议是"提前三天开始生成"——不是因为生成慢,而是因为你需要给"失败—诊断—重试"留出整整一轮的余量。下面 3.10 节的失败诊所,就是帮你把"重试"从盲目变成有方向的。
3.10失败案例诊所:把"翻车"翻译成"处方"
本节按医院的方式组织:先量"症状",再对"成因",最后开"处方"。在这之前,先记住一条叙述纪律——机制层引论文,实践层引厂商知识库,两者分开表述。意思是:解释"为什么会这样"时要说清是研究结论(如"亚地球重力"、注意力时间对角线),给出"你该怎么做"时要说清是操作经验(如"保护最后几帧")。把经验做法说成机制、或把机制论文说成操作手册,都会误导后来的学习者——这也是你写实验报告时应遵守的同一把尺子。
先看全景。下表把九类高频失败模式压缩成一张速查表;请把"症状"列当作你的分诊台:看到什么现象 → 去第三列找处方。
| 症状 | 成因(机制层) | 处方(操作层) |
|---|---|---|
| 闪烁:亮度脉冲、纹理抖动、边缘振动 | 注意力缺时序平滑归纳偏置(时间对角线碎片化);训练-推理的噪声/SNR 分布差;"细节 vs 一致性"目标冲突;VAE 潜时间边界解码跳变 | 钉死单一光源;每镜只允许一个镜头运动;负面词 no flicker, no warping;缩短片段重抽;后期 deflicker 作为补救 |
| 形变 / 融化:物体边缘流动、结构糊掉 | 标准去噪目标缺乏几何一致性的显式激励;失去对先前帧的显式记忆;速度突变诱发形变;运动预算超支(多轴、俯仰拉伸细长特征) | 锁身份(3–5 张多角度参考);优先图生视频;每镜一个主要运动;慢动作;拆短片段;负面词 warping |
| 物理错误:悬浮、下坠过慢、碰撞无反弹、液体像凝胶 | "亚地球重力":实测等效重力仅 0.38–2.27 m/s²(地球 9.81),且模型越大反而越慢;模型被训练成"看起来对"而非"行为正确" | 拆 3–5 秒短片段;不要安排精确的碰撞/液体/软体演出(改用实拍或传统手段);选题层面绕开弱项 |
| 面部崩坏:下颌线移位、鼻子变宽、面孔逐渐"溶解" | 逐帧重新诠释角色、无身份锚点;模型优先保动作、其次保身份;文本与参考图竞争;单纯优化提示词只能解决约三成问题 | 参考包(正面、3/4 侧、侧面)同场次同光线;输入图规范(脸占画面高约 20–35%);每镜重复 3–5 个核心特征;把"转身回头微笑"拆成两段 |
| 跨镜头不一致:换镜"变脸"、服装变化、画面里出现"双胞胎" | 末帧链式生成会累积误差——到第 3、4 段就已不符;长时序间隔后记忆退化;工具之间没有持久的身份记忆 | 改用参考生视频:把完整上一段 + 原始参考一起喂入,每段重新锚定源参考;先做多角度角色设定表;每条提示都重复身份块 |
| 文字渲染错误:屏幕文字扭曲、笔画溶解、LOGO 变形 | 文字要求像素级一致,而扩散模型每帧都在概率采样——根本冲突;评测中最强模型的整词错误率仍达 0.250 | 不要让 AI 渲染文字:先生成干净画面,再后期叠加;负面词 no text overlay, no watermark |
| 长片头尾漂移:纹理渐进退化、内容偏离上下文 | 因果/流式生成的误差累积+注意力感受野受限;自回归递归放大早期不一致;延长次数越多越差 | 缩短生成单元、靠剪辑;避免在片段第 1 帧处拼接(可靠运动约到第三个重叠帧才出现);保护最后几帧、请求"自然延续" |
| 手指 / 肢体重错、角色克隆 | 手的几何复杂度;生成之间不携带记忆,模型用"把同一角色画两次"解决歧义 | 构图规避:非必要时把手放到画外;慢动作;负面词 no extra fingers;固定角色设定表 |
| 运动幅度过大导致结构崩坏 | 运动预算超支;速度突变诱发形变;多角色身体接触最容易崩;POV 与过肩镜头是跨模型弱点 | "缓慢、可控、连续、稳定"措辞;每镜一个主体、一个动作;空间约束写进每条提示;接受迭代成本(≈3 次生成 1 个可用镜头) |
接下来是四间"诊室",分别对应主线上真实遭遇过的四类问题。请重点观察每间诊室里"诊断动作"的写法——那是把症状对照机制的过程,也是你写实验报告"失败分析"一节时的模板。
症状:V1"月升·潮水"的第二版里,江面纹理从第 2 秒开始出现规律性明暗脉冲——肉眼看像有一层"鬼火"以每秒数次频率闪过;把时间线放大到逐帧,能看到水面亮度大约每 6 帧跳一次。构图、月亮的位置、雾的流动都很好,唯独光不对。
成因(机制层):对照 3.3 节的四种闪烁成因逐条排查:① 这条素材是 5 秒、单一机位、单一光源,运动预算没有超支,排除"冲突类"成因;② 亮度脉冲集中在水面纹理——细节密集、帧间像素变化剧烈的区域,正是"细节合成与一致性目标冲突"的高发区;③ 脉冲呈"每隔几帧"的规律性,与"分块生成时潜时间边界的解码跳变"特征吻合。综合判断:主因是②+③的叠加,运动的复杂程度只是放大器。
处方(操作层):① 提示词"稳定优先":明确"水面只做轻微波纹起伏"、钉死单一光源(月光);② 负面词补齐 no flicker, no warping;③ 把片段从 5 秒缩到 4 秒重抽(缩短片长直接减少潜边界数量);④ 后期用 DaVinci Resolve 的 deflicker 作为补救——但只用在"其他方面近乎完美"的素材上,不要拿它当常规流程。
复诊:重抽结果的验收方式:把画面缩到 50%、逐帧检查水面区域——闪烁在缩小视图上依然可见才算"未通过"。最终第 3 次生成的版本通过复诊,进入成片。
症状:V5"孤舟"第一版:船身中段像"液态金属"一样缓慢蠕动,船头与船尾对不上;划桨人影附近出现了第二个头部轮廓;这三种现象在不同帧里交替出现,没有一帧完全干净。
成因(机制层):① 运动预算超支——这一镜同时叠加了划桨动作、船体漂流、镜头横移、水面波纹四个运动源;② 速度突变——原始提示词写了"由慢突然加快",正是论文里明确会"诱发形变伪影"的写法;③ 身份未锚定——这一镜当时是纯文生视频,船与人没有任何参考图锚点,模型只能逐帧"重新想象"船的形状("失去对先前帧的显式记忆")。
处方(操作层):① 拆镜:把"划桨特写"与"孤舟横越"拆成 V5a / V5b 两个镜头,让每镜只有一个主要运动;② 锚定:V5b 改为图生视频,首帧直接用 K5 分镜图,船形从此有据可依;③ 降运动:运镜改"固定"(横越感由主体漂移产生,而不是镜头横移——这同时解决了"运动叠加");提示词删掉"突然",只保留"缓慢、连续";④ 负面词加 no warping, no duplicate characters。
复诊:重拍后逐帧检查"船首—船身—船尾"三点轮廓的连续性,以及人影数量;任何一帧出现第二个头轮廓即打回。第 2 次生成即通过。
症状:V3"花林"里安排了一片飘落的花瓣作为前景点缀;结果花瓣的下落速度明显偏慢,轨迹"飘飘悠悠",像在糖浆里下沉;后续一版试图用"加速下落"提示词补救,反而出现花瓣边缘拉伸。
成因(机制层):这正是 3.3 节讲过的"亚地球重力"现象的直接表现——实测中模型的等效重力只有 0.38–2.27 m/s²,远低于地球的 9.81 m/s²,且大模型并不比小模型更"物理";模型被训练成"看起来对"而不是"行为正确",像素层面的似然目标不奖励物理守恒。另外,"加速下落"属于速度突变指令,触发形变伪影——用错误的处方治症状,只会引入新症状。
处方(操作层):① 不要在低重力世界里硬演重力戏——把花瓣从"前景主体"降级为"背景氛围元素"(缩小、虚化、放在画面边缘),观众的注意力不再落在那条轨迹上;② 若必须有下落动作,拆成 3 秒以内的短片段,并接受"轻度不真实";③ 记住这条边界:精确的碰撞、液体、软体演出不应该安排给视频模型——这属于实拍或传统特效的守备区;④ 想从根上改善物理表现的路径(学术侧):用少量单球下落片段训练轻量 LoRA,可把等效重力从约 1.81 提升到 6.43 m/s²(约地球的 65%)——这说明"物理短板"是可以被定向训练的,但那是进阶课题。
症状:V4"楼台"的中景里,匾额上的两个字在 5 秒内笔画间歇性溶解又重组——暂停看每一帧都像"差一口气就写对了",播放起来像"字在呼吸"。这一镜的构图与栏杆线条都很稳,唯独文字无法接受。
成因(机制层):文字要求像素级一致性——同一个字在 120 帧里必须笔笔相同;而扩散模型是逐帧概率采样,"每一帧都是重新采样"。评测数据(VTR-Bench,300 条提示、11 个模型)显示最强模型的整词错误率仍达 0.250;研究还发现"内容识别"与"字形级正确"是分离的能力,而视频编辑(V2V)是文字的主要瓶颈。需要说明:"汉字是否比拉丁字母更难"目前尚无专门的实证研究可引用,本教材只作方向性判断——笔画密度更高的字符,对逐帧一致性只会更不利。(存疑事项,勿夸大)
处方(操作层):① 标准解:不要让模型渲染文字——把匾额生成成"干净的、不可辨认的装饰笔画",成片后在后期用剪辑软件叠加清晰文字(也更方便替换与校对);② 负面词加 no text overlay, no watermark;③ 若剧本坚持"画面内自然出现文字",换成远景或大俯拍——让文字小到不构成"读认对象",模型只需画对"有一块匾",不需要画对"匾上是什么字";④ 小组纪律升级:复查第 2 章分镜表,凡含文字元素的镜头在生成前就标注"后期叠加"。
背景:主线《春江花月夜》推进到第 5 个镜头"孤舟"(对应 K5 分镜图:远景平视,一叶小舟自右向左横越江面)。这一镜是全片运动最复杂的镜头,也是小舟最"志在必得"的一镜——她原以为前面四个镜头都过了,这一镜只是重复劳动。
第一版(失败):纯文生视频、5 秒、运动幅度中档、运镜"镜头横移 + 轻微升镜",提示词写了"划桨加速、由慢突然变快"。结果:船形蠕动、人影双头、水面闪烁——三种症状同时出现(详见 F3-2),判定不可用。她又原样重抽了两次,结果只是"换了一批毛病"——没有诊断的重抽,只是在重复付费随机的过程。
诊断(对照 3.10 诊所表):她把三版结果并排,逐条对照表 3-14 的"症状 → 成因":运动预算超支(四个运动源叠加)+ 速度突变("突然"二字)+ 身份未锚定(无参考图)。结论:这不是"运气不好",而是三张处方同时缺席。
重参数(三张处方):① 拆镜成 V5a"划桨特写"(4 秒、固定机位、只保留桨的运动)与 V5b"孤舟横越"(4 秒);② V5b 改图生视频,首帧 = K5 分镜图,另附 2 张船形参考;③ 运镜改"固定",提示词改为"孤舟自右向左缓慢漂移,速度恒定",负面词补齐。她还做了第四件事——把这次实验的完整记录写进了表格(平台+版本+参数+症状+处方),因为"下一个学弟学妹会需要它"。
结果与复盘:V5a 第 1 次生成通过;V5b 第 2 次生成通过,仅需后期轻微去闪烁。对比第一版的 3 次全废,重参数后的两次里投产两镜。复盘一句话:失败时不要重抽,要换条件——重抽是买彩票,换条件是做实验。这条复盘后来成了小组的工作口令,也写进了他们的答辩幻灯。
把四间诊室的处方放在一起看,会发现高频出现的动作其实只有三个:给参考图(锚定身份)、拆镜头(降运动预算)、缩片段(缩短误差累积)。它们共同指向一个事实:AI 视频的失败,多数不是"提示词不够华丽"造成的,而是"条件给得不够"造成的。这也是本教材把条件控制(3.5)排在失败诊所(3.10)前面的原因——先学开药,再学看病。
最后,请把失败当作数据而不是挫折:每次失败都按"症状—成因—处方"三栏记录下来(3.12 节提供了记录表模板),一学期的积累会让你手里长出一张只属于你自己的"故障地图"——这张地图的价值,超过任何教程。
3.11关键概念表:把这一章拧成一把钥匙
下表是本章全部术语的"最小集":每个词一句话定义,外加一条最容易搞错的提醒。做作业卡壳时先回来查它;答辩被问到术语时也用它自检——能用自己的话把第三列说清楚,才算真的懂了。
| 术语 | 一句话定义 | 最容易搞错的点 |
|---|---|---|
| 帧 / 帧率(fps) | 视频的最小单位是单帧图像;帧率是每秒帧数 | "5 秒视频 = 5 张图"是错的:24fps 的 5 秒是 120 帧——这是算力差的根源 |
| 时空数据立方体 | 视频是"帧数 × 高 × 宽"的三维数据块(T×H×W) | 多出来的时间维不是"多存几张图",它让注意力的计算量按平方增长 |
| 时空 patch / 词元 | 把立方体切块、编码后交给 Transformer 的输入单元 | "时空 patch"是输入表示,不等于"时空注意力分解"——Sora 恰恰不属于分解式路线 |
| 潜空间 / 潜扩散 | 先把视频压缩到低维表示,在潜空间里做扩散去噪,再解码回像素 | 压缩比越高不等于越快——编解码常是隐藏瓶颈(3.6 的反例) |
| 3D 因果 VAE | 在空间与时间维都做压缩的自编码器(典型约 4×8×8);"因果"=只看过去帧 | SVD 没有 3D VAE——它的时间层在 UNet 里去,其 VAE 沿用图像版;这一说法在教程里常被传错 |
| 时间混合层 | 插进 2D 生成器、专门建模帧间关系的层 | 只加时间层、不做时空联合建模时,长程一致性有限、易闪烁 |
| 全时空注意力 / 分解式注意力 | 所有词元两两互看(O((THW)²))/帧内空间+同位置跨帧(省但一致性略逊) | 这是"成本 vs 质量"的取舍,不是"新旧"的替代关系 |
| DiT(扩散 Transformer) | 用 Transformer 替代 U-Net 做扩散主干的架构 | "DiT"说的是主干结构,与"如何处理时间"是两个独立维度 |
| 注意力平方增长 | 词元数 N 翻倍,注意力计算量变 4 倍 | 分辨率从 1080P 到 4K(像素 4 倍),注意力约 16 倍 |
| 空间一致性 / 时间一致性 | 身份·布局·风格·光照一致 / 运动平滑·状态转移合法·低闪烁·动作忠实 | "单帧好看"不等于"动态连贯"——审视素材时要分开打分 |
| 闪烁(flicker) | 亮度脉冲、纹理抖动、边缘振动的高频不连贯 | 它不是单一起因:注意力缺平滑偏置、训练-推理 SNR 差、细节-一致性冲突、VAE 边界都可能是主因 |
| 漂移(drift) | 内容随时间低频地偏离全局上下文(越走越远) | 与闪烁要分开诊断:闪烁在"帧间",漂移在"片段间" |
| 首尾帧插值 | 给首帧与尾帧,让模型生成中间过程 | 两帧差异过大时模型会自行编造过渡;部分接口固定时长(如 5 秒不可改) |
| 参考图 / 主体一致性 | 用若干张参考图把"是谁"锚定下来 | 参考图与参考视频的配额会互相挤占;用量与上限以平台文档为准 |
| 运动控制 | 用轨迹、相机位姿控制运动(研究侧);网页版多以提示词或参考视频复刻实现 | 轨迹近邻或交叠时容易"串轨";别把"提示词运镜"当成位姿级控制 |
| 音画联合生成 | 图像潜与音频潜在同一次去噪中生成,同步是"学"出来的 | 与"先生成再配音"的后配音路线是两条路,别混为一谈 |
| "世界模拟器"叙事 | Sora 报告提出的长期愿景:视频生成走向物理世界模拟 | 它与其反证并存:视觉真实感与物理理解无关(Physics-IQ 结论) |
| "亚地球重力" | 实测 AI 视频中物体下落的等效重力仅 0.38–2.27 m/s²(地球 9.81) | 模型更大并不更"物理"——大模型反而更慢;这不是帧率伪影 |
| 种子(seed) | 控制随机性的数值:同种子+同输入=同输出 | 只在同模型同版本同参数同平台内成立;网页版多不暴露种子;模型升级即可能失效 |
| 运动幅度 | 控制画面"动多少"的参数 | 量纲跨平台不可比(0–10、0–1、联动参数并存);人像比风景更怕高幅度 |
| 单次时长 / 累计上限 | 一次生成的最长长度 / 拼接与延长后的总长度 | 不是一个量纲:AI 视频的时长是"拼"出来的,不是"生成"出来的 |
| 迭代率 | ≈3 次生成换 1 个可用镜头;≈25% 的生成片段进入成片 | 这是成本结构,不是"水平不行";写预算与排期必须用它 |
| 显式 / 隐式标识 | 用户可明显感知的标识 / 藏在文件元数据里的技术标识 | 两者都不得恶意删除或篡改;导出后别用工具"清理元数据"(3.13 展开) |
3.12动手实践:把分镜"动"起来
本周实践共 2 学时(90 分钟课堂)+ 课后主线任务。课堂三个练习各有侧重:实践一建立"条件决定命运"的直觉;实践二练参数对照实验的方法论;实践三练镜头语言的"提示词翻译"。课后把主线推进到"4–6 段镜头视频",并为其中至少一次失败留下完整档案。开始之前先做两件准备:① 选一个国内网页工具固定下来(可灵 / 即梦 / 海螺 / Vidu / 万相均可,选能看历史记录的那个);② 准备好第 2 章交付的分镜图(K1–K6)与角色设定图——它们是本次实践的全部"弹药"。
🛠 实践一:同一分镜的两条路——文生视频 vs 图生视频(30 分钟 · 课堂)
任选一张分镜图(建议 K1"月升·潮水",它的运动最简单),用同一段提示词跑两组:A 组纯文生视频(只给文字)与 B 组图生视频(把分镜图当首帧)。两组各生成 3 次;除"是否给首帧"外,一切参数保持相同(时长、比例、分辨率、运动幅度、种子策略一致)。
按三个维度打分并写理由:① 与分镜表的一致性(构图、色调、意象);② 运动的合理性(方向、速度、有没有物理错);③ 瑕疵统计(闪烁/形变/多余肢体各出现几次)。
提交物:6 条视频 + 一张"三列打分表"。结论请回答一个问题:图生视频把失败概率从哪一类"降级"到了哪一类?它消灭了失败吗?(参考案例 3-A 的复盘。)
做一个"提示词杂交"实验:把 A 组里运动气质最好的那条视频的提示词片段(描述"怎么动"的那句)抄进 B 组的提示词,重生成 2 次。观察命中率是否提高,并写一句心得:文生视频有时是"素材库",图生视频是"装配线"。
🛠 实践二:参数对照实验——运动幅度与时长(40 分钟 · 课堂)
选择"人像中景"与"风景远景"各一个镜头(建议 K2 与 K1),按下表跑三组实验。铁律:一次只改一个变量,其余全部锁死并写进记录;每组至少生成 2 次,以区分"参数效果"与"随机差异"。
| 实验 | 变量(只改这一个) | 三组取值 | 固定不变项 | 观察点 | 通过标准(开始前写死) |
|---|---|---|---|---|---|
| 实验 A · 运动幅度 | 运动幅度 / 运动强度档位 | 低档 | 平台默认 | 高档(按平台量程折算,如 0–10 量程取 2 / 5 / 8) | 提示词、时长、比例、分辨率、是否图生、参考图 | 主体形变率、背景稳定性、动作完成度、画面"活"的程度;人像与风景分开记 | 能给出两组结论:人像的"形变开始明显"的档位 vs 风景的"还能更高"的档位——并解释为什么人像更脆弱 |
| 实验 B · 时长 | 单次时长 | 4 秒 | 5 秒 | 8 秒 | 提示词、运动幅度(取实验 A 的中间档)、分辨率、是否图生 | 末段漂移、闪烁出现的位置(第几秒)、单帧锐度、等待时间 | 能指出"瑕疵从第几秒开始出现";能复述"4–10 秒是基本生成单元、长片靠拼接" |
| 实验 C · 落幅 | 提示词是否写"落幅" | 只写运镜名 | 运镜 + 速度 | 运镜 + 速度 + 落幅 | 其余提示词、参考图、时长、运动幅度 | 镜头结束时停在哪、能不能接下一镜、构图是否回到可剪辑状态 | 能当场向同学展示"没写落幅"的版本为什么不能用于剪辑——用画面证明纪律的必要性 |
跨平台量纲测试(选做)。把同一个镜头素材交给第二个平台,用"同一个意图"(而非同一个数值)重设运动幅度与时长,比较结果差异。结论写成一段话:参数值只在各自平台内可比;跨平台要用"意图"翻译,不能用"数值"搬运。
🛠 实践三:运镜指令的"翻译"练习(20 分钟 · 课堂)
从图 3-13 的九种运镜里任选 3 种(其中必须包含"环绕"),把每种写成一条完整提示词——必须包含:主体描述、运动方式、运动幅度、运镜类型、景别与角度、落幅。然后各生成 1 次。
自检三个问题:① 视频结束时镜头停在哪里?和你的落幅写的一致吗?② 有没有出现"多轴叠加"(例如环绕中还自带推拉)?③ 如果重写一次,你会删掉哪个词、补上哪个词?
提交物:3 条提示词 + 3 条视频 + 每条的"改一词"结论。这条练习同时是 30 度原则与景别级差的准备——下一镜怎么接,取决于这一镜"停在哪里"。
🛠 实践四(主线):把 4–6 段镜头变成一部小片(课后 · 2–3 天)
任务:用第 2 章的 K1–K6 分镜图,按 3.8 节的流水线完成一部 20–40 秒的短片(成片 4–6 个镜头):生成 → 筛选 → 编辑 → 配乐 → 导出。全程遵守三条纪律:每镜全参数留档(平台+版本+种子+所有非默认参数);筛选标准前置(在生成前就把"什么算可用"写死);失败必写档案(用下表记录,至少 3 条真实记录,其中至少 1 条做到"失败 → 诊断 → 重参数 → 成功"的完整闭环,参考案例 3-B)。
剪辑要求:镜头组接要遵守第 1 章的规则——景别级差两档以上、动接动方向一致、写清每镜落幅;片尾按 3.13 节完成 AI 标识。
| 症状(可观察描述) | 镜次 / 版本 | 对照失败模式(表 3-14) | 成因假设(机制层) | 处方动作(操作层,已执行) | 复诊结果 | 结论与下次预防 |
|---|---|---|---|---|---|---|
| 第 2 秒起江面纹理规律性明暗脉冲(约每 6 帧一次) | V1 · 第 2 版 | #1 闪烁 | 细节-一致性冲突 + 潜时间边界解码跳变(运动本身不复杂) | 钉死单一光源;负面词 no flicker;5 秒缩 4 秒重抽 | 第 3 次通过复诊(50% 视图逐帧) | 水面/雨雪等高频纹理镜头:默认缩短到 4 秒起步 |
| 船身中段蠕动、人影出现第二个头轮廓 | V5 · 第 1 版 | #2 形变 / #9 运动超支 | 四轴运动叠加 + 速度突变 + 无身份锚点 | 拆镜(V5a/V5b);改图生视频;运镜改固定;删"突然" | V5a 1 次通过;V5b 第 2 次通过 | 结构复杂主体(船/车/机械):一律先拆运动、再谈运镜 |
| (示例结束,下面是你要填写的) | — | — | — | — | — | — |
① 成片视频文件(命名:组名_春江_终版.mp4);② 参数与素材记录表(镜头号 / 平台 / 版本 / 种子 / 关键参数 / 尝试次数);③ 填好的失败分析记录表(表 3-17,≥3 条);④ 一份 200 字以内的方法复盘:本次实践里"最省钱的一次决策"是什么?
3.13真实与标识:让 AI 作品"说真话"
学会生成之后,你必须面对一个比任何参数都重的题目:当你造出的画面与真实几乎无法区分时,你要如何让别人知道"这是 AI 做的"?这不是道德说教课,而是一门有法可依、有案可查、有作业标准要执行的"手艺"。原因很简单:视频的"可信度"高于任何其他媒介——人们本能地相信"眼见为实"。当"眼"可以被合成,信任就成了需要制度与习惯共同维护的稀缺品。
先看反面教材。过去几年里,利用"高可信媒介 + 生成技术"的欺骗已经形成了完整产业链,而且无一例外地指向最容易相信"眼见为实"的人群:
- AI"靳东"诈骗老人案:假冒明星粉丝团诈骗 30 余万元——2024 年 2 月上海静安区法院一审判决 8 名被告,主犯有期徒刑 3 年、罚金 5 万元;此后仍出现"江西老人欲贷款 200 万元给'男友靳东'"的案例;2025 年两会期间靳东本人回应称"性质非常恶劣",并建议对 AI 换脸立法。
- 张文宏"AI 带货":AI 合成视频卖蛋白棒,显示售出 1,200 余件;2024 年 12 月上海市消保委认定其构成对消费者欺诈(可主张退一赔三);微信平台专项治理处置内容 532 条、关闭账号 209 个。
- 奥运冠军 AI 声音带货:2025 年 8 月 18 日央视新闻曝光:AI 仿冒全红婵声音卖土鸡蛋,单条视频点赞 1.1 万,链接售出 4.7 万件;卖家声称"一分钟素材即可克隆任何人声音"。
- 司法给出的价码:杭州"AI 换脸"民事公益诉讼案 2023 年判赔 6 万元并公开道歉;全国首例 AI 生成声音人格权案(北京互联网法院,2024 年 4 月 23 日)判赔 25 万元;公安部 2023 年 8 月的 AI 换脸专项会战通报侦破 79 起、抓获 515 人。
写这段时教材编辑部还做了一个"反面示范"——网络上流传过一个数据:"AI 换脸诈骗同比增 300%"。它看起来很适合放进教材,但我们核查后发现该说法仅见于内容农场,无法溯源,因此不予采用。这本身就是你在这门课里要养成的习惯:转述任何"惊人数字"之前,先问它从哪里来——生成式 AI 让造假成本趋近于零,也让"核查"成了创作者的基本功。
面对这些风险,中国的选择是"办法 + 强标"的治理模式:2025 年 9 月 1 日起施行的《人工智能生成合成内容标识办法》(四部门联合发布),配合当日实施的强制性国家标准《网络安全技术 人工智能生成合成内容标识方法》(GB 45438-2025),搭建起两层标识体系:
- 显式标识:在内容或界面中添加"可被用户明显感知"的标识。对视频,要求在起始画面和播放周边适当位置添加显著提示标识,可在末尾和中间适当位置添加;对音频,要求在起始、末尾或中间添加语音提示或音频节奏提示。提供下载、复制、导出功能时,要确保文件里含着合规的显式标识。
- 隐式标识:在文件数据中添加"不易被用户明显感知"的标识——元数据中写入生成合成内容属性、服务提供者名称或编码、内容编号等;并鼓励添加数字水印。平台在传播环节还要核验隐式标识、补加"传播要素信息"。
- 红线:任何组织和个人不得恶意删除、篡改、伪造、隐匿标识,也不得为此类行为提供工具或服务。这直接标明了两件"不能做"的事:给 AI 视频"洗元数据",以及裁掉平台水印假装没生成过。
法规不只是纸面。把"执行情况"也讲清楚,才是这门课该有的实证态度:网信部门 2025 年 11 月集中查处过一批未有效落实标识规定的 App(约谈、责令限期改正、下架下线);据新华网报道,2026 年 4 月 28 日,网信部门发现"剪映""猫箱"App 及"即梦 AI"网站未有效落实标识要求,指导属地网信办采取约谈、责令改正、警告、从严处理责任人等处置处罚——被点名的正是本章工具表里最主流的几个国产工具。此外,2026 年 3 月起,抖音、快手、腾讯、小红书、哔哩哔哩、微博等 12 家平台先行先试短视频标注,提供"含 AI 生成内容"等 6 类必选标签,标注成为发布的必经环节;2026 年 1—5 月,清理虚假摆拍等违规短视频 52 万余个、严惩违规账号 6.8 万余个;为期 4 个月的"清朗·整治 AI 应用乱象"专项行动第一阶段就处置违规产品 1.4 万余款。
同时,也必须把"执行还在路上"的另一面写出来,这才是完整的现实:媒体实测发现——2025 年 4 月记者测的 25 家平台里仅 9 家设有 AI 声明入口;2026 年 4 月,仍有不少短剧中的 AI 片段未带标识,无标识的 AI 视频"3 秒即过审"。一项覆盖 40 家平台的研究还发现:仅有 14 家强制披露,其中 6 家只对"真实感内容"有要求,且自动标注普遍没有申诉渠道。有法可依 ≠ 执行到位——所以你不能把"平台会替我负责"当作策略;责任是创作者的。顺带一个反向的提醒:标识也有"错标"的风险——北京互联网法院 2025 年 7 月的首例"平台判定用户内容系 AI 生成"案中,用户被算法判定"含 AI 内容未标识"而遭禁言,法院判平台未尽合理适度说明义务、承担违约责任。标识是一件严肃的事,两头都有责任。
把视角抬高一格:中国的"办法+强标"不是孤例。欧盟《人工智能法案》第 50 条的透明度义务自 2026 年 8 月 2 日起适用:生成式 AI 输出须有机器可读标记(至少两种技术,如签名元数据+C2PA 式水印),深度伪造须显著披露(艺术创作可"有限披露"),罚则最高可达 1,500 万欧元或全球营业额的 3%(既有系统宽限至 2026 年 12 月 2 日)。平台侧的技术标识也在并行推进:Google 的 Veo 视频全部带 SynthID 水印;Adobe Firefly 生成的素材带 Content Credentials;TikTok 依据 C2PA 检测自动加"AI-generated content"徽章且不可移除。三法域、两条技术路线(法规标识与技术水印)指向同一个方向:AI 内容的"可识别性"正在成为基础设施。
《春江花月夜》里有一句话,很适合放在这一节的结尾:"人生代代无穷已,江月年年望相似。"诗人用"不变的江月"照见"流转的人生"——文学的力量恰恰来自把真实的世界转化为可信的表达。生成式 AI 给了我们前所未有的表达自由,但它同时提出了一个古老的问题:当你可以造出任何"真实",你还愿不愿意对自己的画面负责?
本课程的立场是三条职业信仰,每一条都对应可执行的动作:第一,不拿合成冒充真实——AI 视频不用于伪造新闻、伪造他人言行、伪造证据;虚构作品要标注"演绎",涉及历史与新闻的内容不做"看起来像实拍"的模糊处理。第二,尊重每一个真人的形象与声音——肖像、声音、姓名都需要授权;数字人素材要能追溯到授权凭证;绝不"拿明星的脸练习"。第三,把标识当成作品的一部分——就像片尾字幕一样,AI 标识不是"缺陷声明",而是创作者的诚实签名。观众可以原谅"这是 AI 做的",但很难原谅"你假装它不是"。
落到操作,发布前只跑一遍下面这张流程图与检查清单即可。
先说明边界:「素材来源、真人权利、显式与隐式标识的最低技术要求」这套通用清单,第 2 章的表 2-23 已经逐条给出,附录 E 也有一份可打印版——本节不重复那部分,只讲视频特有的三件事:标识要出现在哪里、音频轨怎么办、以及成片发布与图像投稿在要求上的差别。
而下面这张流程,把法规条文翻译成"你手上的四个动作":判断、加显式、保隐式、留平台声明。| 检查项 | 依据要点 | 本课程作业标准 | 常见错误 |
|---|---|---|---|
| 视频显式标识 | 视频需在起始画面和播放周边适当位置加显著提示 | 起始画面一角固定"AI 生成"提示 + 发布简介首行注明"含 AI 生成内容" | 只字不提;以为"平台会自动加" |
| 音频显式标识 | 音频应在起始、末尾或中间加语音或节奏提示 | 片尾一行语音:"本片内容由 AI 辅助生成" | 以为"画面有字就够"——音频内容也有独立要求 |
| 隐式标识完整 | 元数据应含生成合成属性信息;不得恶意删除篡改 | 导出后不做"元数据清理";保留平台生成的原始下载文件 | 用"瘦身工具"处理文件,把标识一起洗掉 |
| 真人权利 | 肖像、声音、姓名受法律保护,伪造他人言行有明确判例与罚则 | 每段真人素材都有授权记录;不使用公众人物的脸与声音做练习 | 拿明星形象"练习";数字人素材没有可追溯来源 |
| 内容真实性 | AI 合成不得用于欺骗性传播 | 虚构内容标注"演绎";历史、新闻性内容不使用"似实拍"的合成 | 把 AI 视频当"实拍花絮"发布 |
| 平台声明 | 12 家平台 2026-03 起试行"6 类必选标签",标注是必经环节 | 逐个勾选声明项并留存截图 | 漏勾"含 AI 生成内容",或发布后不复核 |
| 素材版权 | 音乐、图片、字体同样受版权约束(参照第 1 章音频版权处) | 配乐优先平台曲库;每份素材的来源与授权入档 | 直接搬运网络音乐与字体 |
最后把"学生该怎么给自己的作业做标识"总结成三句话,请直接抄进你们小组的交接文档:① 作品里含 AI 生成的画面或声音,就在视频起始画面加角标、简介注明"含 AI 生成内容";② 发布时勾选平台的 AI 声明,并把"带标识的成片 + 声明截图 + 参数记录"一起归档;③ 永远不为了使作品"看起来更像实拍"而删除、修改标识——那不是聪明的运营技巧,而是法规明令禁止的行为。会标识的创作者,才是可以长期合作、可以商业交付的创作者——这门课教你生成,也教你被信任。
把这一章压缩成七句话
- 视频 = 图像 + 时间维:素材是"帧数 × 高 × 宽"的时空数据立方体;词元数随时长与分辨率线性增长,但注意力的计算量按平方增长——"多一维"就是"贵一档"。
- 三条技术路线是"演化叠加"而非"三选一":潜扩散时间层 → 时空注意力(全时空 / 分解式)→ DiT;当代主流是「3D 因果 VAE + 全时空注意力 DiT」。两处常见错说必须修正:SVD 没有 3D VAE;时空 patch ≠ 注意力分解。
- 时间一致性要分两层看:空间一致性(身份、布局、风格)与时间一致性(运动平滑、低闪烁);典型崩坏是闪烁(高频抖动)与漂移(低频偏离),根源是误差累积与注意力缺少时序平滑的归纳偏置。
- "世界模拟器"愿景与实测反证并存:VideoPhy 显示最强模型仅 39.6% 同时满足提示与物理;Physics-IQ 的结论是"视觉真实感与物理理解无关";"亚地球重力"实测 0.38–2.27 m/s²——看起来真 ≠ 懂物理。
- 条件控制是质量的主开关:先锚后动——图生视频、参考图、首尾帧把"是什么"锚住,提示词再讲"怎么动";运镜写作守"一镜一个主要运动 + 落幅 + 主体关系"三条纪律。
- 参数跨平台量纲不可比(运动幅度有 0–10、0–1 等多种口径);时长是"拼"出来的(4–10 秒为基本生成单元);种子只在同模型同版本内可复现;分辨率"贵不贵"取决于瓶颈在扩散还是编解码。
- 现实约束记两条速记率:≈3 次生成换 1 个可用镜头、≈25% 生成片段进入成片;失败时"换条件"而不是"重抽";发布前完成 AI 标识(显式+隐式)——合规是创作流程的一部分,不是附加题。
自测
自测 1:为什么说视频比图像"贵一档"?请用"时空数据立方体"与"注意力的平方增长"两个概念解释。
答案:图像是"高 × 宽"的二维数据,视频是"帧数 × 高 × 宽"的三维数据块(时空数据立方体)。模型把数据切块编码成词元后,词元数与"时长 × 分辨率 × 帧率"成正比——这是线性增长;但注意力要求每个词元与所有词元交互,计算量约等于词元数的平方。于是:时长翻倍(词元翻倍)→ 计算量约 4 倍;分辨率从 1080P 到 4K(像素 4 倍)→ 注意力约 16 倍。这就是"多一维等于贵一档"的数学来源,也是"AI 视频的时长是拼出来的,不是生成出来的"的底层原因。
自测 2:同学在报告里写了两句话——"SVD 用了 3D VAE""Sora 的核心是分解式时空注意力"。请指出错误并改正。
答案:两句都是流行误说。① SVD 的时间建模发生在 UNet 去噪器里(插入时间混合层并联合微调),它的 VAE 沿用图像版(只有空间压缩、没有时间压缩);带时间维压缩的 3D(因果)VAE 是 CogVideoX、Wan、混元等后续模型的做法。正确说法是"SVD 时代 = 图像 VAE + UNet 时间层"。② "时空 patch"是 Sora 的输入表示 / 词元化方式,不等于注意力如何连接;把二者混为一谈会错误归类 Sora 的技术路线。词元化与注意力结构是两个独立的维度。
自测 3:闪烁与漂移怎么区分?各给一条判断依据与一条处方。
答案:闪烁是帧与帧之间的高频不连贯——亮度脉冲、纹理抖动、边缘振动,逐帧检查最明显;漂移是一段时间内的低频偏离——身份、色调、场景元素越生成越"不像开头",通常要对比首尾才看得出来。判断依据:放大时间线逐帧看(闪烁)/把首尾帧并排看(漂移)。处方示例:闪烁——钉死单一光源、负面词 no flicker、缩短片段重抽,后期 deflicker 补救;漂移——缩短生成单元、靠剪辑而不是靠延长、用参考图/参考生视频把每一段"重新锚定"到源参考。
自测 4:有人看完一段"物理无懈可击"的 AI 视频后断言"模型已经理解了物理"。请用两条硬证据反驳,并说明这对应届时的什么实践决策。
答案:证据一:VideoPhy 评测中,当时最强模型也只在 39.6% 的实例中同时满足提示与物理规律;证据二:Physics-IQ 用 396 段真实物理实验视频评测,结论是"物理理解严重受限,且与视觉真实感无关";补充证据:单球下落实测的等效重力仅 0.38–2.27 m/s²,且模型越大反而越慢——说明不是帧率伪影,而是系统性偏差。实践决策:不要让视频模型承担精确的碰撞、液体、软体、多物体交互演出,把这类镜头交给实拍或传统特效;在剧本阶段就"绕开弱项",而不是在生成阶段反复硬碰。
自测 5:小组想在两个平台上比较"运动强度"效果,计划把 A 平台的 6 和 B 平台的 0.6 都设为"中档"再对比。这个设计哪里有问题?正确的做法是什么?
答案:问题在于"量纲不可比":A 平台可能是 0–10 的量程,B 平台是 0–1 的量程,甚至还有平台让运动强度与其他参数联动——"6"与"0.6"在各自平台内的语义可能完全不同,直接对照等于用两把不同的尺子量同一条边。正确做法:① 先查各自官方文档确认量程与默认值;② 用"意图翻译"而非"数值搬运"——例如都以"人像轻微活动(眨眼、微微转头)"为同一意图,请各自平台折算到对应档位;③ 每档至少生成 2 次以区分参数效果与随机差异;④ 把量程、默认值、取值一并写进记录(附平台与版本)。
自测 6:把一部 AI 生成短片发布到平台前,至少要做哪三件事?为什么"删掉文件元数据"是错的?
答案:三件事:① 加显式标识——视频在起始画面与播放周边放显著提示(如"AI 生成"角标),音频加语音提示;② 保隐式标识——保留文件元数据与平台水印,发布时完成平台的 AI 声明/必选标签;③ 归档——把标识位置、声明截图、生成参数与授权凭证存入创作档案。删除元数据之所以是错的:它直接命中法规明令禁止的行为——"任何组织和个人不得恶意删除、篡改、伪造、隐匿标识",也不得为此提供工具;同时它也切断了作品的可追溯性,在答辩、参展与商用交付时都会构成风险。
拓展阅读
- Sora 技术报告《Video generation models as world simulators》(2024)——读它请带着"哪些是证据、哪些是愿景"的问题意识,并与本章 3.3 节的反证对照。
- 综述《Spatiotemporal Consistency in Video Generation: A Survey》(arXiv:2502.17863)——时间一致性的"官方地图",本章 3.3 节的两类崩坏就是它的分类框架。
- VideoPhy(ICLR 2025)与 Physics-IQ(Google DeepMind)两篇物理评测论文——"看起来真 ≠ 懂物理"的原始出处。
- 万相 3.0 官方提示词指南与可灵用户指南——把"读官方文档"当作练习:找出它们的提示词结构、参考图上限与时长参数,与本表 3-10 核对。
- 《人工智能生成合成内容标识办法》全文(2025 年 9 月 1 日施行)与 GB 45438-2025——重点读"标识要求"与"禁止行为"两部分,对照本章表 3-18 逐条打勾。
- Variety 对 2026 年圣丹斯 AI 影片的报道——记住其中那位导演的话:"You Can't Make a Great AI Film on Your Lunch Hour"(你不可能用午休时间做出一部伟大的 AI 电影)。