图像生成与编辑
一句话怎么变成一张画:扩散模型的原理,与网页工具里的参数实操。
- 知识:理解从 GAN 到扩散、再到流匹配的技术演化;说清"加噪—去噪""潜空间压缩""U-Net 与 DiT""无分类器引导(CFG)"这四个核心机制各自在解决什么问题。
- 能力:能读懂并调控采样步数、引导强度、种子、分辨率与宽高比、参考图权重等参数;能独立完成文生图、图生图、局部重绘与条件控制四类操作;能设计并执行"一次只改一个变量"的参数对照实验。
- 素质:建立"素材来源合法、生成过程留痕、发布内容标识"的创作习惯;能识别 AI 图像的典型破绽,理解以中华优秀传统文化为题材时的表达分寸与符号敬畏。
小月把第一版"月升"图发到小组群里,三分钟后小舟回了一句:"月亮挺好的,就是江面上多了一艘船——我们这一镜里没有船。"小月翻回自己的提示词:月夜,江面如镜,一轮明月从潮水中升起。她没写"船",也没写"不要船"。这正是图像生成最难也最迷人的地方:你写下的每一个词都是一条指令,而你没有写下的部分,模型会按自己的"经验"替你补上。这一章要回答三个问题:一张图究竟是怎么从一串随机数字里"长"出来的(原理);采样步数、引导强度、种子这些旋钮各自在管什么(参数);怎么用国内可直接访问的网页工具,把文字分镜一步步变成能进分镜表的关键帧(实操)。学完这一章,你将第一次拥有"把想象变成画面"的可控流程——而不是一次次按下按钮碰运气。
2.1从 GAN 到扩散:一次范式转移
"让机器画一张不存在的照片"这件事,在深度学习时代被认真攻过两次。第一次的答案是生成对抗网络(generative adversarial network,GAN),第二次的答案是扩散模型(diffusion model)。理解这两次尝试的分野,你就理解了今天所有图像生成工具为什么长成这样。
GAN:让造假者和鉴定师互相较劲
GAN 的思路非常"聪明",聪明到近乎狡猾:与其教一台机器"怎么画好一张图",不如让两台机器互相为难。一台叫生成器(generator),负责从随机噪声里造图上;另一台叫判别器(discriminator),负责判断"这张图是真的还是生成的"。生成器的目标是骗过判别器,判别器的目标是看穿生成器——两者同时训练,一起进步。
生活类比很直接:一个造假币的人和一个验钞员互相较劲。造假者每造一版,验钞员就找出一处破绽;验钞员变强了,造假者就得造得更像。理想情况下,到最后造假者造出的钞票连验钞员也分不出真假——那就是一个"会画图"的模型。
这条路走出过惊艳的成果,但也带着两个著名的毛病。第一是训练不稳定:两台机器的进步速度必须大致平衡——判别器太强,生成器得不到有效信号,学不动;生成器太强,判别器又给不出有意义的反馈。训练过程常常像走钢丝。第二是模式坍塌(mode collapse):生成器可能发现"只画少数几类图就能骗过判别器",于是反复输出高度相似的画面,把训练数据里丰富的多样性丢掉了。用小月的话说:"它学会了画月亮,但只会画那一种月亮。"
扩散:把一道难题拆成几百道小题
扩散模型的思路几乎是反着来的:它不要求网络"一步到位地画出好图",而是先教网络"如何破坏一张图",再教它"如何把破坏一步步复原"。
做法分两半。前向过程很简单,不需要学习:拿一张真实图片,逐步往里加噪声,加到最后,图片变成一团纯噪声——这一步就像把照片反复复印、直到只剩雪花点。反向过程才是要学的部分:训练一个网络,输入"某个噪声程度的图",让它预测"这一步里被加进去的噪声长什么样"。学会之后,只要反复从图里减掉网络预测的噪声,一团纯噪声就能一步步"显影"成一张清晰的图。
为什么这条路更稳?因为它把"生成一张图"这个巨大的难题,拆成了几百个"减掉一点噪声"的小题。每一步的目标都很小、很具体、有明确答案(训练时我们知道自己加了多少噪声,所以可以比对、可以纠正),网络不需要像 GAN 那样在一场零和博弈里小心翼翼地保持平衡,也不需要一次性掌握整张图的全部结构。稳定性的代价是速度:一步到位变成了几十步、上百步的累积计算——这也是后面整整一节要讲的"加速"技术的来由。
四代骨架:扩散模型的演化地图
扩散模型不是一步长成今天这样的。从它诞生到今天,骨架换了四次,每一次都在回答同一个问题:怎么让这个"反复去噪"的过程更省、更强、更听话?
| 代际 | 结构 | 关键机制 | 代表 |
|---|---|---|---|
| 第一代 | 像素空间扩散 | 直接在像素上做 DDPM 式加噪/去噪,逐步回归 | DDPM |
| 第二代 | 潜空间扩散(LDM) | 先把图像压缩 8×,在压缩后的"潜空间"里做扩散,计算量约下降 64 倍 | Stable Diffusion 1.5 / SDXL |
| 第三代 | DiT(扩散 Transformer) | 用纯视觉 Transformer 处理"切成块"的潜变量,用 AdaLN 注入条件,具备可预测的算力—质量缩放律 | DiT(Peebles & Xie, 2023) |
| 第三代变体 | MM-DiT(多模态双流) | 文本流与图像流各自独立权重 + 双向联合注意力,显著提升文本理解与画面排版 | SD3 家族 / FLUX 家族 |
这张表是本章的"骨架图":2.3 节讲第二代为什么是分水岭(潜空间),2.4 节讲第三代在架构上换掉了什么(U-Net → DiT),2.5 节讲文本条件怎么被"注进去",2.6 节讲 2024 年之后为什么整个行业都换了训练目标(流匹配)。
DiT 之后,2026 年前沿出现了三条分叉,值得你留个印象——它们说明"最优架构"这个问题至今没有标准答案:一是回退到单流,例如 Z-Image 的 S3-DiT 把双流合并回一条注意力路径,理由是上游的视觉语言模型已经足够强,"模态专属权重"变得多余;二是混合堆叠,底层保留 MM-DiT、上层切成单流 DiT(如 LongCat-Image 采用约 10:20 的比例);三是稀疏专家(MoE),腾讯 HunyuanImage 3.0 采用 64 个专家、总参数 80B、单个词元只激活 13B 的稀疏结构。不过要提醒一句:Qwen-Image、Z-Image、Seedream 等多数前沿系统仍然是稠密模型,"MoE 对稠密"至今没有定论。
检索到的综述把 2026 年图像生成架构最核心的分歧总结为:自回归式统一(把图像当作词元序列来生成)更容易做强化学习,但更难压缩到少步;DiT 式统一则相反——前者"聪明但慢",后者"快但不好用奖励去精修"。这被描述为"2026 年图像生成架构中最具后果的未解问题"。一个佐证是:约 60% 的近期前沿报告(Wan-Image、LongCat-Next 等)已经用同一个骨干同时承载文生图、图生图和指令编辑。注意这是综述观点而非定论——教材把它放在这里,是让你知道"技术地图的边缘长什么样",而不是要你记住结论。
还有一件事值得先交代:训练目标的迁移。2024 年之后,主流开源模型几乎都从"经典扩散"转向了流匹配(flow matching)与其最主流的实现整流流(rectified flow)。这是本章最需要写准的一条技术叙事,2.6 节会专门讲。先把结论放在这里:这不是"扩散被淘汰",而是扩散的血脉延续——换掉的是"从噪声到数据走什么路径"这个设计选择。
| 对比项 | GAN | 扩散模型(含流匹配) |
|---|---|---|
| 核心思路 | 生成器与判别器对抗,一步出图 | 先学"怎么加噪",再学"怎么一步步去噪" |
| 训练稳定性 | 差:两方需保持平衡,易震荡 | 好:每一步都有明确的学习目标 |
| 多样性 | 易模式坍塌,反复输出相似结果 | 多样性更好;但也受引导强度影响(见 2.5) |
| 生成速度 | 快(一次前向) | 慢(需多次迭代),故发展出大量蒸馏加速技术 |
| 可控性 | 难:难以精确约束结构 | 强:条件可注入每一步,利于控制图、参考图、编辑类任务 |
| 今天的地位 | 仍在特定场景使用,已非主流 | 主流;并进一步迁移到流匹配范式 |
2.2加噪与去噪:从噪声里"雕刻"出一张画
现在我们把这台机器拆开。扩散模型的一切,都可以用一句话概括:训练 = 学会去噪;生成 = 从噪声开始,一步步去噪。这一节把这两件事分别讲透。
前向过程:把一张图"弄脏",不需要学
拿一张真实的图,记作 x₀。给它加一点点噪声,得到 x₁;再加一点,得到 x₂……这样重复几十到上千次,最后得到的 x_T 已经和原图毫无关系,看起来就是一团电视雪花。这个过程叫前向过程,也叫加噪过程。
它最重要的特点是:完全不需要学习、可精确复现、且答案已知。因为我们自己决定"在第 t 步加多少噪声",所以每一步的"标准答案"都攥在手里。这一点至关重要——正是它让后面的训练变成了一件有明确对错的事。
为什么非要"逐步"加噪,而不是一步加到位?因为从"轻微模糊"到"更模糊一点"是一个小且连续的变化,而"从清晰到纯噪声"是一个巨大的跳跃。小变化容易学,大跳跃学不会。这就是扩散模型把难题拆小的第一步。
反向过程:训练一个"噪声侦探"
接下来训练一个网络(记为 ε_θ,意思是"带参数的噪声预测器")。训练时的流程是这样的:随机挑一张训练图、随机挑一个步数 t、按前面的规则给它加上噪声得到 x_t,然后把 x_t 和 t 一起喂给网络,问它:"这张图里被加进去的噪声长什么样?"网络给出一个猜测,我们把这个猜测和"我们实际加进去的噪声"逐像素比对,差别越大就惩罚越多,然后稍稍修改网络参数。
重复几百万次之后,网络就成了一个相当可靠的"噪声侦探":给它一张带噪的图,它能相当准确地指出"这里面有哪一层噪声"。
然后到了生成的时候,我们把侦探反着用。手上只有一团纯噪声,没有任何答案。我们让网络看一眼这团噪声,它预测"这里面有噪声,大概是这样";我们把预测到的噪声减掉一点点,得到一张"稍微不那么吵"的图;再把这张图交给网络,让它重新判断、再减掉一点……这样重复 N 次,画面就一点点"显影"出来。注意:整个过程用的 始终是同一个网络、同一套参数,只不过被反复调用了 N 次——这个 N,就是你在界面上看到的"采样步数"。
还有一件必须讲清楚的事:训练与生成,是同一个网络的两种用法,但它们面对的处境完全不同。训练时我们知道答案,所以能算误差、能改进;生成时不知道答案,只能依赖网络"见多识广"后的判断。这就是为什么模型的训练数据决定了它见过什么、能画好什么——它没见过的东西,它只能猜。
你可能会有一个疑问:减掉噪声,凭什么就能得到一张"像样的图",而不是得到一张"没那么吵的噪声"?
关键在一句话:网络不是随便预测噪声,而是在"这张图最可能长什么样"的假设下预测噪声。它是在海量真实图片上训练出来的,见过的图越多,它对"合理画面"的判断就越准。当它看着一团噪声说"这里应该有一轮月亮"时,它实际上是在说:在所有可能是这张图原貌的候选里,"有一轮月亮"的那个版本概率最高。
所以每一步"减掉噪声",本质上是把画面往"更像真实图片"的方向推一小步。步数走够了,画面就从"哪个方向都不像"被推到了"某个方向很像"。用一个粗粒度的公式表达这个过程:
这也解释了两个常见困惑。困惑一:模型是在把训练图拼起来吗?不是。它没有任何"查表"环节,输出的每一个像素都是从噪声算出来的连续数值;这也是为什么它能画出训练集里不存在的构图。困惑二:为什么同样的提示词每次结果都不同?因为起点是随机噪声——起点不同,"雕刻"出的成品自然不同。想复现某一次结果,就要固定起点,也就是固定种子(seed),这是 2.7 节的内容。
训练时的加噪总步数(常记作 T)和生成时的采样步数(常记作 N),是两个不同的数字。T 是训练阶段的"最大破坏程度",可以很大;N 是你实际调用网络的次数,通常只要几十步。少步模型(如 4 步蒸馏)做的事情,正是把 N 压到个位数——代价见 2.7 节。你在界面上看到的"步数"永远是 N。
2.3潜空间:为什么模型要在"压缩的世界"里画画
第 1 章讲过潜空间(latent space):把信息压缩成抽象表示后所在的那个高维空间。当时我们用文本举例——"月"和"明月"的向量靠得近。在图像这里,潜空间不再只是一个概念,而是一个实打实的工程部件:它决定了今天所有主流图像模型的速度上限。
直接在高清像素上扩散,贵得离谱
算一笔账。一张 1024×1024 的彩色图片有 1024×1024×3 ≈ 314 万个数字。如果扩散过程直接在这么长的数字列表上做,那么每一步去噪都要让网络读入 300 多万个数、输出 300 多万个数;而生成一张图要跑几十步。这个计算量会大到让"人人都能用"变成不可能。
更麻烦的是,这 300 多万个数里有大量冗余。相邻像素往往几乎一样,一片天空的两万个像素用"一大片浅蓝"就能描述。逐像素地去噪,等于在一大堆重复信息上反复做无用功。
VAE:先压缩,再在压缩后的世界里扩散
第二代扩散模型(潜空间扩散,latent diffusion model)的答案非常直白:先用一个自编码器把图像"压缩"到潜空间,在潜空间里做扩散,最后再"解压"回像素。这个自编码器通常叫 VAE(变分自编码器,variational autoencoder),它由两半组成:编码器把图像压成一小组数字(潜变量),解码器把潜变量还原成图像。
典型做法是空间上压缩 8 倍:一张 1024×1024 的图,压成 128×128 的潜变量网格。面积小了 64 倍,所以扩散每一步的计算量也大约降到原来的 1/64——这就是"潜空间扩散让 Stable Diffusion 能在消费级显卡上跑"的那条关键机制。生成完成后,解码器再把它还原成 1024×1024 的成品。
用生活类比:你要修补一条 3 米长的长卷,不是趴在原图上一点点改,而是先把它缩印成一张 A4 小稿,在小稿上修好,再放大回去。修小稿又快又省力;但代价是——小稿上看不见的细节,放大回去也不会凭空出现。这就是我们要强调的第二点。
压缩的代价:有损,而且损失是不可逆的
压缩必然有损,这是信息论层面的常识,也解释了一大类你可能遇到过的具体问题:小字糊成一团、发丝黏连、织物纹理变成噪点、远处的人群像涂鸦。这些高频、细密的细节,恰恰是"压到 1/64 面积"时最先被牺牲掉的东西。
理解这一点,你就明白两件在实操中非常有用的事。第一,把"生成文字很密的图"这件事交给图像模型,本身就是逆着它的结构在用力——它在潜空间里工作,而文字的笔画是最高频的细节。这就是 2.10 节为什么要单独讲"文字渲染"。第二,压缩率本身也是一个"速度—细节"的权衡旋钮,行业内一直在尝试不同的压缩方案。
传统 VAE 的 8× 空间压缩仍是主流,但并非唯一选择。据本书编写时的检索:同一时期并存的方案包括 FLUX-VAE、Qwen-Image 使用的 Wan-2.1 VAE、Wan-Image 自训练的 4 通道 RGBA 设计(16× 压缩、48 个潜通道),以及不用 VAE 的 RVQ 分词器。更激进的方向是像素原生 / 无分词器:HiDream-O1 于 2026 年 5 月以 MIT 许可开源,去掉了 VAE 和外部文本编码器,其 8B 模型据称在 GenEval 上得 0.90,高于 FLUX.2 Dev(56B)与 Qwen-Image(27B)的 0.87。该成绩来自厂商/媒体口径,没有独立复核,教材引用时只当"存在这个方向"的证据,不当结论。
2.4U-Net 与 DiT:到底是谁在负责去噪
前面反复说"一个网络被反复调用"。这个网络到底是什么?在扩散模型的历史上,它换过一次主角:从 U-Net 换成 DiT。这次换人不是小修小补,它决定了模型能力"能长到多大"。
U-Net:先退后看整体,再凑近补细节
U-Net 是卷积神经网络的一种结构,名字来自它画出来的形状像字母 U。它的思路分三段:
- 下采样(左边往下走)。把图像一路缩小——1024 → 512 → 256 → 128……每缩小一次,同样的卷积核就能"看到"更大范围的画面。这解决了卷积网络的一个老毛病:感受野太小,只能看见局部。
- 瓶颈(U 的底部)。在最小的尺度上,模型处理的是"整张图的全局结构":构图、大形体、光从哪边来。
- 上采样(右边往上走)。把特征图一路放大回来,一边放大一边靠跳跃连接(skip connection)把左侧浅层的细节"直送"到右侧对应层——这一步非常关键,因为缩小过程中被丢掉的边缘、纹理,如果不"接力传过去",放大时就找不回来了。
生活类比:画一幅大画时的两种视线。先退后几步看整体布局对不对,再凑近处理笔触和边缘。U-Net 把这两种视线做进了同一个网络里。它的问题在于:这种"逐层缩小 + 局部卷积"的结构,对长距离关系的建模能力有限——画面左上角的元素和右下角的元素之间要"直接对话",在 U-Net 里要绕好几层才勉强传得到。
DiT:把图切成"块",当成一句话来读
2023 年的 DiT(扩散 Transformer)提出了另一种做法,而且思路异常简洁:既然 Transformer 处理"词元序列"这么强,那为什么不把图像也变成一串词元?
具体做法是:把潜变量切成一个个小方块(patch),每个小块变成一个向量,于是整张图就变成了一串"视觉词元"——与第 1 章讲的文本词元结构上同构。然后交给标准的 Transformer 去处理,每一个块都通过注意力与所有其他块直接对话。画面左上角与右下角的元素之间,不再需要绕远路。
条件(时间步和文本)怎么进去?DiT 用的是 AdaLN(自适应层归一化):把"现在走到了第几步""提示词要求什么"编码成一组调制参数,在每一层里直接调节特征的缩放与偏移。可以粗略地理解成:不是把提示词贴在门口,而是让提示词进入每一间办公室,逐层下达指令。
DiT 最大的收获不是"更准",而是可预测:它的能力随参数量、数据量和算力的增长呈现出稳定的规律(这就是第 1 章讲过的规模定律在图像侧的体现)。这让"投更多算力换更好效果"从赌博变成了投资。U-Net 时代,能力靠结构调整抠出来;DiT 时代,能力靠规模长出来——这是 2023 年之后图像模型进步的节奏突然加快的直接原因。
MM-DiT:让文字和画面"各管一段,又互相看得见"
第三代还有一次关键的变体:MM-DiT(多模态双流 DiT)。它把文本和图像当作两条并行但有独立权重的流,然后通过双向联合注意力让它们互相注视。为什么要这么做?
因为在纯 DiT 里,文本信息是通过 AdaLN 以较"粗"的形式注入的——它能影响整体风格和氛围,但对"画面里到底画了几个什么、文字摆在哪儿"这类精细要求控制力不足。MM-DiT 让文本词元与图像块词元在同一个注意力场里对话,于是"把标题写在左上角"这种要求,才有可能被真正执行。SD3 家族与 FLUX 家族是这条路线的代表。
| 结构 | 处理单元 | 条件怎么进来 | 强项 | 代表 |
|---|---|---|---|---|
| U-Net | 卷积特征图 | 交叉注意力 + 时间步嵌入 | 局部细节、纹理、低算力下表现稳 | SD1.5 / SDXL |
| DiT | 潜变量小块(视觉词元) | AdaLN 逐层调制 | 长距离关系、可预测的缩放律 | DiT(2023) |
| MM-DiT | 文本流 + 图像流(双流) | 双向联合注意力 | 文本理解与画面排版明显提升 | SD3 / FLUX |
你不需要会写模型,但这两件事能立刻用上。其一,看到"这个模型是 DiT / MM-DiT 架构"时,你可以预期它对文字和版式的理解更好——这正是你挑选"做海报、做分镜字卡"用哪个模型时的关键信息。其二,当你遇到"整体氛围对了、但细部结构总是错"的情况,问题往往不在架构层面,而在条件控制(2.8 节)——因为架构决定的是"它能不能理解你的要求",条件控制决定的是"它有没有被要求必须照做"。
2.5文本条件与无分类器引导:提示词到底怎么起作用
到这里,去噪的机器已经会转了,但它还只是一台"随机画图机"——你没法告诉它画什么。这一节解决两件事:提示词是通过什么通道进入去噪过程的,以及那个最神秘、最容易调错的参数——引导强度——究竟在做什么。
文本怎么"进入"画面:编码 + 注入
第一步是编码。你写的中文提示词先被一个文本编码器翻译成一串向量——这一步和你在第 1 章学的"切词元 + 嵌入"完全一样。第二步是注入:这串文本向量通过注意力机制,在去噪网络的每一层与图像特征发生交互,把"你想要什么"的信息一层层渗进去。
这里有一个容易被忽略的现实:早期主流文本编码器是在英文语料上预训练的,高质量的开源标注数据也以英文为主。这直接影响了"中文提示词 vs 英文提示词"的表现差异,2.10 节会专门用一张表来讲这件事。也有专门为中文优化的例子:快手的可图(Kolors)用 ChatGLM3 作文本编码器而不是英文 CLIP,提示词长度约 256 个词元,并构建了覆盖五万余常用汉字的写字数据集,自称是首个原生支持中文文字生成的文生图模型。
无分类器引导(CFG):把"提示词带来的方向"放大
现在讲本章最重要的一个参数。无分类器引导(classifier-free guidance,CFG),在界面上的名字五花八门——"引导强度""提示词引导系数""提示词相关性""guidance scale",说的都是它。
它的机制可以用一句话概括:把"有条件的预测"与"无条件的预测"之间的差值放大。所谓"有条件的预测",是网络看着"月夜,江面如镜"这个提示词给出的去噪方向;所谓"无条件的预测",是网络完全不管提示词时给出的方向。两者的差值,就代表了"提示词带来的那部分影响"。把这个差值乘以权重 w 再叠加回去,就等于在说:让提示词的作用再强一点。
注意这个公式里一个很容易讲错的地方:w 并不是"画得多好"的旋钮,它放大的是"偏离常态"的程度。w 略大于 1 时,画面确实更贴提示词、线条更锐利;w 再大下去,模型为了满足提示词,会把画面推向一种统计学上"不太可能"的状态——表现为饱和度与微对比急剧上升、高光溢出、皮肤出现塑料感、边缘生硬、阴影过重。这不是"画得更准了",而是"被推得太远了"。
负向提示词:它到底在"减"什么
很多工具里还有一个输入框叫负向提示词(negative prompt)——你不想要的东西写在这里。它的机制,正好是上面公式的一个变体。
在常见实现里,负向提示词顶替了"无条件"那一端的角色:模型被要求"从负向提示词所描述的方向上远离"。所以整个引导过程变成了"朝正向走、背向负向走"。理解了这个机制,就能推出三条非常实用的结论:
- 负向提示词里的词,仍然是"被提到的概念"。模型必须先在某种意义上"知道"这个概念,才能把画面推离它。所以写"不要六根手指"等于把"六根手指"这个概念写进了条件——它可能反而提醒了模型。
- 负向提示词是"缓冲",不是"补救"。它能让画面稍微收敛,但效果远不如把引导强度本身调低。遇到"过饱和、高光溢出"这类问题,优先降 CFG,而不是往负向框里堆词。
- 在少步蒸馏模型上,负向提示词基本失效(原因见 2.7 节)。
引导强度没有"通用最佳值"
这是本书必须反复强调的一条:不同模型的引导强度甜点区差异极大,照抄几年前的老教程("CFG 设 7")是学生最常见的错误之一。下表是本书编写时检索到的推荐区间,请把它当作"起点参考"而不是"物理常数"。
| 模型 / 类型 | 引导强度参考值 | 备注 |
|---|---|---|
| SD 系(SD1.5 / SDXL 一类) | 7–10 | 传统扩散的经典区间;但 2025–26 年的新模型普遍低于这一区间 |
| Z-Image-Base | 3.5–6(4.5 为甜点) | 明显低于 SD 时代的经验值 |
| Z-Image-Turbo | 6–8 | 建议从 7.5 起步;12 以上不推荐 |
| Flux.1-dev | 约 3.5 | 重要陷阱:这里的 guidance_scale 是蒸馏出来的 guidance embedding,不是传统意义的 CFG w |
| 少步蒸馏模型(LCM / Turbo / Lightning 一类) | 1 或 0 | 必须关闭引导;保持 7 会输出过曝、过饱和的画面 |
① CFG 调大 ≠ 图更好。高 CFG 提升提示词遵守度的同时,会推高饱和度与微对比、造成高光溢出、皮肤塑料感、边缘生硬、阴影过重;SD1.5/SDXL 在 w ≥ 10 时可能出现色彩裁剪、渐变断层、"白色变奶油色"。
② 高 CFG 救不了模糊的提示词。模糊的提示词在 CFG 8 下依然模糊,只是更"吵"。引导强度应当作"微调",而不是"补救"。
③ CFG 过高会模式坍缩。约 12 以上易出现结构崩坏、局部过曝、手/脸/文字/机械结构扭曲;21 以上通常构图崩坏,不建议使用。
如果确实需要"高提示词贴合度 + 不炸的画面",工程上有一些更精细的做法:CFG-rescale(用 φ ≈ 0.5–0.7 的系数把引导后的分布重新拉回合理范围)、APG(自适应投影引导)、动态阈值(dynamic thresholding,把中间步的预测值压在合理区间),以及只在部分步数区间内开引导(例如 guidance_interval=[0.2,0.8],只在中间噪声水平阶段施加引导)。这些大多出现在开源工作流(ComfyUI 一类)里,网页工具通常不暴露——但知道它们存在,你就能理解"为什么网页工具里把 CFG 拉到 8 就会过曝,而教程里的参数却很复杂"。
其一,CFG 与采样步数不是"质量旋钮",而是"权衡旋钮"。它们的甜点区,恰恰是"提示词遵守度已经提高,但色彩和光照还没有变得戏剧化"的那个窗口。
其二,负面提示词只能缓冲,不能替代降低 CFG。直接调低引导强度,比在负向框里写满"不要过曝、不要过饱和"更管用。
2.6流匹配:为什么 2024 年后成了主流
如果你只看 2024 年之后的模型发布说明,会发现一个名字反复出现:流匹配(flow matching),以及它的搭档整流流(rectified flow)。本节把这条技术叙事讲准——因为它是"为什么现在的图出得这么快"的答案。
先分清两件事:流匹配是框架,整流流是其中一种实现
这是最容易被讲错的一点。流匹配是一个"框架",它允许你在噪声与数据之间选择任意一条概率路径;整流流则是这个框架里"选择走直线"的一种具体实现,并且通过迭代 reflow(反复重整流)把已经学到的路径进一步拉直,从而减少需要的积分步数。把两者等同起来,就会错过整个要点的关键——"拉直路径"才是省步数的原因。
生活类比:从山脚到山顶。经典扩散走的是那条蜿蜒的盘山小路:每一步都要重新判断方向,路很长,必须迈很多小步才不会掉下去。整流流想做的是"尽量走直线":路径直了,方向变化小,一步就能迈得很大——4 步、甚至 1 步就能到。这就是"少步"从何而来。
迁移的证据:开源阵营几乎集体转向
这条技术路线不是空谈,它在 2024 年之后被开源阵营整体采纳,留下了清晰的时间线:
- SD3(2024 年 3 月)与 SD3.5(2024 年 10 月)确立了开源的 Rectified-Flow MM-DiT 基线,规模覆盖 2.5B–8B;其中 SD3.5 Large Turbo 直接以 4 步蒸馏变体发布。
- FLUX.1(2024 年 8 月)以 12B 的 Rectified-Flow 参数成为事实上的开源前沿;FLUX.1 Kontext(2025 年)把流匹配推进到图像编辑市场。
- NVIDIA SANA / SANA-Sprint让"笔记本上跑 FLUX 级质量"成为可能——靠的正是流匹配使线性注意力、32× VAE 压缩与 1–4 步采样同时可行。
学术侧的表述也很直接:CVPR 2026 的一篇论文(FlowSteer)直接写"流匹配已成为视觉生成的主导范式";另一篇安全对齐方向的论文写道"现代扩散模型越来越多采用基于 Transformer 的整流流"(并以 MMDiT 架构的 FLUX 为例),同时指出一个有意思的副作用:多数安全方法仍针对 U-Net 流程设计,难以泛化到 MM-DiT 上——技术换骨架的时候,"安全护栏"往往来不及跟上,这是行业里一个真实的缺口。
准确的表述是:扩散的血脉延续下来了,具体范式迁移到了流匹配;整流流是其中最主流的路径实现。而且要注意——闭源模型(Midjourney、Imagen、GPT Image 一类)并未披露训练目标,我们只能说"有 Rectified-Flow 式参数化的迹象",在教材中不应写成确定事实。流匹配也不是扩散的"万能升级",而是一个有权衡的设计选择。
| 维度 | 经典扩散 | 流匹配 / 整流流 |
|---|---|---|
| 从噪声到数据走什么路 | 预设的加噪曲线,路径弯曲 | 可自由选择;整流流选"尽量直"的路径,并迭代拉直 |
| 典型采样步数 | 20–50 步常见 | 少步变可行:4 步蒸馏成常规选项,1–4 步在部分方案中可用 |
| 训练信号 | 预测加进去的噪声 | 预测"速度场"/路径方向(不同实现细节不同) |
| 不变的东西 | 仍然是"从噪声出发、迭代逼近数据",仍然需要文本条件、仍然受引导强度与步数的权衡影响 | |
| 对使用者的意义 | 出图更快更便宜;但"步数必须与蒸馏变体匹配""少步模型下负向提示失效"等新规矩随之而来(见 2.7) | |
把这一节压缩一下:流匹配解决的是"路径太长"这个效率问题,它没有改变"从噪声雕刻出图像"这件事本身。所以你在 2.2 节建立的那套直觉——训练学去噪、生成靠迭代、步数就是调用次数——依然完全成立,只是现在"调用次数"可以少得多了。
2.7参数语义:每个旋钮"调大调小"会发生什么
原理讲完了,现在进入本章最重要的实操部分。参数不是玄学——每一个旋钮背后都对应着一条明确的机制,所以"调大调小会发生什么"是可以预测的。这一节把网页工具里你会遇到的参数逐个拆开。开始之前请先记住一条实验纪律:一次只改一个变量。同时改引导强度和步数,你永远不知道是哪一项在起作用。
先补齐"加速"这一课:少步蒸馏模型的三个反直觉
在讲参数之前,必须先交代一个会直接影响你读数的情况:你在 2.6 节看到的"路径拉直",并不足以把步数压到个位数。真正的少步,多半来自另一类技术——蒸馏(distillation):让一个已经训练好的大模型(老师)把自己的"本事"压缩进一个更轻的模型或一层小模块(学生),让学生用极少的步数复现老师的质量。
| 方法 | 类型 | 典型步数 | 交付形态 | 许可 / 备注 |
|---|---|---|---|---|
| LCM / LCM-LoRA | 一致性蒸馏 | 1–4(常用 2–4) | LoRA(可叠加) | MIT 开源;需配套 LCMScheduler |
| SDXL-Turbo | 对抗蒸馏(ADD) | 1–4 | 完整模型 | 研究性许可 |
| SDXL-Lightning(字节) | 渐进式对抗蒸馏 | 1 / 2 / 4 / 8 | 完整模型 + LoRA | OpenRAIL;各步数有独立权重 |
| Hyper-SD(字节) | 一致性 + 对抗融合 | 1–8 | 统一 LoRA | 便于叠加社区模型 |
| Distillation++(ICCV 2025) | 推理时蒸馏 | 4 步 + 1 步教师引导 | 框架 | 在 4 步基础上再加 1 步,普遍改善图像质量指标 |
| LogCD(CVPR 2026) | 局部 + 全局一致性蒸馏 | 2–4 | 统一模型 | 全程无需训练图片,仅约 70 A100 小时 |
代价必须写清楚。步数越少,质量越下降——这不是感觉,是有量化对比的:以 SDXL-Lightning 论文的数据为例,原始 SDXL 在 32 步下的 FID 为 18.49;到了 4 步,LCM 为 21.85、LCM-LoRA 为 21.50、Turbo 为 22.58、Lightning 为 22.30;8 步时 Lightning 回到 21.43(FID 越低越好)。数字在变差,但速度在变好——这就是权衡。
产品侧的证据同样清楚:字节 Seedream 4.0 官方称通过对抗蒸馏 + 分布匹配(10 步以内采样可比肩传统 50 步)+ 4/8-bit 混合量化 + 推测解码与 KV Cache 优化,实现"推理速度较 3.0 提升超 10 倍""最快秒级生成 2K 图片";FLUX.2 的 klein 家族(4B/9B)均为 4 步蒸馏,官方称可达亚秒级。你在网页工具上感受到的"怎么这么快",多半就是这些技术叠出来的。
① 引导强度必须设为 1 或 0。把 CFG 保持在 7 去跑少步模型,会得到过曝、过饱和的画面——因为蒸馏过程已经把引导"烘焙"进去了。
② 步数必须与蒸馏变体匹配。4 步的 LoRA 你用 20 步去跑,结果反而更差——因为超出了它被蒸馏出来的那条轨迹。
③ 负向提示词基本失效。同时,提示遵循度会随步数下降、输出的多样性也会变窄。
另外:必须使用模型卡指定的采样器 / 调度器,换一个可能直接毁掉结果。
参数语义总表
下面这张表是本章的"参数词典"。请注意表头的前提:表里的数值都是检索到的推荐值/范围,不是物理常数;同一参数在不同模型上的甜点区差异很大,实验时务必固定其他变量、只改一个。
| 参数 | 常见取值 | 调大 / 调多会怎样 | 调小 / 调少会怎样 |
|---|---|---|---|
| 正向提示词 prompt | — | 描述越具体,约束越强;但冲突或过复杂的指令会互相抵消 | 越短越自由,模型自行"填空",氛围容易漂移 |
| 负向提示词 negative prompt | — | 抑制不想要的元素;但写"不要六根手指"等于把"六根手指"这个概念写进条件 | 少写更干净,尤其对少步蒸馏模型 |
| 采样步数 steps | SD 系 20–30;蒸馏模型 1/2/4/8;Qwen-Image-2.1 默认 40;FLUX klein 4 步 | 细节与收敛更好,但边际收益迅速递减;超出蒸馏轨迹反而变差 | 更快,但提示遵循度与多样性下降;1 步对复杂提示不可靠 |
| 引导强度 CFG guidance scale | SD 7–10;Z-Image-Base 3.5–6;Z-Image-Turbo 6–8;Flux.1-dev ≈3.5;蒸馏模型 1 或 0 | 更贴提示词、线条更锐利;同时饱和度与微对比急升、高光溢出、皮肤塑料感;≥12 易结构崩坏 | 更自由、氛围感强;但忽略提示词、主体不突出、构图漂移、道具乱跑、手部不稳、数量错误 |
| 种子 seed | 整数;如混元 seed 范围 [1, 4294967295] | 它不改变"画得多好",只改变"从哪个起点开始"。固定种子 = 可复现(在模型版本、参数、提示词都不变的前提下) | |
| 分辨率 size | 即梦 2K 直出、4K 为 AI 增强;Seedream 4.0 默认 2048×2048、最高 4096×4096 | 细节更多,但低分辨率下被糊过去的走形会在 2K/4K 全部暴露;更慢更贵 | 更快更便宜,但手、文字等精细结构更易崩 |
| 宽高比 aspect ratio | 常用 1:1、4:3、3:2、16:9、21:9、2.35:1 | 越偏离训练主分布,越容易出现元素重复("六指的人"、拉长的车) | 越接近方形越稳;训练分辨率越单一,非方形越容易出错 |
| 参考图权重 --iw / 参考强度 | Instant Character 的 scale 默认 1;即梦参考强度需"不高不低" | 越贴近参考图,越可能把参考图的构图/杂物一起带进来 | 越依赖提示词,主体一致性下降 |
| 风格强度 --stylize | 建议最高 1000;100–400 平衡;500–1000 最大艺术表达 | 艺术化更强,但越偏离提示词字面内容 | 更字面、更接近提示词原意 |
| 重绘幅度 denoise strength | 图生图核心参数 | 越接近"重新生成",越可能改动主体身份 | 越接近原图,改动越弱 |
| 控制权重 ControlNet strength | Civitai 建议 0.3–0.7 宽松、0.8–1.2 严格;通义万相/海艺建议 0.6–0.8;Z-Image Turbo 默认 0.6 | 结构约束更强,但风格被压平、僵硬、可能出现色带 | 结构约束变弱,模型自由发挥更多 |
| 分步控制 start_step / end_step | 例如 start 0、end 0.5 | 控制"在哪一段步数区间内施加条件"——只在前半程施加,往往能兼顾结构与自由度 | |
还有几个参数值得单独说一句。混乱度(--chaos):调大后结果更多样、更不可预测,调小则同一批结果更趋同。怪异度(--weird / --exp):调大更怪诞、更实验。质量/连贯(--q):Midjourney V8 的 --q 4 能增强复杂场景的连贯性,但点数消耗变为 4 倍。这几项的具体取值范围,在所引来源中并未给出,本书不凭印象填写——这也是一条给同学的提醒:遇到"范围不明的参数",正确做法是去官方文档查,而不是照抄二手教程。
把参数放在一起看:它们如何共同决定一张图
单个参数看懂了,还要看它们的相互作用。有三组关系最值得记住:
第一组:步数 × 引导强度。这是一对最容易互相掩盖的参数。引导强度太低时,你以为是"步数不够导致画面糊",其实是"提示词没被听进去",于是拼命加步数——结果只是更慢地糊着。反过来,引导强度过高时,加步数只会让过曝和生硬更稳定地出现。正确的排查顺序是:先固定一个适中的步数,把引导强度调到"提示词被听见、画面还没炸"的区间,再微调步数。
第二组:分辨率 × 巧思。2.4 节讲过潜空间的压缩损失。低分辨率下,那些"手指数量不对""衣服上的字是乱码"的问题常常被模糊掩盖;一旦出到 2K/4K,它们会全部暴露。所以高清化是"放大器"而不是"修复器"——不要指望"出个高清版就好了"。反过来说,做参数实验时先用较低分辨率快速迭代,定稿再出高分辨率,是既省时间又不失真的做法。
第三组:宽高比 × 元素重复。扩散模型在方形图上训练得最充分。当你要求 16:9、21:9 这类非方形画幅时,模型需要"拉伸"它对画面结构的理解,比较容易出现元素重复——同一只鸟出现两次、人的手指多出来、车被拉长。有研究把原因归结为"训练分辨率过于单一"。实操建议:优先选模型预设支持的宽高比,而不是自己硬填一个奇怪的比例。
固定种子,能让"起点"一样,所以在模型、提示词、参数、分辨率都不变的前提下,结果应当可以复现。但要注意三个前提:① 平台实现可能变——模型小版本更新、后端优化调整,都可能让同一个种子产出不同的图;② 分辨率或宽高比一变,种子就没意义了,因为噪声图的形状变了;③ 改蒙版、改参考图,同样会改变输出,即使种子固定。所以种子的正确用法是"锁定一次满意结果,便于继续微调",而不是"保证永远一样"。
2.8编辑工具箱:从重绘到条件控制
生成一张图只是开始。真正的创作,八成的功夫在"改"。本节把网页工具里的编辑能力分成六类,逐一讲清楚它们各自解决什么问题、边界在哪里。
图生图与重绘强度:改多少才合适
图生图(image-to-image)做的事情很朴素:不是从纯噪声出发,而是从你给的图出发,先加噪声再逐步去噪。加多少噪声、去多少,由一个参数控制——它叫重绘幅度(denoise strength,界面上也会叫"重绘强度""参考强度")。
- 重绘幅度小(例如 0.2–0.3):基本保留原图,只改画风、色调、质感。适合"照片转动漫""统一全组镜头的色调"。
- 重绘幅度中(0.4–0.6):构图大致保留,但细节会有可观变化。适合"把草图变成成品"。
- 重绘幅度大(0.7 以上):接近重新生成,画面会大幅改变,甚至主体身份都变样。适合"只要一个大方向,细节全部重来"。
为什么"放大重绘幅度会改掉身份"?回到 2.2 节的原理就明白了:重绘幅度本质上是"加了多少噪声"。噪声加得越多,原图残留的信息越少,模型的"自由发挥"就越多。这是纯机制推出来的结论,不需要死记。
局部重绘:2026 年最重要的一条分野
局部重绘(inpainting)是"只改我框住的地方"。它可以极大地节省时间,但它的效果好坏事先取决于一件工程事实:你是用蒙版指定区域,还是只能用文字描述区域。
据本书编写时对 36 个云端图像编辑 API 的第三方核查(2026 年 9 月):只有 3 个接口接受蒙版文件,而且全部是 GPT Image 端点(GPT Image 1、2.5 Flare、2.5 Sunburst;值得注意的是 GPT Image 1.5 与 2 反而不支持)。蒙版用透明像素标出应当替换的区域,尺寸必须与源图一致。这组事实的意义在于:蒙版式与纯提示词式的失败方式完全不同——蒙版工具允许你"重画边界"来修坏结果;纯提示词工具只能"改写句子",而且没有可靠办法复现同样的像素。
① 蒙版要画得比物体边缘略大一圈(大约一个软边的宽度)——因为填充是从边界向内生成的,蒙版贴着物体画,会留下"外溢的边"。
② 把物体造成的"后果"也框进去。阴影、反光、被压暗的草地,都是这个物体带来的痕迹;只框物体本身,修完会"痕迹仍在"。
③ 复杂主体分两趟。先修物体,再修阴影/反光。
最后记住一条反直觉的事实:改蒙版会改变输出,即使种子固定。
扩图与消除:两条"边界"上的功夫
扩图(outpainting)是向外补画面。它在实操中的作用比想象中大得多:把竖构图补成横构图、把人物周围的留白补出来、把一张正方形图扩成短片需要的 16:9。评测口碑较好的做法之一是 Runway 的 Expand Image,支持扩到原始尺寸的 2–4 倍;Canva Magic Expand、Photoshop 的 Firefly Fill & Expand、Clipdrop Uncrop 也都能做。对话式工具里,Gemini 扩得比 ChatGPT 稍多,但质量相近。
消除则是反向操作:抹掉画面里不要的东西。常用工具包括 Cleanup.pictures(去人/物/水印/文字,数秒)、Clipdrop Cleanup(免费版仅支持 720 像素)、Photoshop 的空提示词生成式填充,以及开源的 Lama Cleaner(可本地运行)。
这里有一条必须写进教材的容量边界:Photoshop 的生成式填充在 8000 像素宽的图上"几乎没用";同时,每次生成式填充消耗 1 积分($19.99 的摄影计划含 1000 积分,约合每次 2 美分)。也就是说,"用修图软件把大图一点点修好"这条路,在超大画幅下并不可行——该在生成阶段解决的问题,不要留到后期。
| 能力 | 英文 | 典型工具(本书编写时) | 主要边界 |
|---|---|---|---|
| 图生图 | image-to-image | 即梦、通义万相、豆包、Qwen-Image、混元等 | 重绘强度大时主体身份会被改掉 |
| 局部重绘 | inpainting | 即梦"局部重绘 / 控制笔刷"、通义万相、各平台"消除笔" | 蒙版支持度差异大;纯提示词式难以复现同一像素 |
| 扩图 | outpainting | Runway Expand Image、Canva Magic Expand、Photoshop Fill & Expand、Clipdrop Uncrop | 新区域与原图的光照、透视容易接不上 |
| 消除 | cleanup | Cleanup.pictures、Clipdrop Cleanup、Photoshop 空提示词填充、Lama Cleaner | Clipdrop 免费版仅 720 像素;超大幅面(如 8000 像素宽)下 Photoshop 填充几乎不可用 |
| 条件控制 | ControlNet 一类 | 即梦(参考图/边缘/深度/姿态)、通义万相"高级控制"、Seedream 原生集成 | 权重过高会把风格压平 |
| 角色一致性 | character consistency | 即梦参考图、Midjourney Edit Model、FLUX.2、Nano Banana 家族、Seedream 4.0 | 各方案对参考图数量与身份稳定度有明确上限 |
条件控制族:让"必须像什么"说了算
这一族技术有一个源头:ControlNet。原始论文《Adding Conditional Control to Text-to-Image Diffusion Models》(Lvmin Zhang 等,斯坦福)获得了 ICCV 2023 的 Marr Prize 最佳论文奖,代码以 Apache 2.0 开放;它最初围绕 SD 1.5 构建,后来被扩展到 SDXL 与 SD 3.5。
它的核心思想可以用一句话概括:在"提示词负责'想要什么'"之外,再加一条通道,负责"必须像什么"。你给一张结构图(边缘图、深度图、人体骨架图……),模型就被约束着按这张图的骨架去画——内容与风格仍然由提示词决定。
| 条件类型 | 英文 | 提取的是什么 | 典型用途 |
|---|---|---|---|
| 边缘控制 | Canny | 干净的对象轮廓线,忽略内部纹理 | 草图转成品、线框、Logo、产品轮廓;三种主力中最精确,但强度过高会压平风格或产生色带 |
| 深度控制 | Depth | 每个像素的远近关系 | 建筑、室内、风景、产品环境图;对纹理颜色宽容,对相机距离与大形体严格 |
| 姿态控制 | OpenPose | 人体关键点骨架 | 动作场景、跨帧一致性、故事板;保留动作意图但不修复解剖结构 |
| 线稿 | Lineart | 清晰的线条稿(比 Canny 更适合手绘风) | 漫画、插画上色 |
| 涂鸦 | Scribble | 粗略的涂画线条 | 快速表达构图意图,灵活度最高 |
| 语义分割 | Seg | 按类别着色的区域图(天空/建筑/人…) | 大区域布局控制 |
| 法线 / 直线 / 细节保持 | Normal / M-LSD / Tile | 表面朝向 / 建筑直线 / 局部细节 | 三维感增强、建筑校正、放大时的细节保持 |
三种主力(深度、边缘、姿态)该怎么选?一篇 2026 年 1 月的实测指南给出了相当实用的定位:Depth 管 3D 空间关系与前后景层次,Canny 管精确轮廓,Pose 管动作意图。而 IEEE 在 2026 年 6 月的一篇会议论文用它自己的评估指标(SSIM、LPIPS 与 CLIP 文图对齐分)得出的结论是:边缘和深度控制对"结构保持"更好,涂鸦和姿态控制在"灵活性和创意性"上更佳。这两条结论并不矛盾,它们共同说明了一件事——控制越强,创意空间越小,这是同一枚硬币的两面。
还有一条非常重要的提醒:Civitai 指出 2025–26 年的 union 类模型公布的推荐控制权重低于 SD 时代的默认值。这再次印证了 2.7 节的原则——不要照抄老教程的参数。顺带说一句,每种条件类型都是一份独立的模型文件,必须与基础模型版本匹配;这也是早年本地使用 ControlNet 时最常踩的坑。
| 网页工具 | 对应物 | 说明 |
|---|---|---|
| 即梦 | 参考图 / 边缘 / 深度 / 姿态 / 局部重绘(四类,可叠加) | 官方定位表述为"提示词负责'想要什么',控制参数负责'必须像什么'";控制强度"太高僵硬,太低失控" |
| 通义万相网页版 | "高级控制"面板内的边缘控制(Canny)与姿态控制(OpenPose) | 适合快速验证构图,尤其电商产品图与人物姿态复现 |
| Seedream 4.0 | 原生集成 Canny、Depth、Mask 等视觉信号,无需额外模型 | 草图、涂鸦、辅助线即可引导生成,利于姿态控制、建筑设计、UI 原型 |
| 云端服务 | WaveSpeedAI 的 Z-Image Turbo ControlNet(深度/Canny/姿态,REST 调用,强度可调);Civitai ControlNet(ComfyUI Cloud,含 35 种预处理器) | 无需本地权重与显卡,按调用计费 |
| 开源工作流 | ComfyUI + 对应节点与权重文件 | 控制最细(可分步控制),但需要本地环境与显卡 |
2.9角色一致性:让同一个人出现在不同画面里
到这一步,你已经能生成、能编辑、能控制结构。但《春江花月夜》的短片有一个绕不过去的坎:同一个角色,要在 4–6 个不同画面里出现,而且必须看起来是同一个人。这是生成式图像最难的工程问题之一,也是小月这一周的主要任务。
为什么"同一个角色"这么难
原因在原理层面很清楚:模型每一次生成,都是从一团新的随机噪声开始的独立采样。它并不"记得"上一张图里那个人的脸。更麻烦的是,多数模型在遇到"多主体"场景时,倾向于采样一张"平均脸"——所以在多人画面里,很容易出现"每个人长得都差不多"的"双胞胎脸"。这个现象有一个真实世界的注脚:2026 年呼和浩特摄影赛一件 AI 作品被识破的证据之一,就是"图中环卫工面容高度相似"。
目前的解法有三条路,按"投入—一致性"排开:
路径 A:参考图 / 主体参考(零训练)
这是你最先应该尝试的路。做法是:给工具一张或多张"角色参考图",然后在写提示词时让模型参照它。参考图数量的上限,是各家工具的硬指标:FLUX.2 支持最多 10 张参考图;Nano Banana 家族最多 14 张参考图(Pro 可稳定相似 5 张人脸、融合 6 张高保真素材,2.1 与 2 稳定保持最多 10 个物体与 4 个人物);Seedream 4.0 最多十余张参考图,官方称女主角可以在"30 余种迥异的艺术风格与场景"中保持面部特征一致。
通用工具层面,还有一类专门的"角色一致性"服务,例如 fal.ai 的 Instant Character,其默认参数是 scale=1、guidance_scale=3.5、num_inference_steps=28;开源侧则有 InstantID + IP-Adapter(显存要求较低)、PuLID Flux II(无模型污染)等组合。
路径 A 有一条必须写进笔记本的纪律:使用参考图时,提示词只描述情境,不要重复描述参考图里已经有的特征。你写了"戴眼镜的短发女孩"而参考图里那个人就是戴眼镜的短发,这等于给模型两个"事实来源"——它需要判断该听谁的,结果往往两边都不像。头发、眼镜、脸型这些"长相"信息,应当完全交给参考图。
路径 B:LoRA 训练(一致性最高)
如果角色要反复出现很多次,投入一次训练是值得的。LoRA 是一种轻量微调技术:用十几到几十张同一角色的图片训练一个小模块,之后生成时只要带上这个模块,模型就"认识"这个角色了。它的工程参数在 2025–2026 年已经相当标准化:
- 素材:基础角色 LoRA 建议 15–20 张自制图;开源社区的做法是 15–30 张多姿势、多表情、多光照的图,并配一个唯一触发词(如
sage_character)。 - 工程参数:一份 2026 年的专利申请(公开号 CN122550735A)给出:多视角扩展与数据增强后最终 20–30 张(不少于 15 张);角色 LoRA 的 rank 取 16–64、学习率 1e-4 至 5e-4、训练 500–2000 步;推理时无需再注入参考图。
- 冲突处理:当角色 LoRA 与风格 LoRA 冲突时,优先保护面部身份锚点——脸崩了,风格再对也没用。
这里有一个特别值得学的工程细节:角色参考表(character sheet)工作流。做法是用一张照片,经图像模型生成"四列两行"的网格参考图(正面/左侧/右侧/背面各含全身照与头肩裁切)。关键在于——必须使用均匀无阴影的棚拍布光 + 中性灰背景。为什么?因为均匀的光不会把阴影"烘焙"进素材;如果参考图里脸上带着一道侧光阴影,下游模型很可能把那道阴影误认成"解剖结构",在别的光照条件下也执意画出来。一张 1024×1536 的高质量角色参考表,成本约 $0.04116。
路径 C:精确提示词块与统一角色文件
如果角色是原创的、没有现成参考图,可以先"造"出一个角色,再把它固化成一段反复复用的提示词块——用完全一致的措辞描述同一个人的年龄、发型、服装、体态特征。这条路最轻,但一致性最不稳定,适合"同一批生成里的轻微变化可以接受"的场景。
更工程化的做法是把它变成一个文件:ComfyUI 侧的 Omnichar 定义了一种 .char 格式,一个文件里同时包含参考图、锁定描述与训练好的 LoRA,可以在图像与视频模型之间通用。这意味着同一套角色设定,可以同时供给本章(图像)和第 3 章(视频)使用——这正是小月和小舟在期末之前必须打通的一条管线。
| 对比项 | A · 参考图 / 主体参考 | B · LoRA 训练 | C · 提示词块 / 角色文件 |
|---|---|---|---|
| 是否需训练 | 不需要 | 需要(约 1 小时) | 不需要 |
| 一致性强度 | 中等,受参考图数量与质量影响 | 最高 | 较弱,靠文字描述约束 |
| 启动成本 | 约 30 秒级 | 需要 15–30 张素材与一次训练 | 最低 |
| 典型工具 | 即梦参考图、Midjourney Edit Model、FLUX.2、Nano Banana、Seedream、Instant Character | ComfyUI 生态、各平台 LoRA 训练功能 | 复用的角色提示词块、ComfyUI Omnichar 的 .char |
| 最适合 | 分镜数量不多、需要快速出效果的作业 | 角色贯穿全片、需要长期稳定 | 原创角色、暂无参考素材 |
| 主要风险 | 提示词重复描述参考图特征 → 两个"事实来源"打架 | 素材光照不均匀 → 把阴影烘焙成解剖结构 | 风格/版本变化导致描述失效 |
背景:《春江花月夜》短片需要一个贯穿全片的角色——"诗人"。小月最初的想法很简单:每张关键帧都写一遍"白袍男子,长发束冠,侧身望月"。结果 5 张图出来,5 个人长得都不一样,其中两张还都是"平均脸",放在一起像两个人。
做法:小舟建议她按"路径 A → 路径 B"的顺序走。第一步,先用一段稳定的中文描述生成一张"正面、全身、中性灰背景、均匀布光"的角色定妆图,反复微调直到满意,并把这张图定为参考图。第二步,用这张参考图为基础,生成"四列两行"的角色参考表(正面/左侧/右侧/背面,各含全身与头肩裁切)——依靠的是"均匀无阴影 + 中性灰背景"这条纪律。第三步,在后续每一张关键帧里,都用这张参考表作为参考图,并且把提示词里关于长相的描述全部删掉,只写"月色下他站在江边,衣袂被风扬起"这类情境信息。
结果:重新生成的 5 张关键帧里,人物的脸型、发式、袍服的形制第一次真正"是同一个人"。第一次尝试时小月还在提示词里保留了"长发束冠、白袍",改掉之后一致性明显提升——这正是"两个事实来源"那条纪律的现场验证。
复盘:①一致性问题的本质是"每次生成都是独立采样",所以必须从外部提供身份信息;②参考图解决"长得像",提示词负责"在做什么",两者不要互相越界;③如果短片篇幅更长、角色出现次数更多,就应该走路径 B 训练一个角色 LoRA,把身份真正"固化"下来。这个过程也直接产出了本章需要交付的"角色设定图"。
2.10工具地图:2026 年 10 月,你能用上什么
原理讲完了,参数也讲完了,现在必须回答一个最实际的问题:明天上课打开电脑,我到底该打开哪个网站?
本章给出的答案是一张地图,而不是一份排行榜。理由有两层:第一,模型迭代太快——半年就能换一代,任何排名都会迅速过期;第二,工具好不好用,取决于设备、预算、用途、合规这四条线,而每个学生的四条线都不一样。记住地图,忘记排名,这是本章最重要的态度。
选型之前先问三个问题
- 问题一:我要做到什么程度?课堂练习、海报排版、分镜关键帧——对文字渲染、分辨率、角色一致性的要求完全不同。一张课堂演示图,和一张要放大到两米的展板图,根本不是一件事。
- 问题二:我每个月能花多少钱?国内工具普遍带有免费额度(例如即梦报道口径为每天免费 20 次生成);国际工具多数没有免费层——Midjourney 自 2023 年起取消了免费层。
- 问题三:这张图要拿去做什么?课堂展示、参加比赛、商业发布,三者的合规要求完全不同。所以你必须回到工具的用户协议原文,而不是相信任何二手转述——包括本书。本书编写时检索到国内多数工具的商用条款原文,这条边界必须由你自己动手核实。
国内主线:五个"必须认识"的工具
先讲即梦 AI(字节跳动·剪映团队)。它是本章教学主线的主角,原因是它的能力覆盖面最完整:文生图、图生图、多图融合、控制笔刷("指哪改哪")、局部重绘、AI 扩图、局部消除、抠图换背景、风格/姿势保持,还有一个 5.0 时代新增的检索生图(实时联网查数据后再出图)。分辨率方面,2K 直出,4K 为 AI 增强输出——注意这句话里的分寸:"直出"与"增强"是两种不同的东西,考试里会考。
豆包(字节)默认使用 Seedream 系列模型,免费档可用 Seedream 4.0;它的特色功能是豆包修图——用语音指令换背景、转风格、创意改图。价格上,官方 2026 年 6 月的声明确认搜索问答、写作生图、语音和视频对话等日常功能保持免费,同时推出了专业版三级阶梯(标准 68 元/月、加强 200 元/月、高级 500 元/月),在校大学生认证后有 6 个月特惠(标准套餐 38 元/月)。对学生的实际含义是:完成本课程的全部作业,用免费档就够。
通义万相(阿里)是"工具地图"里最需要小心描述的一个。原因见本书的"待核"清单:阿里云百炼官方文档页显示的是 wan2.5-t2i-preview / wan2.5-i2i-preview(页面更新至 2026-09-11),而百度百科称 2025 年 12 月已发布万相 2.6 系列,另有来源称百炼已出现 wan2.7-image-pro 等型号。多个来源互相矛盾时,教材的正确写法是"以阿里云百炼控制台实际展示为准"——这条写作纪律,比记住任何一个版本号都重要。它真正值得写进笔记的能力是两条:擅长中英文和小语种文字生成(支持复杂结构化长文本、图表、架构图),以及网页版在"高级控制"面板内置了边缘控制(Canny)与姿态控制(OpenPose)。
Qwen-Image(阿里通义千问)是中文汉字渲染的标杆。Qwen-Image-2.0 于 2026 年 2 月 10 日发布(7B,原生 2K,支持 1K token 提示词),被报道可以"数百字古文全文几乎完全渲染";2026 年 9 月 20 日开源的 Qwen-Image-2.1 采用 7B / 32 层单流 DiT + Qwen3-VL 8B 编码器 + 64 通道 RGBA VAE(16× 压缩),默认 40 步,最多 10 张参考图,原生支持透明 RGBA。混元(腾讯)的 HunyuanImage 3.0 则是全章唯一的"反例式存在"——它采用统一自回归框架而非主流的 DiT,64 专家、总参数 80B、激活 13B;它的 Instruct 版本(2026-01-26)把图生图流程做成"先思考,后编辑"。云端价格 0.2 元/张(Lite 档 0.099 元/张),V3.0 提供 50 次免费生成(有效期 365 天)。
可图 Kolors(快手)值得记的名字有一串:它是首个原生支持中文文字生成的文生图模型,写字数据集覆盖五万余常用汉字;它用 ChatGLM3 而不是英文 CLIP 作为文本编码器,提示词长度 256 tokens。它同时也是一堂法律课——见后面的"开源 ≠ 可商用"。最后是 GLM-Image(智谱 + 华为,2026 年 1 月开源):在 CVTG-2K(多区域文字生成准确率)与 LongText-Bench(长文本渲染,覆盖招牌、海报、PPT 等 8 种场景)两项上均获开源第一,生成一张图约 0.1 元。
| 工具(团队) | 你要用到它的理由 | 免费 / 价格要点 | 必须留意的边界 |
|---|---|---|---|
| 即梦 AI(字节·剪映) | 能力最全的网页工具:文生图、图生图、多图融合、控制笔刷、局部重绘、扩图、消除、风格/姿势保持、检索生图;四类控制可叠加 | 报道口径:每天免费 20 次生成;2K 直出、4K 为 AI 增强输出 | 平台内版本较多(图片 5.0 Lite / 5.0 Preview、Seedream 4.5 等),以平台实际显示为准;商用条款以官网用户协议为准 |
| 豆包(字节) | 默认 Seedream 系列,免费档可用 Seedream 4.0;豆包修图支持语音指令改图;Seedream 5.0 Pro 于 2026 年 7 月发布 | 日常功能(搜索问答、写作生图、语音视频对话)保持免费;专业版 68 / 200 / 500 元三档;大学生认证 6 个月特惠 38 元/月 | 同上,商用条款须以官方协议为准 |
| 通义万相(阿里) | 擅长中英文和小语种文字生成,支持复杂结构化长文本、图表、架构图;网页版内置 Canny 边缘控制与 OpenPose 姿态控制 | 百炼新用户约 50 张文生图 + 50 秒视频免费额度(90 天内领用);文生图约 0.029 美元/张(北京),图生图 0.2 元/张 | 版本线混乱:官方文档与百科、媒体口径不一致,一律以百炼控制台实际展示为准 |
| Qwen-Image(阿里通义千问) | 中文汉字渲染突出,可用多种字体渲染数百字古文全文,适合海报、PPT、多格漫画;2.1 支持局部编辑(画圈、涂鸦标注、遮罩)与原生透明 RGBA | 2.0 经 API 邀测 / Qwen Chat 免费体验;百炼 qwen-image-2.0 0.2 元/张(120 RPM)、-pro 0.5 元/张 | Qwen-Image-2.1 采用 Qwen Research License,仅限非商业用途,商用需单独申请授权;而上一代 1.0 为 Apache 2.0 —— 同名系列内许可差异极大,必须逐版本核对 |
| Z-Image(阿里通义) | 高速低价档位(实测 5.1 秒出图);v2 原生兼容 ControlNet(Canny / OpenPose / Depth / Lineart / IP-Adapter / Tile 六种) | z-image-turbo 0.1 元/张(1K) | 实测中曾把"2026 年"误渲染为"2016 年"——快和便宜要付出准确性的代价 |
| 混元(腾讯) | HunyuanImage 3.0 采用统一自回归框架而非主流 DiT(64 专家 / 总参 80B / 激活 13B);Instruct 版本图生图流程为"先思考,后编辑";覆盖 80 多个训练任务 | 云端 HY-Image-V3.0 为 0.2 元/张、Lite 档 0.099 元/张;V3.0 提供 50 次免费生成(365 天有效),生成失败不计费 | 开源权重为 Tencent Hunyuan Community License(第三方对比称月活低于 1 亿可免费商用);混元 3.0 参数量有媒体写成 80 亿,与官方模型卡相差 10 倍,以官方为准 |
| 可图 Kolors(快手) | 首个原生支持中文文字生成的文生图模型;照片级真实感;用 ChatGLM3 作文本编码器(256 tokens);提供 ControlNet / Inpainting / IP-Adapter / ID 保持 / LoRA 等完整组件 | 学术研究免费;商用需先填写快手注册问卷(kwai-kolors@kuaishou.com) | "代码开源 ≠ 权重可商用"的典型反例:代码 Apache-2.0,权重为单独模型许可;独立可图平台已于 2024 年 8 月停止提供创作工具 |
| GLM-Image(智谱 + 华为) | 2026 年 1 月开源;CVTG-2K 与 LongText-Bench 两项文字渲染评测开源第一 | 约 0.1 元/张 | 许可条款未检索到,使用前须核实 |
| 文心一格(百度) | 仅作历史对照:技术路线"知识增强扩散模型",240 亿参数 | 早期实测约不到 4 毛一张 | 作为独立产品已不存在:2025-02-13 转免费并开放退款,2025-04-01 迁移合并至文心一言,2026 年 6–7 月间相关入口进一步迁移 |
补充一组成本对照(字节 Seedream 系列 API,供你做作业预算时估算):4.0 为 $0.027/张、4.5 为 $0.04/张、5.0-Lite 为 $0.035/张;5.0 Pro 实测约 0.3 元/张。分辨率口径上,Seedream 4.0 官方称最高 4096×4096、默认 2048×2048,约 1.8 秒出 2K。
国际对照线:只讲差异,不讲选美
Midjourney V8.2 于 2026 年 7 月 24 日起成为默认版本(谱系:V8.0 Alpha 2026-03-17 → V8.1 2026-04-14 → V8.2 2026-07-24)。它的速度口径是最快比旧版快约 4–5 倍(约 10–15 秒 vs V7 的 30–60 秒),并新增 Edit Model,取代了 Omni Reference、Character Reference 与 Retexture 三件旧工具。参数上引入了 --hd(原生 2K,无需单独放大)与 --q 4(增强复杂场景连贯性,点数消耗 4 倍)。价格体系是本章最有教学价值的一段:Basic $10/月起即含商用,但年营收超过 100 万美元的公司必须使用 Pro 或 Mega 档位,且私有生成需要 Pro/Mega。"商用权限"被写进订阅档位、且与公司营收挂钩——这是 AI 工具商业条款的典型形态,值得你在核实国内工具协议时对照着看。
Adobe Firefly 走的是"多模型超市"路线:平台已托管 30 多个模型(含 GPT-Image 1.5、GPT Image 2、Google Nano Banana 2、FLUX.2 [pro]、Runway Gen-4.5、Kling 3.0 等),自有模型 Firefly Image 5 于 2025 年 10 月 MAX 预览、2026 年 4 月进入 Photoshop 27.6,支持整图变换与风格重绘,最高约 2K(约 4MP);2026 年 3 月还开启了 Custom Models 公测(用自己的图训练风格/角色一致性)。订阅 Standard $9.99/月(2,000 积分)起。但这里有一条极易被忽略的条款陷阱:Adobe 自有模型定位为"商业安全训练与生产使用",而第三方合作模型并不继承同等训练与许可保证——你必须逐个追踪最终资产的来源模型。
FLUX.2(Black Forest Labs)是开源/开放权重阵营的代表,也是"许可分层"最细的一家:FLUX.2 [dev] 32B(2025-11-25)为非商用许可;FLUX.2 [klein] 家族(2026-01-15 发布)中,4B 版本是 Apache 2.0(约 8GB 显存即可运行),而 9B / 9B KV 为非商用许可;另有约 50 步的 undistilled Base 变体供微调与 LoRA 训练。参考图能力上,klein 最多 4 张,max/pro/flex 通过 API 最多 8 张、playground 最多 10 张。
Google 的 Nano Banana 家族是"对话式编辑"路线的代表:从 Nano Banana(Gemini 2.5 Flash Image)到 Nano Banana 2(gemini-3.1-flash-image,2026-02)、Nano Banana Pro(2026-05-29 正式可用)、2.1 与 2 Lite,最多支持 14 张参考图(Pro 可稳定相似 5 张人脸、融合 6 张高保真素材),1K/2K 已正式可用、4K 预览(最大 4096×4096),Pro 支持 Google 搜索接地,2 与 2.1 还支持视频输入。每张输出图都带 SynthID 隐形水印与 C2PA Content Credentials——把这句和 2.15 节的合规要求放在一起看,你会发现"谁在用机器可读的方式标注 AI"已经是一门显学。与之相对,OpenAI 的 GPT Image 系(GPT Image 2、以及第三方清单中出现的 2.5 版本)最强的一点是中文排版能力,以及它是 36 个云端图像编辑 API 中唯一支持蒙版式局部重绘的系列(见 2.8 节)。
| 工具 | 版本与时间线要点 | 能力与额度 | 商用条款要点 |
|---|---|---|---|
| Midjourney | V8.2 于 2026-07-24 起为默认;此前 V8.0 Alpha(2026-03-17)、V8.1(2026-04-14) | 标准任务比旧版快约 4–5 倍(约 10–15 秒);--hd 原生 2K;--q 4 增强复杂场景连贯性;V8.2 新增 Edit Model,取代旧的三件参考工具 | $10 Basic 起即含商用;年营收超 100 万美元的公司必须用 Pro/Mega;私有生成需 Pro/Mega;无免费层 |
| Adobe Firefly | Firefly Image 5:2025-10 MAX 预览、2026-04 进入 Photoshop 27.6;平台托管 30+ 个模型;Custom Models 2026-03 公测 | 整图变换与风格重绘、自然语言指令;最高约 2K(约 4MP);Generative Fill 是实用主力 | 自有模型定位"商业安全训练与生产使用";第三方合作模型不继承同等保证,须追踪最终资产来源模型 |
| FLUX(Black Forest Labs) | FLUX.2 [dev] 32B(2025-11-25);FLUX.2 [klein](2026-01-15):4B 与 9B / 9B KV,4 步蒸馏、亚秒级;undistilled Base 变体约 50 步 | 文生图 + 单参考/多参考编辑;klein 最多 4 张参考,max/pro/flex API 最多 8 张、playground 最多 10 张;输出最高约 4MP | 仅 klein 4B(Apache 2.0)真正无限制;klein 9B 与 dev 32B 非商用——输出可用于商用,但把模型部署/服务于商业产品需向 BFL 购买许可 |
| ComfyUI 生态 | 节点式工作流事实标准:用户超 400 万、社区节点超 6 万个、GitHub 约 10.6 万星;2026-04 完成 3000 万美元融资、估值 5 亿美元 | 节点式 DAG 工作流;PNG 内嵌完整 workflow JSON(拖回即可恢复,实现可审计、可复现);已支持 SD、SDXL、SD3/3.5、FLUX、Kolors、Z-Image 及多个视频模型 | 核心开源免费(GPL-3.0);代码许可与各模型权重许可彼此独立,逐个核对;Comfy Cloud 托管约 $20/月 |
| Nano Banana 家族(Google) | Nano Banana → 2(2026-02)→ Pro(2026-05-29 GA)→ 2.1 → 2 Lite | 最多 14 张参考图;1K/2K 正式可用、4K 预览;对话式编辑、光影/焦距调整、相机变换、品牌一致性;Pro 支持搜索接地;2/2.1 支持视频输入 | 无免费 API 层;每张图带 SynthID 隐形水印 + C2PA Content Credentials;免费层仅存在于 Gemini App / AI Studio |
| GPT Image 系(OpenAI) | GPT Image 2(2026-04);GPT-Image 1.5 于 2026-01 上线 Adobe Firefly | 中文排版能力强;36 个云端图像编辑 API 中唯一支持蒙版式局部重绘的系列(蒙版用透明像素标出替换区域) | 完整价目未检索到,使用前须自行核实 |
"开源 ≠ 可商用":一张必须单独讲清的清单
上一节的表格里藏着一类特别危险的误解:很多同学看到"开源"两个字,默认它就是"随便用"。事实是:代码的开源许可与模型权重的许可,是两份彼此独立的文件。ComfyUI 的代码是 GPL-3.0,但你在它里面跑的每一个模型权重,都带着自己的一份许可。下面这张清单请直接抄进笔记本。
| 模型 / 组件 | 许可 | 商用结论 |
|---|---|---|
| FLUX.2 klein 4B | Apache 2.0 | 可商用(官方称约 8GB 显存即可运行) |
| FLUX.2 klein 9B / 9B KV、FLUX.2 [dev] 32B | FLUX 非商用许可 | 生成输出可用于商用;但把模型本身部署或作为商业产品的一部分对外服务,需要向 BFL 购买许可 |
| Qwen-Image-2.1 | Qwen Research License | 仅限非商业用途,商用需单独申请授权 |
| Qwen-Image 1.0 | Apache 2.0 | 据第三方对比,无收入或用户数限制 —— 与 2.1 形成鲜明对照 |
| 可图 Kolors | 代码 Apache-2.0;权重为单独模型许可 | 学术研究免费;商用需先填写快手注册问卷 |
| HunyuanImage 3.0 | Tencent Hunyuan Community License | 据第三方对比:月活低于 1 亿的组织可免费商用 |
| ComfyUI | GPL-3.0(代码) | 代码本身开源免费、无功能阉割;但其中加载的每个模型权重各按各的许可执行 |
① 同名系列内的许可差异极大。Qwen-Image 1.0 是 Apache 2.0,2.1 却是研究许可;FLUX.2 家族里 klein 4B 是 Apache 2.0,9B 与 dev 32B 都是非商用。永远逐版本核对,不要按系列名记忆。
② "输出可商用"与"模型可商用"是两回事。FLUX 的条款里,输出可以用来商用,但把模型部署成对外服务需要另行购买许可。这两句话经常被混为一谈。
③ 平台条款会变。平台上的"会员可商用"类说法常见于媒体报道,但本书编写时并未取得国内主要工具官方商用条款的原文。做正式项目前,请自行打开官网用户协议逐条读——本书转述的任何条款都不能作为法律依据。
用中文还是用英文:一个被证明是伪命题的问题
"写提示词应该用中文还是英文?"——2026 年的答案是:这不是选语言的问题,而是选偏差的问题。有跨境实测文章直接指出"哪种更好是伪命题",真正要理解的是中英文提示词会带来系统性偏差。四条证据值得逐条讲:
- ① 底层与 token 效率。主流扩散模型多基于 CLIP 等英文预训练,高质量社区标注样本 90% 以上是英文;英文有天然空格、token 切分边界清晰,中文常被切成 1–3 个字符的碎片。但请注意:这条"token 效率"的说法在来源中并未给出量化测量,所以正确的表述是"英文的 token 切分通常更规整",而不是一个具体倍数。
- ② 术语精度(有实测数字)。30 组对比中,中文"白底"提示产生的背景偏暖(约 RGB 248–252,约 60% 带轻微灰、30% 有阴影残留);写成
studio shot on pure white background (#FFFFFF)则达到 RGB 254–255,约 85% 完全干净。亚马逊的商品图标准是"纯白背景,RGB 255,255,255"——在电商场景里,"中文提示词"经常直接意味着返工。 - ③ 风格词颗粒度。英文视觉风格词经广告/摄影/设计行业标准化,颗粒度细、稳定性高。实测中
brutalist undertone能收紧背景质感与边缘光,而中文对应表述每 10 张里约 2–3 张发生漂移。还有一个特别生动的例子:中文"复古"指向 1980–90 年代港风,英文"vintage"却指向 1950–70 年代美式——同一个词,两个时代。 - ④ 文化适配。春节场景用中文最好(红梅、窗花、金箔保持完整),翻译成英文会漂向"泛亚洲节庆";中秋用中文能保持月饼/茶席构图,译成英文会漂向日本茶道;反过来,圣诞用英文最好,译成中文会塌成"商场橱窗装饰 + 塑料感松树";万圣节偏英文。
基于这些偏差,实测验证过三种混合策略,直接可以用在作业里:组合 A——中文主体 + 英文风格/技术词(例如明式家具用中文描述、风格部分写 studio shot, minimalist, soft top light, neutral gray background),比全中文稳定约 30%;组合 B——英文主体 + 中文文化锚点(例如意式咖啡机放在春节场景里),氛围细节比全英文深 50% 以上;组合 C——英文参数与比例 + 中文叙事描述,有助于批量一致性。至于不建议混用的场景:简单白底图、创意多样性探索、节庆图像(节庆图像用"该文化的母语"最稳)。
另外两个容易忽略的实操坑:2026 年 4 月的实测显示中文标点识别仍不可靠,建议使用半角标点;以及 2.9 节已经讲过的——重复描述参考图已有特征,等于给模型两个"事实来源"。
| 维度 | 英文通常更占优 | 中文通常更占优 | 实操建议 |
|---|---|---|---|
| 底层与 token | 主流模型基于英文预训练,社区标注样本 90% 以上是英文;token 切分边界清晰 | 中文优化模型(Kolors、Qwen-Image、Seedream、混元)已显著缩小差距 | 追主流模型用英文;用中文优化模型时按该模型实测 |
| 术语精度 | 白底达 RGB 254–255、约 85% 完全干净 | 中文"纯白底"约 RGB 248–252,约 60% 带轻微灰 | 电商/产品白底图一律用英文写法 |
| 风格词 | 行业标准化、颗粒度细、稳定性高;中文表述每 10 张约 2–3 张漂移 | "复古"能准确唤起 1980–90 年代港风 | 风格词用英文,文化意象用中文 |
| 文化适配 | 圣诞、万圣节 | 春节(红梅/窗花/金箔完整)、中秋(月饼/茶席) | 节庆图像使用该文化母语 |
| 混合策略 | A:中文主体 + 英文风格/技术词(稳定约 +30%)|B:英文主体 + 中文文化锚点(氛围细节 +50% 以上)|C:英文参数比例 + 中文叙事(利于批量一致性) | 按作业类型选组合,别凭感觉随时切换 | |
| 标点与参考图 | 中文标点识别仍不可靠(用半角标点);重复描述参考图特征会引入第二个"事实来源" | 把这两条写进自己的检查清单 | |
让图"写字":文字渲染的真实水平
海报、封面、信息图——数字媒体创作绕不开"画面里的字"。2026 年的状态可以用一句话概括:从"普遍乱码"进步到"主流模型基本可用",但复杂信息图与长文本仍有明显错误。这句话的两半同样重要:前一半告诉你"可以放心用了",后一半告诉你"不能不看就交"。证据如下。
| 证据 | 内容 | 口径说明 |
|---|---|---|
| 百炼三档模型实测(2026-09) | 活动海报(10 处文字要素)三档全部 10/10 全对;高密度会员权益说明(9 处要素)中两个高配档位两轮全对(19/19);z-image-turbo 虽 5.1 秒出图、0.1 元/张,却把"2026 年"误渲染为"2016 年" | 第三方实测;单价:z-image-turbo ¥0.1、qwen-image-3.0 ¥0.18(该型号存在性存疑)、3.0-pro ¥0.25 |
| Qwen-Image-2.0(2026-02-10) | 中文汉字渲染突出,"数百字古文全文几乎完全渲染",适合高级海报、PPT、多格漫画;支持 1K token 超长文字输入 | 官方与媒体报道口径 |
| GPT-Image-2(2026-04) | SuperCLUE 评测汉字生成 93.07 分、文字准确度满分;实测文章称中文排版准确率约 99% | 媒体/厂商口径,非独立基准 |
| GLM-Image(2026-01) | CVTG-2K 与 LongText-Bench(招牌、海报、PPT 等 8 种场景)均获开源第一 | 官方口径 |
| Seedream 5.0 Pro(2026-07) | 中文小字排版不再乱码,与 GPT Image 2 文字质量基本打平;但复杂中文信息图仍有错字——一张 AI 模型入门指南网格卡片出现 5 处错误;字体变化性略逊 | 第三方实测;成本约 0.3 元/张 |
| Nano Banana Pro | 一处引用称文字渲染准确率约 64%;另一来源却称 Nano Banana 2 的文字准确率实际高于Pro | 两处口径张力明显,Google 未公布 2.1 的任何基准——付费前务必自行 A/B |
把这张表读成一个操作结论:海报类中文文字渲染已普遍达到可交付水平(实测全对或接近 99%),差距主要在字体多样性、复杂信息图稳定性与价格;而高密度信息图与长文本的逻辑一致性仍是主要失分点。所以本章给出的作业建议是——图里的字要"少而准",大段文字交给后期排版兜底。
2.11关键概念表
本章新出现的概念比较多,这张表是给你的"随身卡片":每个概念用一句话解释,并标注它在本章的出处,方便回查。
| 概念 | 一句话解释 | 本章出处 |
|---|---|---|
| GAN(生成对抗网络) | 生成器与判别器互相博弈,像"造假币者"对抗"验钞员" | 2.1 |
| 模式崩溃 | 生成器发现少数几种输出就能骗过判别器,于是反复只生成那几种 | 2.1 |
| 扩散模型 | 训练时学会"识别并去除噪声",生成时从纯噪声出发逐步去噪,把图像"雕刻"出来 | 2.2 |
| 加噪 / 去噪 | 正向过程按固定规则加噪;反向过程由网络预测噪声并逐步减去 | 2.2 |
| 潜空间 | 把像素图压缩后的低维表示,是扩散实际发生的"工作台" | 2.3 |
| VAE 编解码器 | 负责把图像压进潜空间、再把潜变量解码回像素图 | 2.3 |
| U-Net | 早期扩散主干:下采样到瓶颈再上采样,靠跳连保留细节 | 2.4 |
| DiT(扩散 Transformer) | 把潜变量切成 patch 当视觉 token,用 Transformer 处理,规模可扩展性更好 | 2.4 |
| MM-DiT | 文本与图像双流并行、双向联合注意力的架构(SD3 / FLUX 系) | 2.4 |
| 文本条件 | 把提示词编码后注入去噪网络,决定"生成什么内容" | 2.5 |
| CFG(无分类器引导) | 用"有条件"与"无条件"两次预测的差值放大提示词影响,w 越大越贴提示词、副作用越多 | 2.5 |
| 负向提示词 | "无条件分支"的替代品:写"不要六根手指"等于把"六根手指"写进条件 | 2.5 |
| 流匹配 / 整流流 | 预测"速度场"、把噪声到图像的路径拉直;框架与实现两个层次要分开说 | 2.6 |
| 蒸馏加速 | 用少步学生模型模仿多步教师模型,1–8 步出图,代价是多样性与质量下降 | 2.7 |
| 种子(seed) | 同一模型、同一参数、同一种子才可能复现同一张图;换模型/分辨率即失效 | 2.7 |
| 重绘幅度 | 图生图里"加多少噪声",越大越接近重新生成、越易改掉主体身份 | 2.8 |
| 局部重绘 / 蒙版 | 只改指定区域;蒙版要略大于目标、包含后果、可重画边界 | 2.8 |
| ControlNet 条件控制 | 用边缘/深度/姿态等结构图约束构图,权重越高越听话、风格越平 | 2.8 |
| 角色一致性 | 让同一角色跨画面保持身份:参考图、LoRA 训练、提示词块三条路径 | 2.9 |
| LoRA | 轻量微调模块,用 15–30 张素材把角色特征"固化"进一个小文件 | 2.9 |
| C2PA / SynthID | 内容凭证与水印机制,让 AI 生成痕迹可溯源——合规与鉴定的技术基础 | 2.10 / 2.15 |
2.12案例教学:从文字分镜到六张关键帧
理论、参数、工具都齐了,现在进入本章的案例教学。这一节有两个案例:主线案例展示春江小组如何把第 1 章产出的文字分镜,变成一组风格统一、角色一致的图像关键帧;外部案例看真实产业界在 2025–2026 年是怎么做的——以及它们摔过的同一个跟头。
主线案例:春江小组的"关键帧之夜"
先交代任务背景。第 1 章结束时,小组手里已经有了一份"能开工"的资产:开头 60 秒的解说词加上一张4–8 个镜头的分镜表,每个镜头还带着一条"可执行的 AI 生成提示词草稿"。本章要交付的是:一张角色设定图 + 4–6 张分镜关键帧——它们既是本章的作业成果,也是第 3 章(视频生成)的首帧素材。
小月把这项工作叫做"关键帧之夜"。她的做法与图 2-15 的六步一一对应,但有两处细节值得单独展开。
细节一:把镜头表"翻译"成画面任务表。文字分镜是给"讲故事"用的,画面任务表是给"生成"用的——后者必须多出三列:一致性与控制(这张图需要锁定什么)、主要风险(这张图最容易死在哪)、判定标准(什么样才算过)。这个习惯来自第 1 章的"风险备注"技巧,本质是一样的:把"验收条件"写在开工之前,而不是生成之后再凭感觉挑。
| 关键帧 | 画面意象(对应诗句) | 景别 | 生成要点 | 一致性与控制 | 主要风险 |
|---|---|---|---|---|---|
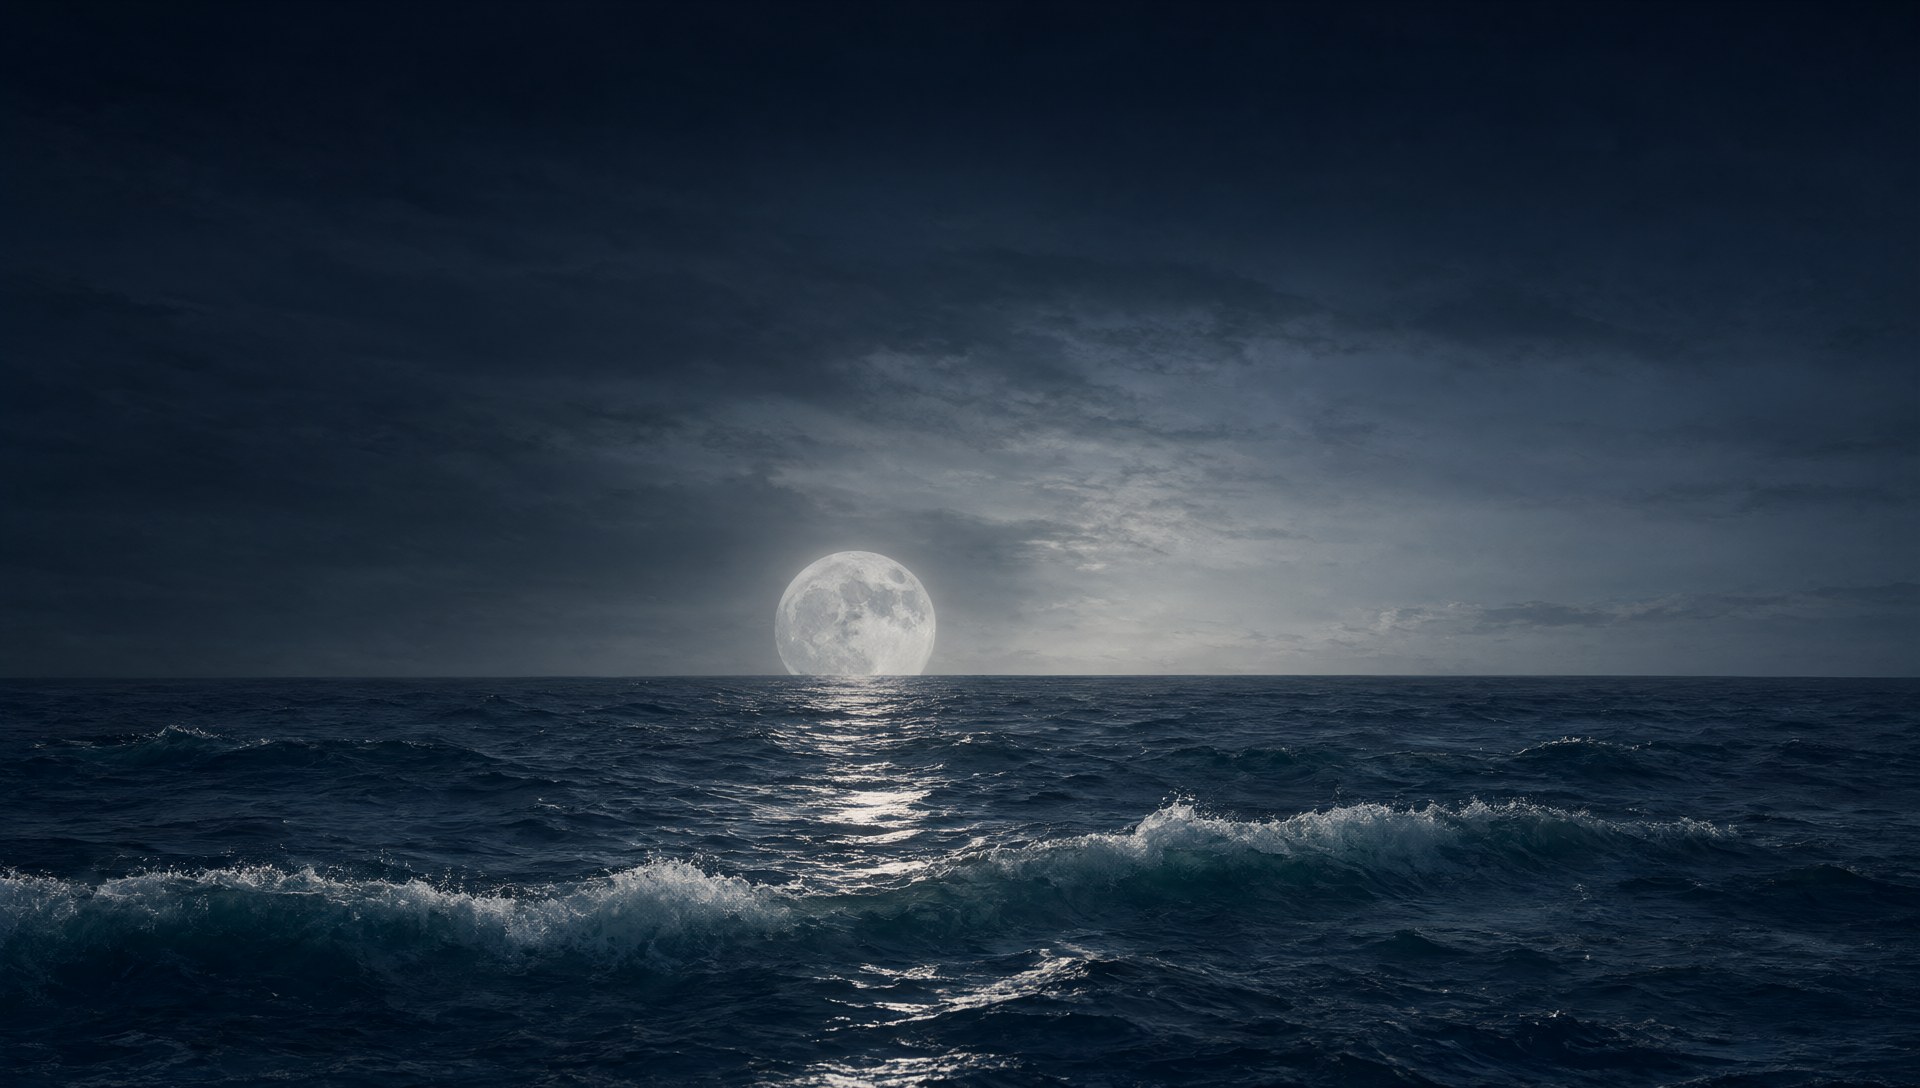
| K1 月升 · 潮水 | "春江潮水连海平,海上明月共潮生" | 远景 · 固定 | 江面占画面约三分之二,一轮明月贴水升起,有薄雾层次 | 无人物,不挂参考图;色调锚定青蓝 | 水面反光在跨帧时最难一致(留给第 3 章处理) |
| K2 水月 · 诗人 | "江畔何人初见月" | 中景 · 人物偏右 | 参考表锁身份;提示词只写情境(月色、江畔、衣袂被风扬起) | 参考图必挂;提示词删净长相描述 | 手部动作——只允许自然下垂,不做复杂手势 |
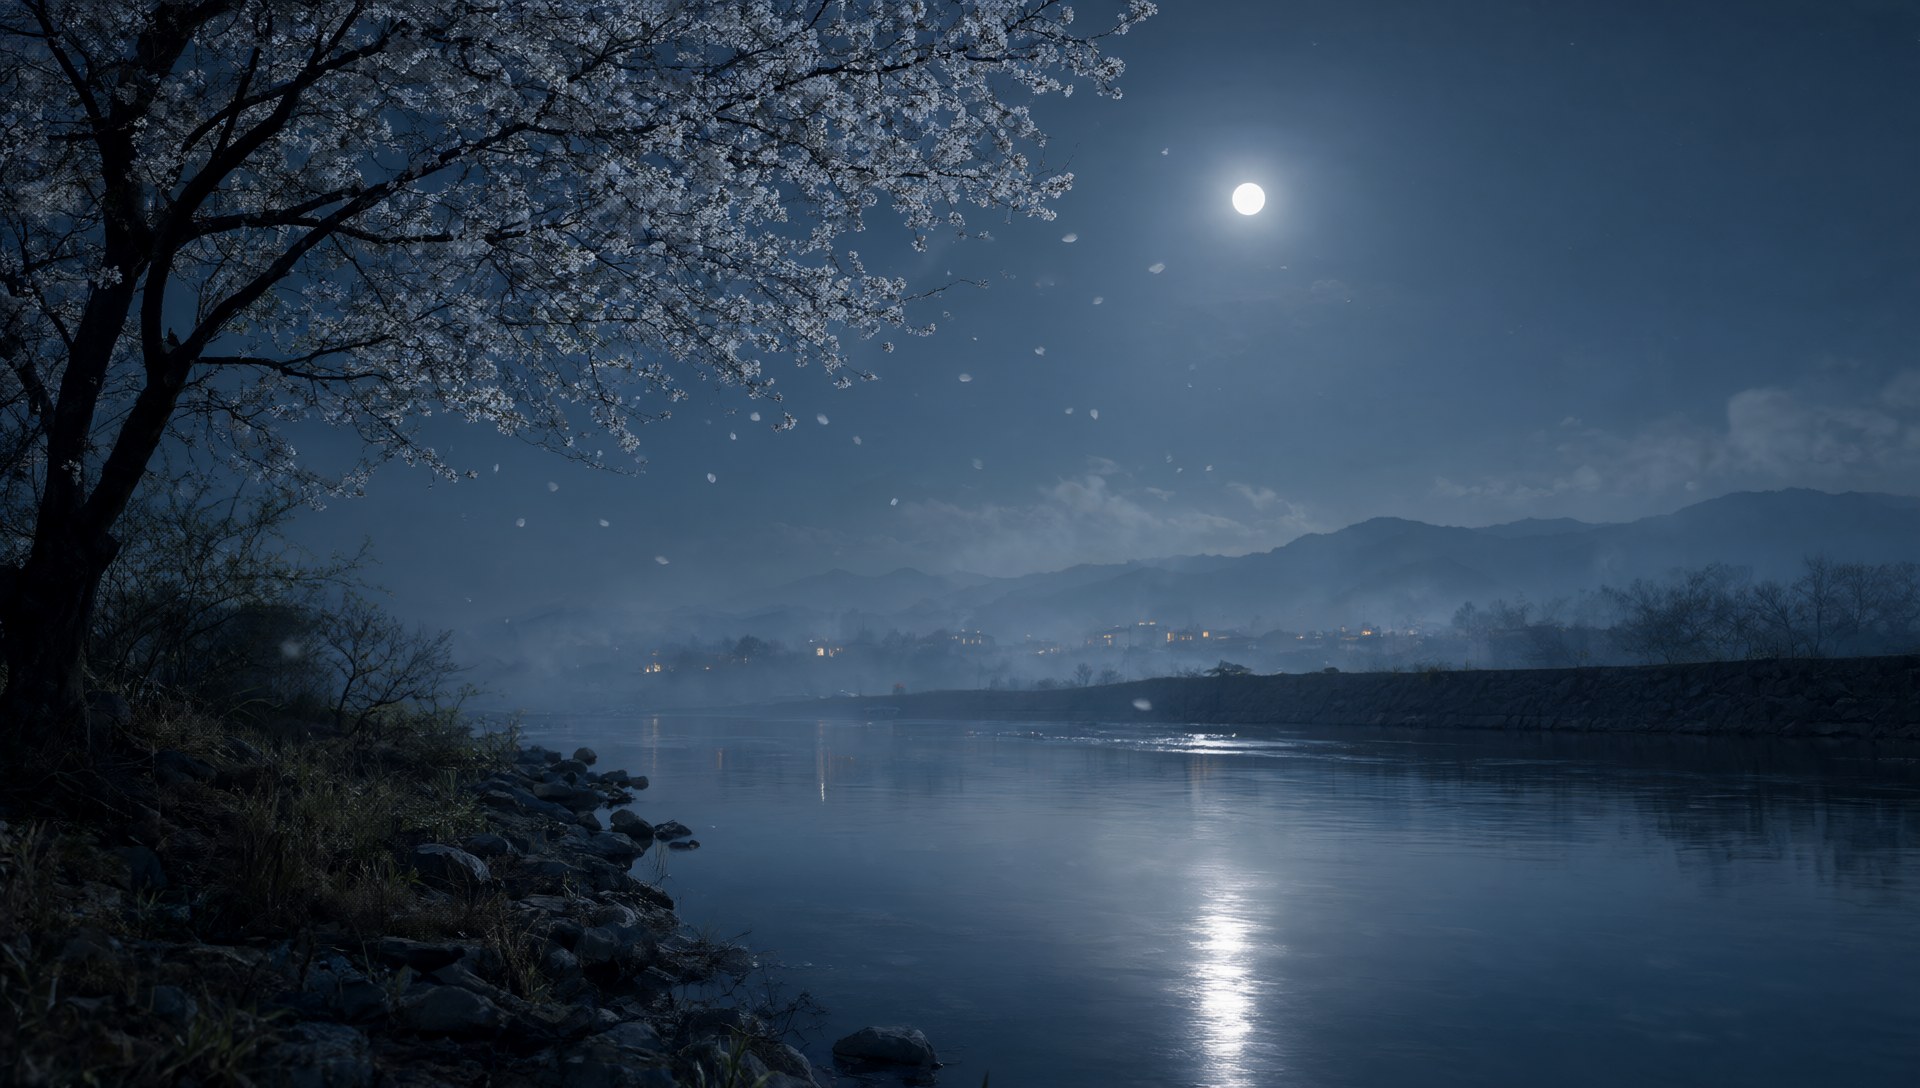
| K3 花林 | "月照花林皆似霰" | 全景 · 俯拍 | 花树成片,月光在叶隙间呈霰点状;人物可极小或省略 | 与 K2 共用同一套色调基线 | 花朵糊成噪点或出现重复纹理 |
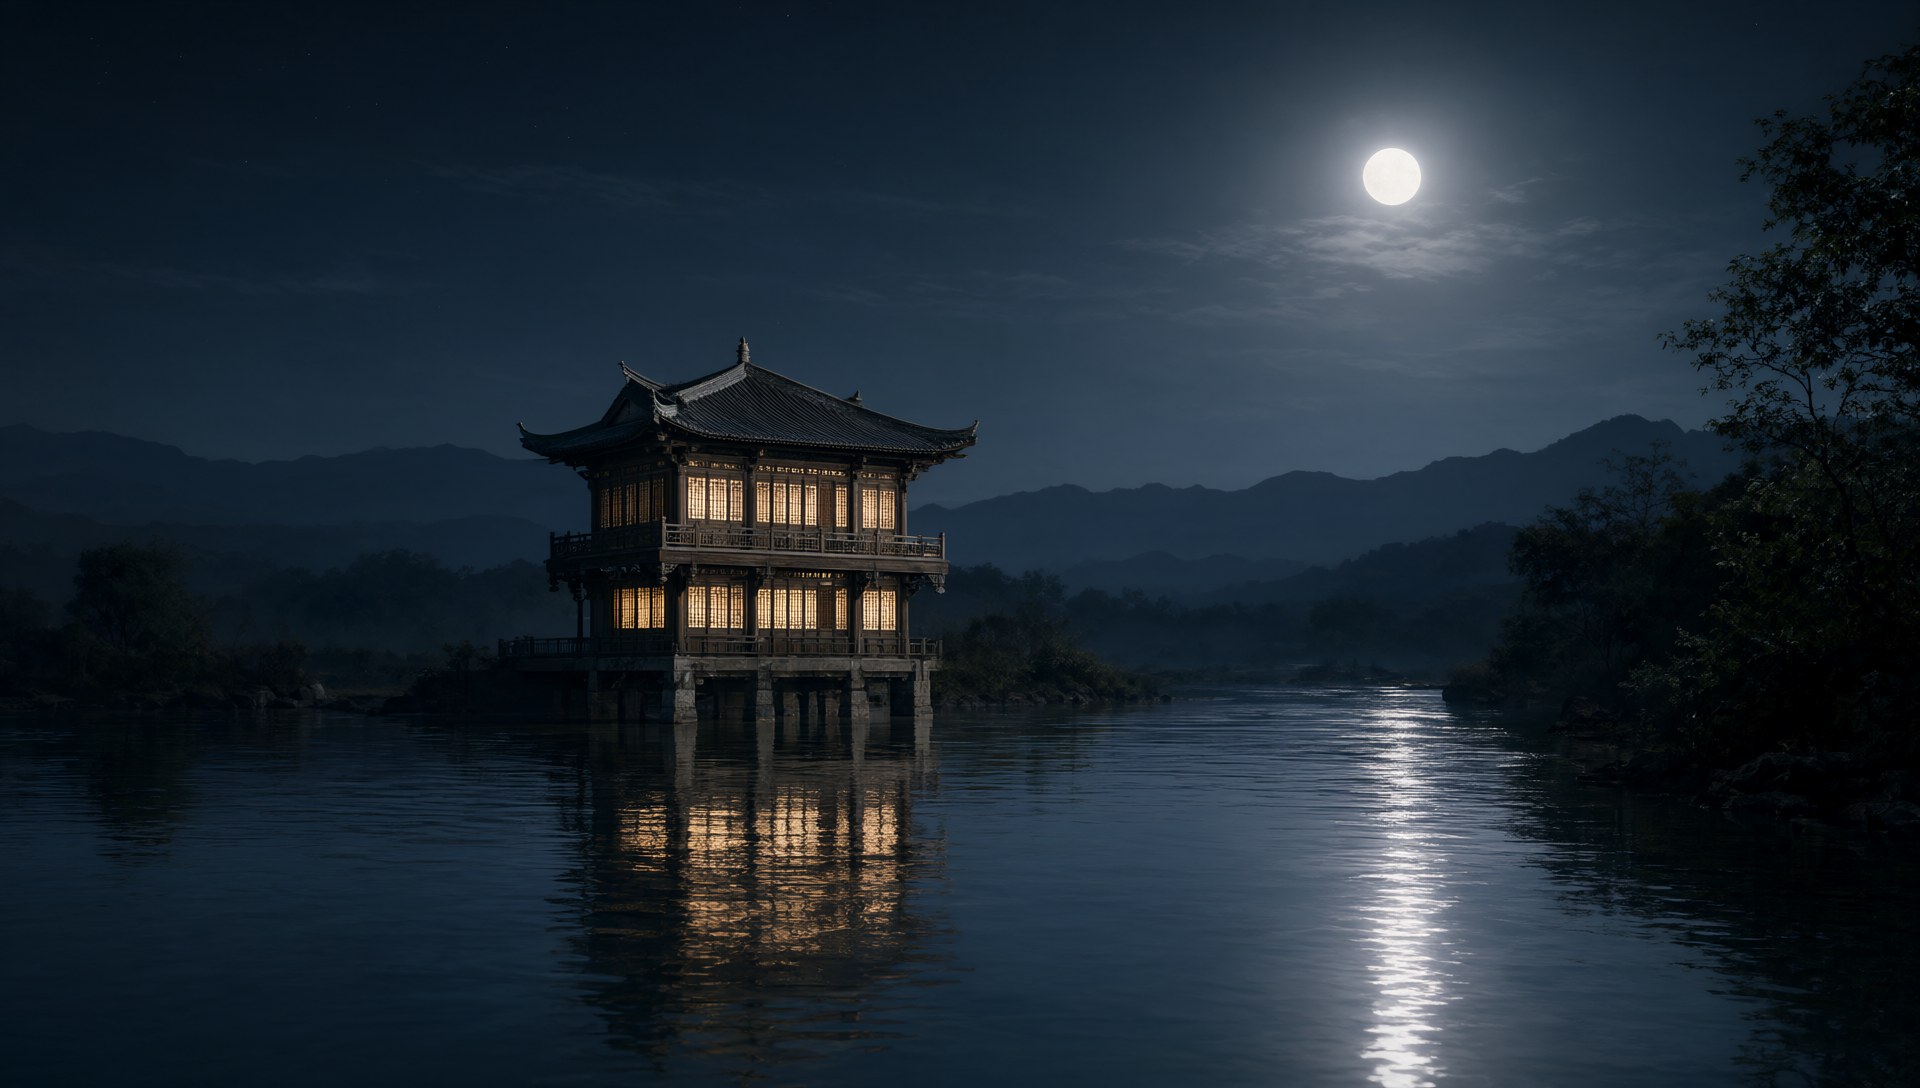
| K4 楼台 | "可怜楼上月徘徊" | 中景 · 仰视 | 楼台轮廓清晰,月悬檐角;建筑直线多 | 用深度或边缘控制锁建筑结构 | 栏杆、瓦檐等重复元素拉长变形 |
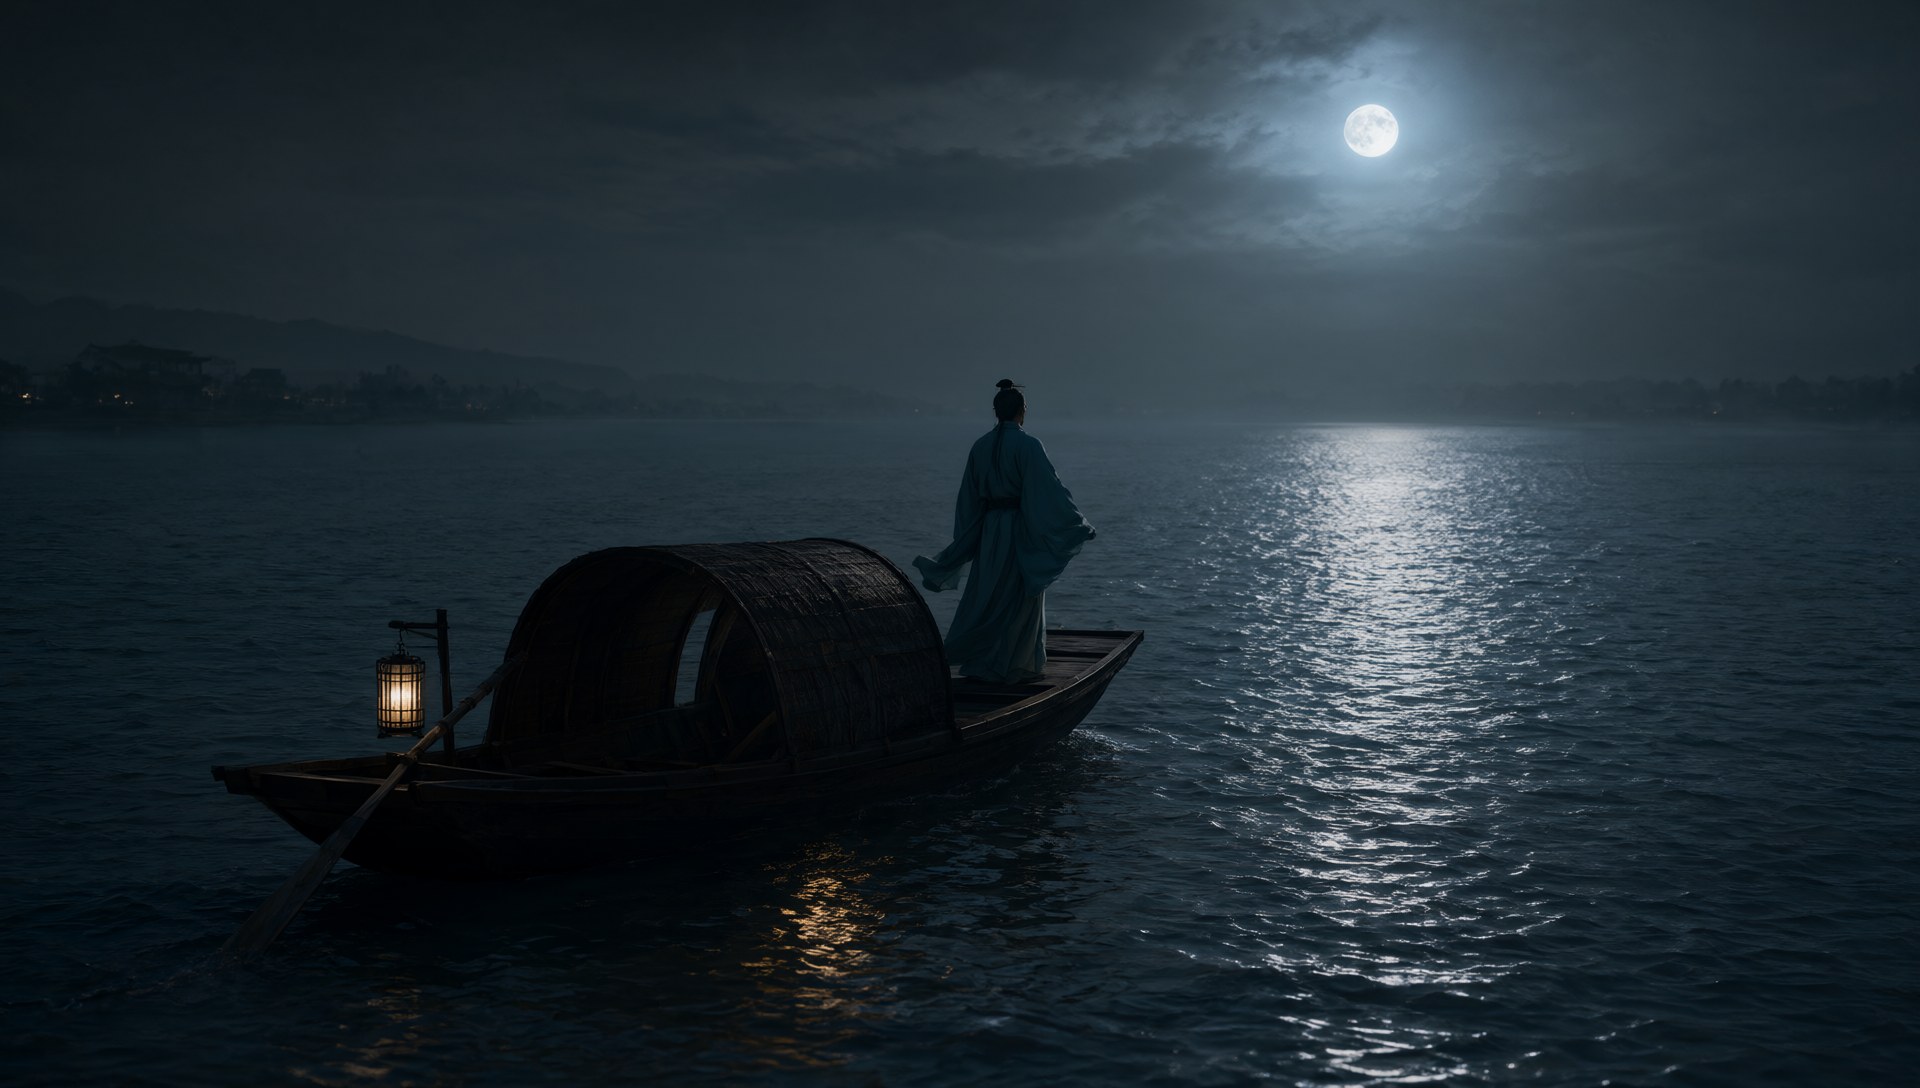
| K5 孤舟 | "谁家今夜扁舟子" | 远景 · 平视 | 江面一叶孤舟,舟上人影小而模糊 | 人影挂同一参考表,但比例极小、不带五官细节 | 舟形畸变、人影出现"双头"或多余肢体 |
| K6 归途 · 空镜 | "不知江月待何人" | 远景 · 有缓慢移动感 | 收尾空镜:月与江面,画面留白最大 | 无人物;与 K1 保持"同景别但不同构图" | 与 K1 相似度过高,观众以为画面卡住了 |
细节二:冻结一套"基线参数"。小月在第一帧开工前就写死了一组参数,之后所有镜头、所有轮次都不许动,除非做对照实验:模型档位固定(同一个平台、同一个模型版本)、分辨率固定(16:9 定稿尺寸)、引导强度固定在甜点区(先在 4–7 区间内试两个值,选定一个)、每帧生成 4 张。她的理由很"工程":如果每张图都换参数,你永远不知道"前后不像"是参数的错还是模型的锅——这正是 2.7 节"一次只改一个变量"的纪律在真实项目里的样子。
下面两张提示词卡是小月实际使用的版本,你可以直接抄进自己的作业,只改括号里的占位符。注意第一张卡里关于负向提示词的自注——它是本章 2.13 节的一个伏笔。
生成回来之后是"筛选与修正"。小月给自己定了一条硬规矩:任何一张图进候选之前,必须过"质检四看"——看手(手指数量、指节、手与物体的边界)、看字(画面里有没有乱码文字)、看光影(光从哪来、有没有两套光)、看脸(五官比例、跨帧是不是同一个人)。这套"四看"不是她发明的,它是 2025–2026 年中国多起摄影赛事识破 AI 作品时实际使用的线索清单(见 2.15 节)。
修不满意的图,按代价从低到高走三步:①局部重绘(只改坏掉的那一块);②图生图(挂上原图、把重绘幅度调到 0.3–0.4,保留构图换质感);③重新生成(当问题属于"全局关系错误"时,局部窗口装不下它)。最后一类问题长什么样?典型例子是"手与手臂接不上"——它是全局的透视问题,框多大都修不回来,必须重掷。下面是她的修正提示词卡。
背景:小月要在一次课后练习(1 学时)加一个晚上,完成 6 张关键帧。她的原始想法是"一张一张做,做到满意为止"。小舟提醒她:这样做的结果几乎可以预见——三张之后,色调开始漂,人物开始变脸,时间全耗在返工上。
做法:改为"先立规矩,再开工"。① 用一次生成产出角色参考表(案例 2-A 的成果);② 按表 2-18 把 6 帧逐一写成画面任务表,特别是写死"判定标准";③ 冻结基线参数(同一平台同一模型档位、16:9、固定的引导强度、每帧 4 张);④ 一晚跑完全部 6 帧,共 24 张;⑤ 用"质检四看"筛掉 3 张明显不合格的(一张指节异常、一张有乱码文字、一张与 K1 构图撞车),对其中 2 张做局部重绘、1 张改图生图微调;⑥ 6 张定稿连同提示词、参数、种子一起归档。
结果:六张图第一次成为一个"组"——色调一致、人物是同一个人。最让她意外的是第 ④ 步:批量生成反而比"一张一张精雕"更快,因为筛选发生在生成之后,比较发生在同一批的同一次分布里,直觉判断也更准。
复盘:①"先定角色,再定画面"的顺序不能反——小月第一版绕过了参考表,结果 K2 和 K5 是两个人;②基线参数的意义是把"风格漂移"这项风险从流程里拿掉;③参考表里的人物是正面站姿,而 K2 需要侧身——参考图解决"长得像",姿态交给提示词或姿态控制,两者分工不要混淆;④K5 的人影太小,后来干脆去掉了五官细节,只保留轮廓——这是"以退为进"的取舍,值得写进复盘。
外部案例:2025–2026 年,工业界在做什么
课堂作业和真实产业的距离,比你想的要近。下面三条事实放在一起看,能拼出一张相当清晰的产业图景:
- 它已经在生产线上。2026 年超级碗出现了首个 AI 生成广告(ComfyUI 生态案例);"ComfyUI artist" 甚至已经成为一个招聘职位名。同年 8 月 17 日,美国电影协会(MPA)与字节跳动就 Seedream、Seedance 等模型的知识产权保护达成合作并签署谅解备忘录——版权方与生成模型方开始坐下来谈规则了。
- 它摔的跟头和你摔的是同一个。2025 年,荷兰麦当劳的 AI 圣诞广告因人物肢体扭曲被下架。注意这句:不是"风格不对",也不是"不好看",而是肢体扭曲——和你在作业里遇到的"六指""手与手臂接不上"是同一类失败。动态场景(第 3 章的内容)放大了这个问题:静止的一帧里能糊过去的错误,动起来就藏不住了。
- 合规正在被写进产业合作。MPA 与字节的谅解备忘录、日本 17 家出版机构针对 Sora 2 的联合声明(2.15 节详述),都说明"素材从哪来、生成物怎么标"已经不是一个可选项。
这三条事实给课堂的启示是:你们在课上练的"画面任务表、质检四看、归档参数",正是产业界交付流程的缩小版。区别只在于规模——而方法的形状是一样的。
2.13失败案例诊所:症状、成因与处方
生成式图像创作有一个残酷的真相:你花在"修"上的时间,往往会超过花在"生"上的时间。因此,一个成熟的创作者与一个新手最大的区别,不在于会不会写提示词,而在于能不能一眼看出问题出在哪一层——是数据层的先天不足?是参数的锅?还是你在要求一件模型做不到的事?
本节开出一间"诊所":先给一张失败模式的解剖图与一张总表,再对五个最常见的失败模式逐一给出症状、成因与处方。
| 症状 | 成因(分层) | 处方 |
|---|---|---|
| 多余手指 / 六指 | 数据层:手在训练图里面积小、模糊、常被遮挡;统计层:学的是"4–6 根类似线条"而非"五根"的硬规则,遮挡样本把物体边缘误学为手指;生成机制:局部拼接、无回溯修正,错了只会被强化;噪声:手掌边缘被误判为手指起点 | 负向提示词只能缓解;局部重绘必须改变模型可见信息(蒙版完整覆盖问题手指 + 提示词写清数量与朝向);注入姿态约束;长期方案是换对手部学习更充分的新模型;高清化会放大问题 |
| 肢体 / 关节异常 | 姿态空间巨大(单手就有 21 个关键点)+强自遮挡+模型没有解剖学硬约束 | 重新生成而非局部重绘;降低手部动作难度(自然下垂、插兜优于比心、握笔、捧杯) |
| 手与物体粘连 | 边界信息完全缺失,手与杯子/头发/袖口糊成一团 | 顺序铁律:先清场,再重画——把粘连团连同所粘之物一起消除,得到干净画布再重绘;预防性做法是先生成空手图再单独合成物体 |
| 手部透视错误 | 手与手臂无法连接、掌心方向与手臂相悖——全局关系错误,局部窗口装不下 | 重新生成;或用"换手法":从同批生成中取一只正确的手,抠图、对齐透视与光照方向、贴回,再用 AI 修图收缝 |
| 单个别扭的指关节 | 数量与透视都对,只是关节形态不自然 | 用液化工具推一下(几秒钟、不引入新随机性),而不是局部重绘——每次重绘都是全新采样,可能"修好一处又坏了另一处" |
| 文字崩坏 / 乱码 | 早期模型缺少字形级监督;分辨率不足;复杂排版与长文本的逻辑一致性差 | 换中文优化模型(Qwen-Image 系、Seedream、GLM-Image、Kolors);提高分辨率;减少单图文字密度;大段文字交后期排版兜底;定稿前逐字核对 |
| 光影不一致 / 过曝 | CFG 过高导致饱和度与微对比急升、高光溢出、阴影过重;扩图/生成填充引入的新区域与原图光照不匹配 | 降低 CFG(负向提示词只能缓冲,不能替代);CFG-rescale(φ=0.5–0.7)、APG、dynamic thresholding,或把引导限制在中间区间;扩图后逐项检查边缘、光影 |
| 风格漂移 | 风格描述过粗时模型"按自己的文艺感填空";跨模型/跨版本切换;参考图带杂物;模型大版本更新让风格词稳定性重新洗牌 | 用标准化程度更高的英文风格词;冻结基线参数;清理参考图;版本更新后重新拉基线 |
| 双胞胎脸 / 角色混乱 | 多主体时模型按"平均脸"采样;提示词没给每个角色独立的可区分特征 | 用参考图/主体参考为每个角色锁定身份;多参考图分工;为每个角色写独立特征 |
| 低 CFG 的漂移与数量错误 | CFG 过低时模型优先依赖先验而非提示词 | 适度提高 CFG,或改用结构化控制(参考图/姿态/边缘) |
| 非方形画幅的元素重复 | 扩散模型训练分辨率较单一,生成 16:9 等非方形画幅时容易重复元素 | 优先选模型预设支持的宽高比;或使用对非方形优化过的模型 |
| "一眼假" | 服饰上的乱码文字、手部/动作异常、人脸比例不符 | 这三类特征也是当下最实用的鉴定线索——把它当课堂"找茬"练习,也把它当自己的发布前自查表 |
五个真实病例
症状:小月生成的 K2 里,诗人垂在身侧的手有六根手指,其中两根从同一指根分叉出来。她挂了蒙版重绘——第一次修好了分叉,又冒出一根;第二次数量对了,指节却像被拧过;第三次整只手糊掉了。
成因:回到图 2-17 的四层链路看:模型学到的不是"手必须有五根手指"的硬规则,而是"手的图像通常包含 4–6 根类似线条的结构";而局部重绘在局部同样是重新加噪再独立采样——所以"修好一处、坏了另一处"不是运气差,是机制使然。此外她犯了一个经典错误:把局部重绘当成"纠正数量"的工具,而没有改变模型可见的信息。
处方:①重绘时让蒙版完整覆盖问题手指与粘连边界,并把"数量与朝向"写进局部提示词("五根手指清晰可数,拇指与其余四指分开,手背朝向镜头");②两次重绘仍不对,立刻停止重绘——这是一条止损纪律;③改用"重新生成"或"换手法";④预防层面:把动作改成"自然下垂"甚至"插兜"(不露手指就没有计数问题,社区里把它戏称为小作弊);⑤长期看,换一个对手部学习更充分的模型,比任何技巧都有效。记住:高清化只会让这只手更清楚地告诉你它有六根手指。
症状:小舟做课程海报,想让模型直接把标题"春江花月夜"写进画面。第一版把"夜"字渲染成了不存在的字;第二版五个字全对,但角落的活动说明小字乱码成一片;第三版她把 12 条活动信息全塞进图里——结果连最好用的模型也没顶住:一张"AI 模型入门指南"风格的网格卡片里出现了 5 处文字错误。
成因:文字崩坏属于"分辨率 + 监督 + 排版复杂度"的复合问题:早期模型缺少字形级监督;分辨率不足时小字必然糊;而高密度信息图与长文本的逻辑一致性,即使用 2026 年最好的模型也仍是主要失分点——这不是她的使用方法错了,是她给模型派了一个尚未成熟的活。
处方:①换中文优化模型(Qwen-Image 系、Seedream、GLM-Image、Kolors 等,中文汉字渲染是它们的专门优势);②提高分辨率,并减少单图文字密度——标题类大字可以生成,成段小字不要交给模型;③大段文字一律后期排版兜底;④定稿前把图放大到 1:1 逐字核对。一句话的操作标准:图里的字要"少而准",多而不准等于没写。
症状:小月为了"更贴提示词",把引导强度从甜点区拉到 14。生成的月亮确实更圆更亮,但整张图饱和度与微对比急升、高光溢出成一团白斑、人物皮肤出现塑料感、江面边缘生硬——六张里有三张因此报废。
成因:典型的"CFG 过高"事故。引导强度不是质量旋钮而是权衡旋钮:它把"有条件"与"无条件"两次预测的差值放大,放大提示词影响的同时,也放大了这些副作用;到 12 以上结构开始崩坏,21 以上通常直接崩。她试图用负向提示词写"不要过饱和"来补救——事实是负向提示只能缓冲,不能替代降低 CFG。
处方:①把引导强度退回模型甜点区(对照表 2-4 的参考区间,但以你自己实测为准);②若需要更精细的控制,使用 CFG-rescale(φ=0.5–0.7)、APG、dynamic thresholding,或把引导限制在中间采样区间(如 guidance_interval=[0.2,0.8]);③扩图或用生成式填充后,必须逐项检查新区域的边缘、光影与原图是否接得上;④把"每次只改一个参数"写进实验纪律——她这次是全组六张一起改的,代价自然也是六倍。
症状:小月第一版六张关键帧,前三张是清冷青蓝,第四张开始偏暖、颗粒变粗,第六张干脆成了另一种画风。她的提示词里风格部分只写了"中国风,唯美"。
成因:三层叠加。第一,风格描述过粗——"中国风,唯美"这样的词留白太大,模型会"按自己的文艺感填空",而每次填空的答案不同;第二,她中途换过一次工具做对照,跨模型切换会让风格词重新洗牌;第三,参考图里带了原图背景的杂物,模型把杂物也当成了风格线索。此外还有一条客观规律:模型的一次大版本更新,会让所有风格词的稳定性重新拉基线。
处方:①用标准化程度更高、颗粒度更细的英文风格词(详见 2.10 节中英对照);②冻结基线参数,对照实验单独开一组、不混进正式批次;③参考图清理杂物,必要时先抠图再挂;④把"版本变更后重拉基线"写成项目规范。这条处方背后还有一条产业级的思路值得记住:Seedream 4.0 用统一架构承载生成与编辑,官方给出的理由之一正是"避免多模型切换导致的风格漂移"——工具选型本身就是在预防风格问题。
症状:小组想做一张"江边对饮"的合影:诗人与友人对坐。生成的结果里,两个人像同一个人的不同发型;换了三版,每一版都是两张"平均脸"。
成因:多主体时模型倾向于对每个角色采样一张"平均脸",而提示词里除了"友人穿深色衣服"之外,没有任何可区分的身份信息——模型无从区分"谁是谁",自然长成了双胞胎。这个现象的现实版本相当有名:2026 年呼和浩特摄影赛一件 AI 作品被识破的证据之一,就是"图中的环卫工面容高度相似"。
处方:①为每个角色准备各自的参考图或主体参考(多参考图分工),把身份锁定从"描述"升级为"给定";②为每个角色写独立可区分特征(脸型、发式、关键配饰),而不是只写服装颜色;③若工具支持多角色参考,一图一角色、编号对应;④出图后用"四看"里的"看脸"逐人核对。多人场景的一致性,本质上是"给每个角色提供独立身份来源"的工程问题。
两条止损纪律:什么时候承认"就这样吧"
失败诊所的最后,是两条比任何技巧都重要的纪律——它们是第 1 章"一次只改一个变量"在图像领域的延伸:
- 重掷不会因为"再试几次"而变容易。不改动模型可见信息的重掷,本质上就是独立采样——五次失败不代表第六次更接近成功。所以止损线应当按成本来设,而不是按胜率来设:先估算"手工修复这张图需要多久",再和"已经花在重掷上的时间"比较;当两者接近时,继续重掷就是负收益。这条纪律的价值在于,它把"不甘心"这个情绪变量,换成了一个可以做算术的决策变量。
- 每轮只改一个变量,且通过标准写在开始之前。提示词、手部动作、构图、参考图——一轮只动一个,否则无法归因。做 A/B 实验时,通过标准要在开始前就写死(例如在 1:1 像素视图下:手指可数、指节数量正常、掌心朝向与手臂一致),每组跑两遍、中间留出间隔,以判断差异是"变量造成的"还是采样噪声造成的。
还有一句必须坦率的话,请所有同学记在实验记录的第一页:本节与表 2-19 给出的所有"处方",都是方法,不是数字承诺。结论会随模型版本更新而失效——这就是本书不提供任何"通过率表格"的理由。你要带走的是判断问题的框架,而不是一张会过期的成绩单。
2.14动手实践:从文生图到关键帧的四个阶段
本节把全章内容落到手上。练习按四阶段递进:文生图 → 图生图 → 局部重绘 → 条件控制,中间插入两组参数对照实验(一次只改一个变量:引导强度、采样步数、种子),最后以主线任务收束。所有练习都要求同一个动作:记录——提示词、参数、模型版本、日期、结论。
🛠 实践一:文生图起步——同一提示词的三次采样(30 分钟 · 课堂)
选一个国内网页工具并固定下来(即梦、豆包、通义万相等,选能登录、能保存历史记录的那个)。用一条四要素提示词描述"月色下的江面",参数全部保持默认,连续生成 3 次。
观察并回答:三次结果像不像?哪里像、哪里不像?"月亮的位置""水面的反光""雾气的形状"分别变了吗?
提交物:3 张图 + 一段 80 字以内的观察记录。这段记录的结论应该是:同提示词、同参数下,每次生成仍是一次独立采样——差异是机制的一部分,不是操作失误。
给这条提示词加一个约束(例如"画面留白占三分之二"),再生成 3 次。观察:约束是否每次都生效?约束越多,三次结果的差异是变大了还是变小了?把答案写进记录——它是第 2.7 节"提示词越具体、约束越强,但冲突指令会互相抵消"的现场版本。
🛠 实践二:参数对照实验 A——引导强度(40 分钟 · 课堂)
固定同一个提示词(建议用《春江花月夜》画面),其他一切不变,只改引导强度,按下表跑三组,每组生成 2 张(间隔几分钟再跑第二张,以判断噪声)。
| 实验 | 变量(只改这一个) | 三组取值 | 固定不变项 | 观察点 | 通过标准(开始前写死) |
|---|---|---|---|---|---|
| 实验 A | 引导强度(CFG) | 偏低 ≈3 | 甜点区(先按 4–7 试一个值) | 偏高 ≈12 | 提示词、模型档位、分辨率、采样步数、宽高比、每组的采样次数 | 提示词遵守度、饱和度、高光是否溢出、边缘是否生硬、皮肤质感 | 能同时说清"低档丢掉了什么"与"高档多出了什么副作用";能指出哪一档最接近"提示词遵守度高、色彩光照不戏剧化" |
| 实验 B | 采样步数 | 少步档 | 平台默认 | 约 2× 默认 | 同上(引导强度固定在实验 A 选出的值) | 细节、收敛程度、耗时、成本;若用蒸馏/少步模型,观察"超出蒸馏轨迹"后是否反而变差 | 能给出"边际收益从哪一步开始迅速递减"的实测感受;能复述"步数要与该模型的蒸馏设定匹配" |
| 实验 C | 种子 | 固定种子 | 换种子 | 固定种子 + 只改提示词中的一个词 | 其余全部不动 | 哪些元素被锁住了、哪些仍在变;"固定种子"到底保证到什么程度 | 能实物演示三条边界:换模型/分辨率/采样器后同一颗种子不再复现;改蒙版会改变输出,即使种子固定 |
故意把引导强度拉到 ≥12 生成一张,把它作为反例存档,在图注里写清楚崩坏的方式(结构崩、色带、高光溢出……)。反例存档的价值在于:以后见到类似症状,你能立刻联想到"是不是引导强度过高"。
🛠 实践三:图生图与重绘幅度(30 分钟 · 课堂)
取实践一里你最满意的一张图,做三组图生图,只改重绘幅度:0.25 / 0.5 / 0.8 各一张。
逐张回答:主体身份还在吗?构图还在吗?画风变了多少?把三张按"改动强度"排序,写一行结论:重绘幅度就是"加了多少噪声",幅度越大,原图残留信息越少、模型自由发挥越多。
🛠 实践四:局部重绘——给蒙版立规矩(40 分钟 · 课堂)
- 制造一个问题。用实践一的图,或直接生成一张"人物手持杯子"的画面(注意:这个动作本身容易出问题,正好当教具)。
- 遵守蒙版三条规则重绘。①蒙版比物体边缘略大一圈软边;②把物体造成的后果(阴影、反光)也框进去;③复杂主体分两趟——先修物体、再修阴影。
- 故意违规一次。把蒙版画得紧贴物体再重绘一次,观察"外溢的边"是怎么出现的——对比出真知。
- 验证种子的边界。固定种子,只改动蒙版形状,再生成一次,记录输出是否变化。(预期结论:改蒙版会改变输出,即使种子固定。)
如果你用的是纯提示词式编辑工具(不接受蒙版文件),请完成同一任务并总结:纯提示词式修不好的那一类问题是什么?(提示:需要"重画边界"的那一类。)把结论写进记录,并说明为什么"蒙版式与纯提示词式的失败方式不同"。
🛠 实践五:条件控制——让"必须像什么"说话(30 分钟 · 课堂 + 课后)
找一张构图清楚的参考图(风景或人物均可),用工具内的边缘控制或姿态控制复现其构图,生成 2 张,然后只改控制权重(例如 0.4 与 0.8)再来一轮。
回答三个问题:①权重 0.8 时,新图与参考图"像"在哪里?②权重 0.4 时,模型自由发挥在哪些部分?③"权重越大越好"这句话错在哪?
组合使用两种控制(参考图锁角色 + 姿态锁动作),生成一张"指定的动作 + 指定的人"。如果两次都失败,按 2.13 节的止损纪律记录:你花了多少时间、手工修复的预估耗时是多少、你决定继续还是止损——把决策过程本身写成记录。
🛠 实践六:主线推进——角色设定图与关键帧(60 分钟 · 课堂 + 课后)
- 定角色。按案例 2-A 的方法产出一张"角色设定图"(正面、全身或头肩、均匀布光、中性灰底),不满意就迭代,定稿后不再改动。
- 写任务表。按表 2-18 的格式,为 4–6 个镜头各写一行:画面意象、景别、生成要点、一致性与控制、主要风险——判定标准必须在生成前写死。
- 冻结基线参数。同一平台、同一模型档位、同一分辨率(16:9)、固定引导强度、每帧 4 张。写进记录表。
- 批量生成与筛选。一晚跑完全部镜头,用"质检四看"(手 / 字 / 光影 / 脸)筛出定稿,问题图按"局部重绘 → 图生图 → 重新生成"的代价顺序处理。
- 归档。提示词、参数、种子、模型版本、日期、一句复盘,缺一不可——第 1 章的"创作档案"在这里迎来第一次大考。这些素材将在第 3 章作为视频生成的首帧直接复用。
所有实验共用一个记录表模板。请把它复制到你的创作档案里,每个实验一行,并强制填写"模型版本 + 日期"——原因已经说过:结论会随版本失效,没有版本号的结论等于没有结论。
| 实验编号 | 变量(只改这一个) | 取值 | 固定不变项 | 观察点 | 结论(附模型版本 + 日期) |
|---|---|---|---|---|---|
| 例:E-01 | 引导强度 | 3 / 5 / 12 | 提示词 · 模型 · 分辨率 · 步数 | 遵守度 / 饱和度 / 高光 / 边缘 | 例:本模型甜点区在 5 附近;12 时高光溢出、结构开始崩(模型 vX,2026-10-09) |
| E-02 | — | — | — | — | 填写你的结论 |
| E-03 | — | — | — | — | 填写你的结论 |
| E-04 | 重绘幅度 | 0.25 / 0.5 / 0.8 | 原图 · 提示词 · 模型 | 身份保持 / 构图保持 / 画风变化 | 填写你的结论 |
| E-05 | 控制权重 | 0.4 / 0.8 | 参考图 · 提示词 · 模型 | 结构相似度 / 风格自由度 | 填写你的结论 |
2.15课程思政:用图像讲中国故事,也守好取材的边界
本章的思政主题有两半,一半是创作的抱负——中国的创作者应该用这门新技术讲什么;另一半是创作的底线——素材从哪来、作品怎么标、别人的东西能不能用。两半合成一句话就是:技术可以全球采购,母题必须自己说话;自由不是无边界的,边界正是专业性的组成部分。
为什么《春江花月夜》是一个好选择
先回到贯穿案例。小组选择用张若虚的《春江花月夜》做两分钟短片——这不是"因为古诗简单",恰恰相反,它是"用最前沿的工具,做最中国的表达"的一次练习,而且它有两层现实红利。
第一层是技术红利。你可能已经注意到 2.10 节里的一条规律:文化语境用母语最稳——春节场景用中文提示词最好(红梅、窗花、金箔保持完整),中秋场景用中文能保持月饼与茶席的构图。原因很简单:模型在训练数据里见过大量真实的中文文化场景,当你的母题与训练数据里的真实存在重合时,"创造"就变成了"唤起",难度大幅下降。中国古典意象(江、月、花林、孤舟、楼台)正是中文优化模型的优势区。
第二层是责任红利——这个词是本书的私货,但值得解释。当全世界的创作者都在用几秒钟生成"一个差不多的古风画面"时,真正的稀缺品不是画面,而是准确的画面:楼的形制对不对?袖口的形制是哪个朝代的?"秉烛游"该用烛还是灯?这些细节无法靠"泛东方审美"蒙混,只能靠查证。谁愿意查证,谁的作品就有别人模仿不了的可信度。技术让"生成"变得廉价,恰恰让"考据"变得昂贵。
反过来,不做考据的代价也实实在在地摆在眼前。本书编写时检索到的两条事实值得所有同学记住:其一,模型对文化符号存在"按训练数据里的刻板印象填空"的倾向——中文"复古"指向 1980–90 年代港风,翻译成英文后"vintage"却指向 1950–70 年代美式;春节意象翻译成英文会漂向"泛亚洲节庆",中秋意象会漂向日本茶道。其二,这种漂移不是抽象的理论:2025 年"岭南杯"全国古树名木摄影大赛的核查中,一件标注为海南的获奖作品,实际上是印度尼西亚松巴岛的树木图片——"用错地方"在专业赛事里是会被撤销奖项的硬伤。
第一层:给意象配"考据"。中国古典意象(月、江、花、舟、楼台、衣冠)在提示词里只是一个词,在成片里却是一整套形制。做法是把"考据"变成流程的一步:每张关键帧旁边附一行"形制说明"——画的是哪个时代的楼、什么形制的衣冠、依据哪些图片资料。本节主线案例的 K4"楼台"就是这么做的:小舟花了一个小时查唐宋楼阁的图片资料,再照着写提示词。用参考资料与参考图锁定形制,是防止"泛东方拼贴"最有效的手段。
第二层:不越"I 化的熟悉感"。有些画面"看起来很中国",其实是别的文化:灯笼堆叠、红金配色、飞檐乱贴——这不是中国,这是训练数据对"东方"的平均印象。判断标准很简单:能不能说出每个元素"是什么、出自哪、为什么在这里"。说不出的,删掉。用刻板印象省下的时间,最后都会在观众的质疑里还回去。
第三层:请"懂的人"审看。涉及文化细节的作品,定稿前请一位相关专业的同学或老师过目:形制、仪轨、称呼、器物。这一条听起来像常识,但它和"写完代码请人 review"是同一种职业习惯——评审不是不自信,是专业流程的一部分。
合法取材:四个判例划出的边界
接下来是本章思政的另一半,也是数字媒体创作者最容易踩坑的地方:素材与生成物的权利边界。中国的法院已经用一组判决把边界画得相当清楚——下面这四个案子,建议逐条读完,因为它们直接决定了你的"创作档案"该怎么建。
| 案件 | 法院与时间 | 要点 | 对作业的启示 |
|---|---|---|---|
| 李某诉刘某案("春风案",媒体称 AI 文生图著作权第一案) | 北京互联网法院 2023 年 11 月一审,2024 年 1 月报道已生效(双方均未上诉) | 李某用 Stable Diffusion,通过输入提示词、设置迭代步数、图片高度、提示词引导系数、随机种子等参数生成人像图并发布;刘某在配图中使用并截去署名水印。法院认定李某"从构思到最终选定图片进行了智力投入",涉案图片具备"智力成果"与"独创性"要件、属于美术作品;李某是作者;著作权法规定的作者限于自然人、法人或非法人组织,AI 模型本身不能成为作者。判赔经济损失 500 元并赔礼道歉,同时强调需个案判断 | 保留参数记录 = 保留作者身份的证据。你写进创作档案里的步数、引导强度、种子,正是本案中法院采信的关键事实 |
| 周某诉某科技公司案 | 北京互联网法院 | 周某主张其 AI 生成的"某猫"图片被某公司用于推广,法院驳回其主张;重要理由之一是"周某并未提交涉案图片在 AI 软件中的创作过程记录",证据无法证明独创性,涉案图片不构成"作品" | 与李某案的分野就在证据:有没有创作过程记录、能否体现个性化表达与智力投入。这就是本书从第 1 章起强制要求"创作档案"的法律原因 |
| 奥特曼案 | 广州互联网法院 2024 年 2 月判决 | 被描述为"中国法院作出全球首例生成式 AI 服务侵犯著作权的生效判决"。被告 AIGC 平台可由简单关键词生成奥特曼图片;法院认定构成复制权与改编权侵权、平台未尽合理注意义务;判赔金额不高,判决指出行业"正处于发展的初期,需要同时兼顾权利保障和产业发展" | 不要生成现有的知名 IP 形象(动漫角色、品牌形象、明星面容)。"输入几个关键词就能出图"的便利,不改变形象本身的权利归属 |
| 北京通州法院案 | 2025 年 6 月 13 日判决 | 涉及利用 AI 技术侵犯著作权;与奥特曼案一样触及"AI 辅助二创是否产生新作品"的问题 | 二创不是免罪牌:在他人作品之上"再创作",仍要先过权利关 |
把四个案子压成一句操作口令:输入要干净,中间要留痕,输出要标识。"输入要干净"指不喂他人受保护的作品当作风格复制材料、不生成现有 IP 形象;"中间要留痕"指创作过程记录(提示词、参数、过程截图、日期);"输出要标识"指 AI 生成物的显式与隐式标识。第三条不是可选项,它是两套正在强制执行的法律体系的要求。
关于"风格模仿",还要补一条 2025 年的产业风波。当年 OpenAI 的图像生成能力可以"只需一句话和几秒钟就生成宫崎骏动画",引发吉卜力工作室等日本 IP 出版公司抗议;吉卜力等公司通过日本内容产品海外流通促进机构(CODA)向 OpenAI 致函,要求停止未经授权使用相关内容训练 AI 模型,并指其 Sora 2 已生成大量与日本现有内容产品相同或高度相似的影像。日本方面随后形成合力:包含小学馆在内的 17 家出版机构以及日本动画协会、日本漫画家协会于 10 月 31 日联合发表声明;10 月 10 日,时任日本知识产权担当大臣城内实表示日本政府已要求 OpenAI 不得实施侵犯著作权的行为。OpenAI 提出的"选择退出"(权利人须主动声明"不得使用")机制,被 CODA 明确反对——它与日本著作权制度"使用著作物原则上须事前许可"存在根本冲突。这场风波的核心问题正是:"模仿一种画风"算不算越界?目前仍在全球范围内争论,尚无统一答案。对课堂的启示不是站队,而是谨慎:把"模仿某位在世艺术家/某个工作室的独有风格"从作业要求里划掉,改成"概括其特征的通用风格词"(例如"水彩质感、柔和边缘、低饱和"),既安全,也更专业。
发布前的合规检查:把法规变成操作
法规条文读起来遥远,但落到操作上只有几条。先看现行要求:中国的《人工智能生成合成内容标识办法》(网信办、工信部、公安部、广电总局联合发布)自 2025 年 9 月 1 日起施行,配套的强制性国家标准 GB 45438—2025 同日实施;欧盟《人工智能法案》第 50 条的透明度义务则于 2026 年 8 月 2 日正式生效并可在全欧盟/EEA 执行。两边的要求用一张表对照如下。
| 检查项 | 具体要求(要点) | 你的操作 |
|---|---|---|
| ① 显式标识(中国) | 图片等生成合成内容,服务提供者应添加显式标识:在图片适当位置以文字/图形呈现、可被用户明显感知;提供下载、复制、导出时须确保文件含满足要求的显式标识。国标规定:采用文字提示、位于图片的边或角、字型清晰可辨、文字高度不应低于画面最短边长度的 5%,并应同时包含"人工智能"或"AI"要素以及"生成"和/或"合成"要素(如"AI 生成") | 课程对外发布的作业一律执行:导出后确认标识存在,且在缩略图尺寸下仍可辨认 |
| ② 隐式标识(中国) | 在文件元数据中添加生成合成内容属性信息、服务提供者名称或编码、内容编号等;数字水印被列为"鼓励"而非强制 | 不要清理工具写入的元数据;转发、压缩、截图前先在档案里留一份原始文件 |
| ③ 不得恶意处理标识 | 任何组织和个人不得恶意删除、篡改、伪造、隐匿标识;传播平台对未标识但检测到 AI 痕迹的内容需添加风险提示 | 把"保留标识"写进自己的发布流程——李某案中被截去的正是署名水印,那已构成侵权 |
| ④ 发布场景自查(国际对照) | 欧盟第 50 条:提供者须确保合成图像输出以机器可读格式标记并保持可检测,标识应有效、可靠、稳健、可互操作,技术措施应在设计和开发阶段内嵌;部署者发布深度伪造,或可能被误认为真实、涉及真实人物/地点/事件的 AI 生成图像,必须以清晰可见方式披露 AI 来源;艺术、创作或讽刺作品可豁免深度伪造标识;C2PA 规范被作为过渡参考。罚则最高 1500 万欧元或全球年营业额 3%(取高者);2026 年 12 月 2 日为已上市生成式 AI 系统机器可读标识的过渡期截止 | 涉及真实人物/地点/事件的图,无论发在哪,都加清晰可见的 AI 披露;不要生成"看起来像真实新闻照片"的画面 |
| ⑤ 素材来源 | 判例层面:李某案采信"智力投入",周某案因缺少创作过程记录败诉;奥特曼案确认生成他人 IP 形象构成侵权 | 每个素材一行来源记录(URL、授权方式、日期);生成记录(提示词、参数、种子、模型版本、日期)随成品归档 |
| ⑥ 真人权利 | 涉及真人肖像、面容的生成与合成是高风险区 | 不生成可识别的真实人物(除非本人授权且用途明确);不使用同学生成他人"图生图"肖像 |
| ⑦ 文化准确性 | 文化符号误用与刻板印象既是伦理问题,也是作品质量问题 | 按"三层操作"执行:形制说明、拒绝泛东方拼贴、请懂的人审看 |
最后,把这套检查放在一个真实的场景里检验。2025–2026 年中国多起摄影赛事撤销 AI 作品奖项的事件(呼和浩特全民摄影双月赛《洒乐园林》2026 年 7 月 14 日被通报"确系 AI 生成"、取消资格并暂停赛事整改;《大众摄影》"五腿牛"照片 2026 年 7 月 17 日撤下,杂志随后修改征稿规则,要求 AI 生成影像主动声明并明显展示 AI 标识,且不接受纯粹文生图影像;"岭南杯"撤销二等奖并永久取消参赛资格;南丰摄影赛取消获奖资格且空缺奖项不再递补)——这些事件的共同点不是"AI 被讨厌",而是隐瞒被讨厌:赛事处罚的是"不声明、伪造拍摄信息、伪造地点",而不是"使用了 AI"。把 AI 标识亮出来,你不仅不违规,还比多数人更专业。这也正是本书要求"作品内可见标识 + 档案留痕"双轨并存的原因。
把这一章压缩成七句话
- 从 GAN 到扩散:GAN 靠"生成器对抗判别器"博弈,训练不稳、易模式崩溃;扩散把"生成"拆成"逐步去噪"——正向过程按固定规则加噪、反向过程由网络一步步减噪,训练 = 学会去噪,生成 = 从噪声逐步雕刻。
- 潜空间:扩散不直接在像素上工作,而在 VAE 压缩后的潜空间里工作;8× 空间压缩带来约 64 倍的算力节省,代价是有损压缩会留下痕迹。
- 架构演进:U-Net 的跳连 → DiT 把潜变量当成视觉 token(AdaLN 注入条件)→ MM-DiT 的文本/图像双流双向注意力;2026 年又出现单流、混合堆叠、MoE 等分支——架构之争并未结束。
- 文本条件与 CFG:引导强度是权衡旋钮,不是质量旋钮;负向提示词只是"无条件分支"的替代品,能缓冲、不能替代降低 CFG;甜点区随模型不同(记得查官方推荐或自行实测)。
- 流匹配 / 整流流:把"噪声到图像"的路径拉直,2024 年后成为主流;但要说清"框架"与"实现"两个层次,"扩散被淘汰"的说法并不准确。
- 参数与编辑:一次只改一个变量;图生图用重绘幅度控制"改多少",局部重绘用蒙版获得"重画边界"的机会,条件控制用结构图约束"必须像什么",角色一致性走参考图/LoRA/提示词块三条路。
- 失败与合规:失败可沿"症状 → 四层成因 → 三层处方"归因,止损线按成本设而不是按胜率设;技术可以全球采购,母题必须自己说话——输入要干净、中间要留痕、输出要标识,创作档案既是经验的沉淀,也是法律的证据。
自测
自测 1:用"训练 = 学会去噪,生成 = 从噪声逐步雕刻"解释扩散模型的原理。为什么说"生成不是一次画出来的"?
答案:训练阶段做两件事:把一张训练图按固定规则逐步加噪(正向过程),让网络反复做"看这张带噪的图、报出里面加了什么噪声"的练习;练到最后网络成为一个"噪声侦探"。生成阶段则把这个本领反着用:从一张纯噪声图开始,让网络预测其中的噪声、减掉一部分,再预测、再减——重复几十步,噪声一点点褪去,图像一点点显形,就像从石头里"雕刻"出来。之所以说"不是一次画出来的",是因为每一步的输入都是上一步的输出,模型并不持有整幅画的全局蓝图,它每一步只负责"这一步该少掉哪一部分噪声"。这个机制解释了本章的许多现象:为什么步数是"循环次数"而不是"精度档位"(2.7 节)、为什么局部重绘会"修好一处坏了另一处"(2.13 节 F2-1)、为什么少步蒸馏模型跑超出设定的步数反而变差(超出蒸馏轨迹)。
自测 2:扩散为什么要在潜空间里做?"8× 压缩带来约 64 倍算力节省"是怎么来的?有损压缩会带来什么后果?
答案:在像素上直接做扩散太贵:一张 1024×1024 的 RGB 图约有 314 万个数字,每一步去噪都要让网络处理这么多数字,还要重复几十步。潜空间的做法是先训练一个 VAE:编码器把图像压成小得多的"潜变量"(空间上约 8× 压缩),扩散在潜空间里进行。8× 是长度和宽度各压 8 倍,所以面积(也就是要处理的数值量)压低约 8×8 = 64 倍——这就是"约 64 倍算力节省"的来源。后果有三条:①解码器要负责把潜变量还原成像素,训练得不理想时表现为细节发糊或出现伪影;②压缩是有损的,微小文字、细纹理这类"高频率信息"最容易被压掉,这客观上加重了文字渲染与手指等比细节的难度。③"表示空间"本身还在演化(不同模型的 VAE 通道数、压缩倍率不同),并直接影响一个模型擅长什么——这也解释了为什么"换模型"有时比"调参数"更能解决某类问题。
自测 3:小月为了"更贴提示词",把引导强度从 5 调到 14。请预测会发生什么;如果她再写一句负向提示词"不要过饱和",会有帮助吗?为什么?
答案:CFG 把"有条件预测"与"无条件预测"的差值放大:ε引导后 = ε无条件 + w ·(ε有条件 − ε无条件)。w 调到 14 后,提示词遵守度会更"硬"(细节更贴、线条更锐),但同时副作用全面放大:饱和度与微对比急剧上升、高光溢出、皮肤出现塑料感、边缘生硬;到 12 以上结构开始崩坏,21 以上通常直接崩——她的图很可能出现"过曝的月亮 + 生硬的江面"。负向提示词"不要过饱和"只能算缓冲,不能替代降低 CFG:它的机制是把"无条件分支"替换成"对负面概念的预测",只是间接地往外推一点,而副作用来自引导本身的放大机制。正确处方:把引导强度退回甜点区(不同模型的甜点区不同,参考表 2-4 并自行实测),需要更精细控制时使用 CFG-rescale、APG、dynamic thresholding 或把引导限制在中间区间。
自测 4:小月给一张"六指"的图做局部重绘,两次都是"修好这只手、另一处又坏了"。这是运气问题吗?她应该怎么办?
答案:不是运气,是机制。局部重绘在自己的窗口里同样是"重新加噪 + 独立采样"——每次执行都是一次新的随机过程,所以"修甲坏乙"是常态。更关键的是她犯了方向性错误:局部重绘不是"纠正数量"的工具,它的有效前提是改变模型可见的信息。正确做法:①蒙版完整覆盖问题手指与指间粘连处(比外缘多留一圈软边),并把物体造成的阴影等"后果"也框进去(蒙版三条规则);②局部提示词把数量和朝向写清楚("五根手指清晰可数,拇指与其余四指分开");③两次不成即止损——改走"重新生成"、换手法(从同批生成里取一只正确的手),或从源头预防(动作改为自然下垂/插兜、换对手部训练更充分的模型)。还有一条容易忽视的规则:改蒙版会改变输出,即使种子固定——所以"固定种子"不构成"重绘可复现"的保证。
自测 5:角色一致性有哪三条路径?为什么"使用参考图时,提示词要删掉长相描述"?
答案:三条路径:A 参考图 / 主体参考(零训练、约 30 秒级;各家有参考图数量上限,例如 FLUX.2 最多 10 张、Nano Banana 家族最多 14 张);B LoRA 训练(一致性最高,需 15–30 张素材与一次约 1 小时的训练;工程参数如 rank 16–64、学习率 1e-4 起、500–2000 步;角色参考表必须用均匀无阴影棚光 + 中性灰背景,否则会把阴影"烘焙"成下游模型误认的解剖结构);C 精确提示词块 / 统一角色文件(最轻,适合原创角色)。之所以要删掉长相描述:同时给"参考图"和"文字描述"两条身份信息,等于给模型两个事实来源——两者不一致时它要"折中",结果往往两边都不像;头发、眼镜、脸型应当完全交给参考图,提示词只写"在做什么"(情境、动作、镜头)。正确分工记成一句话:参考图解决"长得像",提示词负责"在做什么"。
自测 6:李某案与周某案的结果为什么不同?这两起判决对"创作档案"提出了什么要求?发布前还必须补上哪两件事?
答案:两案的分野在证据:李某案中,原告能说明自己输入提示词、设置迭代步数、图片高度、提示词引导系数、随机种子并反复调整的过程,法院据此认定"从构思到最终选定图片进行了智力投入",涉案图片具备独创性、属于美术作品,AI 模型本身不能成为作者但李某是作者;周某案中原告"并未提交涉案图片在 AI 软件中的创作过程记录",无法证明独创性,图片不构成作品,主张被驳回。对创作档案的要求:提示词、参数(含种子)、过程截图、模型版本与日期,随成品一起归档——它平时是经验沉淀,争议时是权利证据。发布前必须补的两件事:①标识(显式标识:图片边或角的文字提示,字高不低于画面最短边的 5%,含"AI 生成"要素;隐式标识:保留生成工具写入的元数据,不得恶意删除、篡改、伪造、隐匿);②素材与真人核对(不生成本就存在的 IP 形象与可识别的真人;每个素材有来源行)。把这套动作记成十二个字:输入要干净,中间要留痕,输出要标识。
拓展阅读
- ControlNet 原始论文《Adding Conditional Control to Text-to-Image Diffusion Models》(Lvmin Zhang 等,arXiv 2302.05543,获 ICCV 2023 Marr Prize 最佳论文奖)——读它的第 1 节与消融实验即可,重点理解"为什么要在文本之外再加一条结构通道"。
- 各家官方文档(优先级高于任何第三方教程):火山引擎/即梦的模型文档、阿里云百炼的通义万相与 Qwen-Image 文档、Black Forest Labs 的 FLUX 模型卡与许可说明、Midjourney 官方文档页——参数推荐值与商用条款的权威来源,且它告诉你"这一版和上一版哪里变了"。
- 《人工智能生成合成内容标识办法》全文与 GB 45438—2025——建议在第一次对外发布作品前逐条对照;欧盟《人工智能法案》第 50 条的实施指南(2026 年 7 月 20 日发布)可作为国际对照。
- 北京互联网法院"李某诉刘某案"判决书与相关报道——通读一遍"智力投入"的认定段落,你会对自己的创作档案产生完全不同的重视程度。
- 《春江花月夜》历代评注与一本中国画论(如郭熙《林泉高致》)——技法解决"怎么画",母题解决"画什么";后者才是作品与作品之间真正的分水岭。